
遇见数据集

TonyChen06/AscendingHarmonicReasoningInstruction

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

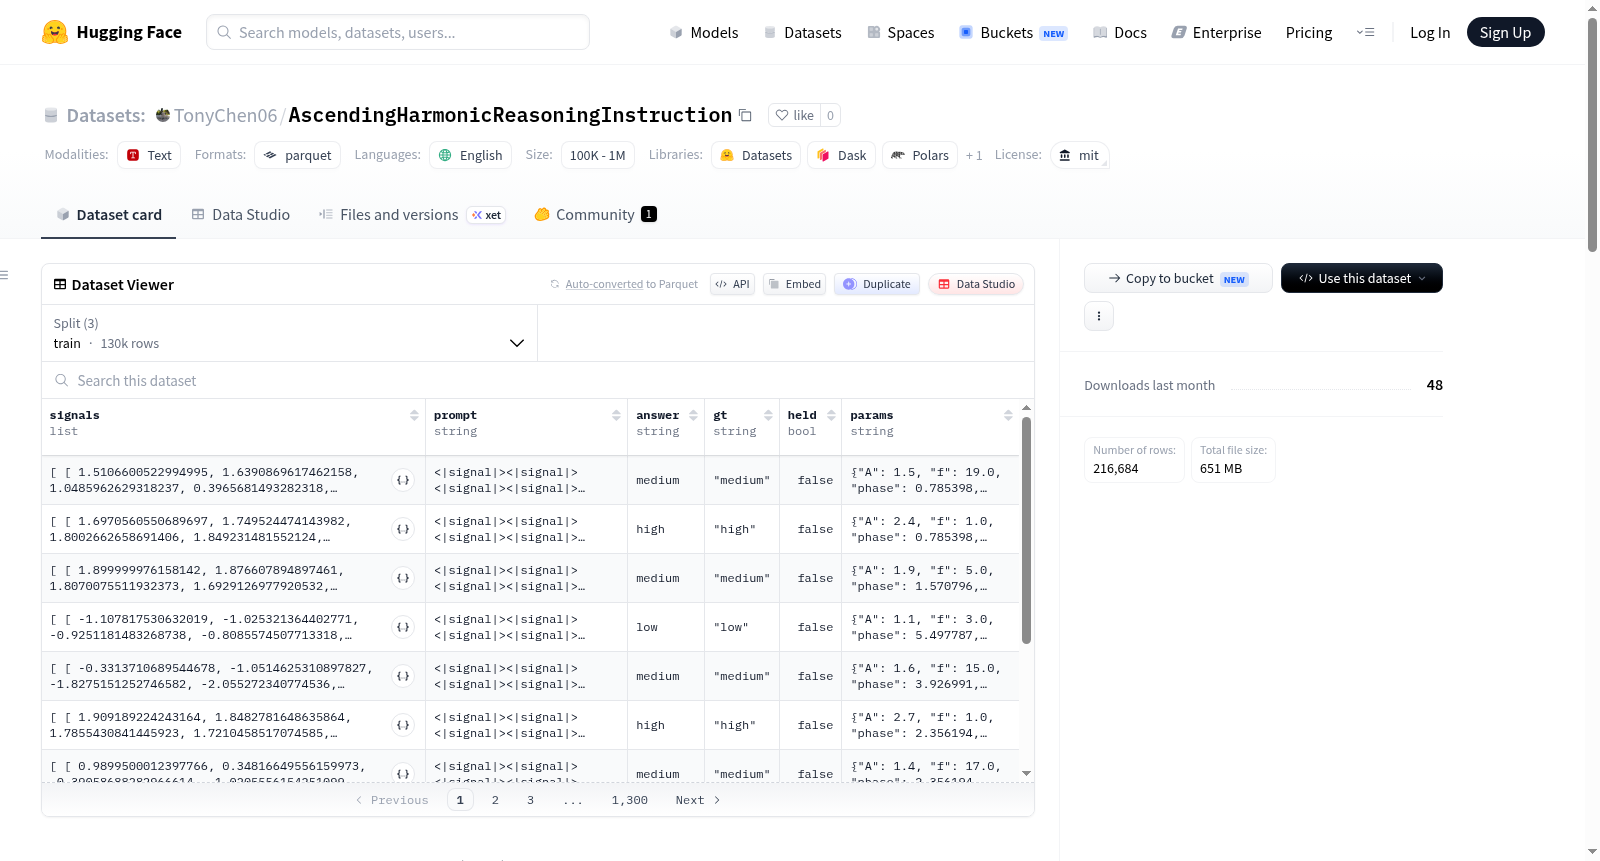
Ahri: Ascending Harmonic Reasoning Instruction (v2.0) 是一个用于时间序列语言模型的受控评估框架。它包含26个合成任务,这些任务分为5个层级,涉及参数信号在离散网格上生成,采样频率为200 Hz,每个信号的数据点数为1024。该数据集旨在通过多任务设置评估模型在时间序列数据上的推理能力,任务类型包括分类、回归、计数、排序和多标签分类等,覆盖从基础信号属性(如振幅、频率)到复杂模式(如异常检测、频谱分析)的多个方面。数据布局包括训练、验证和测试集,并特别标记了保留参数区域,以支持严格的模型评估。

Ahri: Ascending Harmonic Reasoning Instruction (v2.0) is a controlled evaluation framework for Time-Series Language Models. It includes 26 synthetic tasks across 5 tiers, with parametric signals on discrete grids at a sampling frequency of 200 Hz and N=1024 data points. The dataset is designed to assess model reasoning on time-series data through a multi-task setup, covering tasks such as classification, regression, counting, ordering, and multilabel classification, ranging from basic signal properties (e.g., amplitude, frequency) to complex patterns (e.g., anomaly detection, spectral analysis). The data layout includes train, validation, and test splits, with held-out parameter regions marked for rigorous model evaluation.
提供机构:
TonyChen06
搜集汇总
数据集介绍
TonyChen06/AscendingHarmonicReasoningInstruction 数据集图片
构建方式
AscendingHarmonicReasoningInstruction(简称Ahri)是一个面向时间序列语言模型的受控评估框架,其构建方式体现了高度的系统性与层级化设计。该数据集由26个合成任务组成,均匀分布在与时间序列分析核心能力密切相关的5个层级(Tier)中。所有信号均以200 Hz的采样率在离散网格上生成,每个样本序列长度为1024个时间点,从而确保了信号生成的参数化与可重复性。每个任务的数据被严格划分为训练集、验证集和测试集,其中训练与验证集有意排除了对应任务的保留参数区域,而测试集则覆盖完整的参数范围,并借助‘held’标记标识属于保留区域的样本。这种精心设计的划分策略,为评估模型在分布内与分布外场景下的推理能力提供了客观依据。
特点
该数据集的核心特点在于其系统性的层级递进架构与丰富的任务多样性。五个层级从基础感知(如幅度、频率分类)、绝对量值回归,逐步过渡到比较推理、时序动态分析,最终延伸至复杂的频谱分析与异常检测任务。值得注意的是,第5层级包含了回归、频谱分析、事件排序、多标签分类与异常检测等多种输出格式,全面考验模型的综合推理能力。所有任务均以自然语言形式呈现问题,并配有标准化答案格式,消除了传统时间序列评估中因格式不统一带来的偏差。此外,每个任务内部,训练与测试集在参数空间上存在明确的不一致区域,使得Ahri成为评估模型泛化能力与外推边界的理想基准。
使用方法
数据集的使用方法简洁高效,提供了官方Python包支持。用户可通过`AhriParquetDataset`类从HuggingFace Hub直接加载指定任务与划分的数据,例如调用`AhriParquetDataset.from_hub('TonyChen06/AscendingHarmonicReasoningInstruction', task_id='1.2', split='train')`即可获取层级1中的频率分类训练数据。所有数据以高效的Parquet格式存储,便于快速读取与批量处理。配套的OpenTSLM库(位于StanfordBDHG/OpenTSLM)提供了完整的模型、训练器与评估工具链,帮助用户无缝开展时间序列语言模型的训练与基准测试。无论是研究泛化能力,还是对比不同架构的时间序列理解水平,Ahri都提供了一个标准化的受控实验平台。
背景与挑战
背景概述
在时间序列分析领域,语言模型在时序数据上的推理能力评估一直缺乏系统化、标准化的基准。现有基准多集中在真实世界数据集上,难以精确控制任务难度和评估模型在不同推理层级上的表现。由斯坦福大学BDHG团队于2024年发布的AscendingHarmonicReasoningInstruction(Ahri)数据集应运而生,旨在构建一个层次化、可控的评估框架。该数据集包含5个层级的26项合成任务,覆盖分类、回归、计数、排序等多种推理类型,对时序语言模型的细粒度能力评估产生了重要影响。
当前挑战
Ahri数据集面临的核心挑战在于,真实世界的时序信号往往包含噪声、缺失值和复杂混合模式,而合成信号的理想化特征可能无法完全反映实际应用中的困难。构建过程中,需要确保每个层级的任务之间难度递增且无知识泄露,这要求精密的参数分区和信号生成策略。具体而言,如何在保持任务间逻辑连贯性的同时,设计出对模型泛化能力具有真正区分度的保留区域,以及如何避免模型通过记忆简单统计特征而非真实推理来完成任务,是数据集构建中的关键难题。
常用场景
经典使用场景
在时间序列语言模型的研究疆域中,AscendingHarmonicReasoningInstruction(Ahri)数据集宛如一座精心构建的试金石,为评估模型对时序信号的理解与推理能力提供了系统化的标准框架。该数据集囊括了26项经过巧妙设计的合成任务,横跨5个层层递进的难度层级,核心用途在于衡量模型从基础的信号属性分类(如幅度、频率、趋势识别)到复杂的多信号比较与频谱分析之能力。尤为关键的是,其内置的held-out参数区域检验机制,可精准诊断模型是否真正习得了可泛化的物理推理规律,而非简单的模式记忆,使之成为剖析大型语言模型在时序领域基础推理能力不可或缺的评测基准。
实际应用
在实际应用层面,Ahri数据集及其评测思想正逐步渗透至众多依赖时间序列分析的工业与科学领域。在工业物联网设备监控中,基于Ahri框架训练的模型得以更可靠地识别传感器信号中的异常周期或突变脉冲,从而提升预测性维护的准确率。在生物医学信号处理(如心电图、脑电图)领域,该数据集所强调的周期性判定与事件排序能力,可被迁移至辅助诊断系统,以甄别不规则节律或异常放电事件。此外,在金融高频交易与气象数据分析中,对信号趋势与幅度包络的敏锐捕捉,为自动化决策系统注入了更深邃的时序理解能力,展现了从实验室合成数据到真实世界复杂信号解析的广阔迁移前景。
衍生相关工作
围绕Ahri数据集,学术界涌现了一系列富有启发性的衍生研究工作。其核心贡献在于催生了PhysicsTSLM模型及相关开源工具箱(如OpenTSLM),这些工作将物理先验知识显式地嵌入语言模型架构,显著提升了在Ahri任务上的推理表现与泛化鲁棒性。后续研究进一步探索了将Ahri的层级任务设计理念扩展至更复杂的多变量与非线性动力系统,衍生出全新的评测套件以探针模型对混沌系统与耦合振子行为的感知边界。此外,基于Ahri的held-out区域分析范式,一系列关于分布外检测与因果干预的工作得以展开,为评估时序模型是否真正掌握底层物理机制提供了方法论基石,持续滋养着可解释人工智能与科学机器学习交叉领域的学术沃土。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

