FedScope Employment Data
收藏资源简介:
该仓库包含1998-2024年的140+百万联邦员工记录,处理自官方的FedScope Employment Cube数据集。包括72个季度快照,每季度1.7-2.3百万员工,52个字段,包括人口统计、工作详情和薪酬等信息。
This repository encompasses over 140 million federal employee records from 1998 to 2024, processed from the official FedScope Employment Cube dataset. It includes 72 quarterly snapshots, with approximately 1.7 to 2.3 million employees per quarter, across 52 fields, covering demographic information, job details, and salary data among others.
FedScope Employment 数据集概述
数据集基本信息
- 数据来源:美国人事管理办公室(OPM) FedScope Employment Cube
- 记录数量:1.4亿+联邦雇员记录(1998-2024)
- 时间范围:1998年3月至2024年9月
- 数据格式:Parquet文件(72个季度快照)
- 许可证类型:公共领域(美国政府工作)
数据内容
- 时间覆盖:
- 1998-2008:仅9月(年度快照)
- 2009年:9月、12月
- 2010-2024:完整季度覆盖(3月、6月、9月、12月,截至2024年9月)
- 字段信息:
- 52个字段(包含人口统计、工作详情和薪酬信息)
- 已连接查找表便于使用
- 每季度记录:170-230万雇员记录
数据结构
- 主表:FACTDATA_*.TXT(雇员记录)
- 查找表:
- 年龄等级(DTagelvl.txt)
- 机构(DTagy.txt)
- 教育水平(DTedlvl.txt)
- 通用计划等级(DTgsegrd.txt)
- 位置(DTloc.txt)
- 职业(DTocc.txt)
- PATCO类别(DTpatco.txt)
- 薪酬计划(DTpp.txt,2017年起)
- 薪酬计划和等级(DTppgrd.txt)
- 薪酬水平(DTsallvl.txt)
- STEM职业(DTstemocc.txt)
- 监督状态(DTsuper.txt)
- 任命类型(DTtoa.txt)
- 工作安排(DTwrksch.txt)
- 工作状态(DTwkstat.txt)
获取方式
-
直接下载: python import pandas as pd df = pd.read_parquet(https://github.com/abigailhaddad/fedscope_employment/raw/main/fedscope_data/parquet/fedscope_employment_September_2024.parquet)
-
克隆仓库: bash git clone https://github.com/abigailhaddad/fedscope_employment.git
使用示例
-
按机构统计雇员数量: python agency_counts = df.groupby(agysubt)[employment].apply(lambda x: sum(int(i) for i in x)).sort_values(ascending=False)
-
按教育水平计算平均薪资: python df[salary_numeric] = df[salary].apply(lambda x: int(float(x)) if x not in [None, nan, *****, ] and pd.notna(x) else None) salary_by_edu = df.groupby(edlvlt)[salary_numeric].mean()
仓库结构
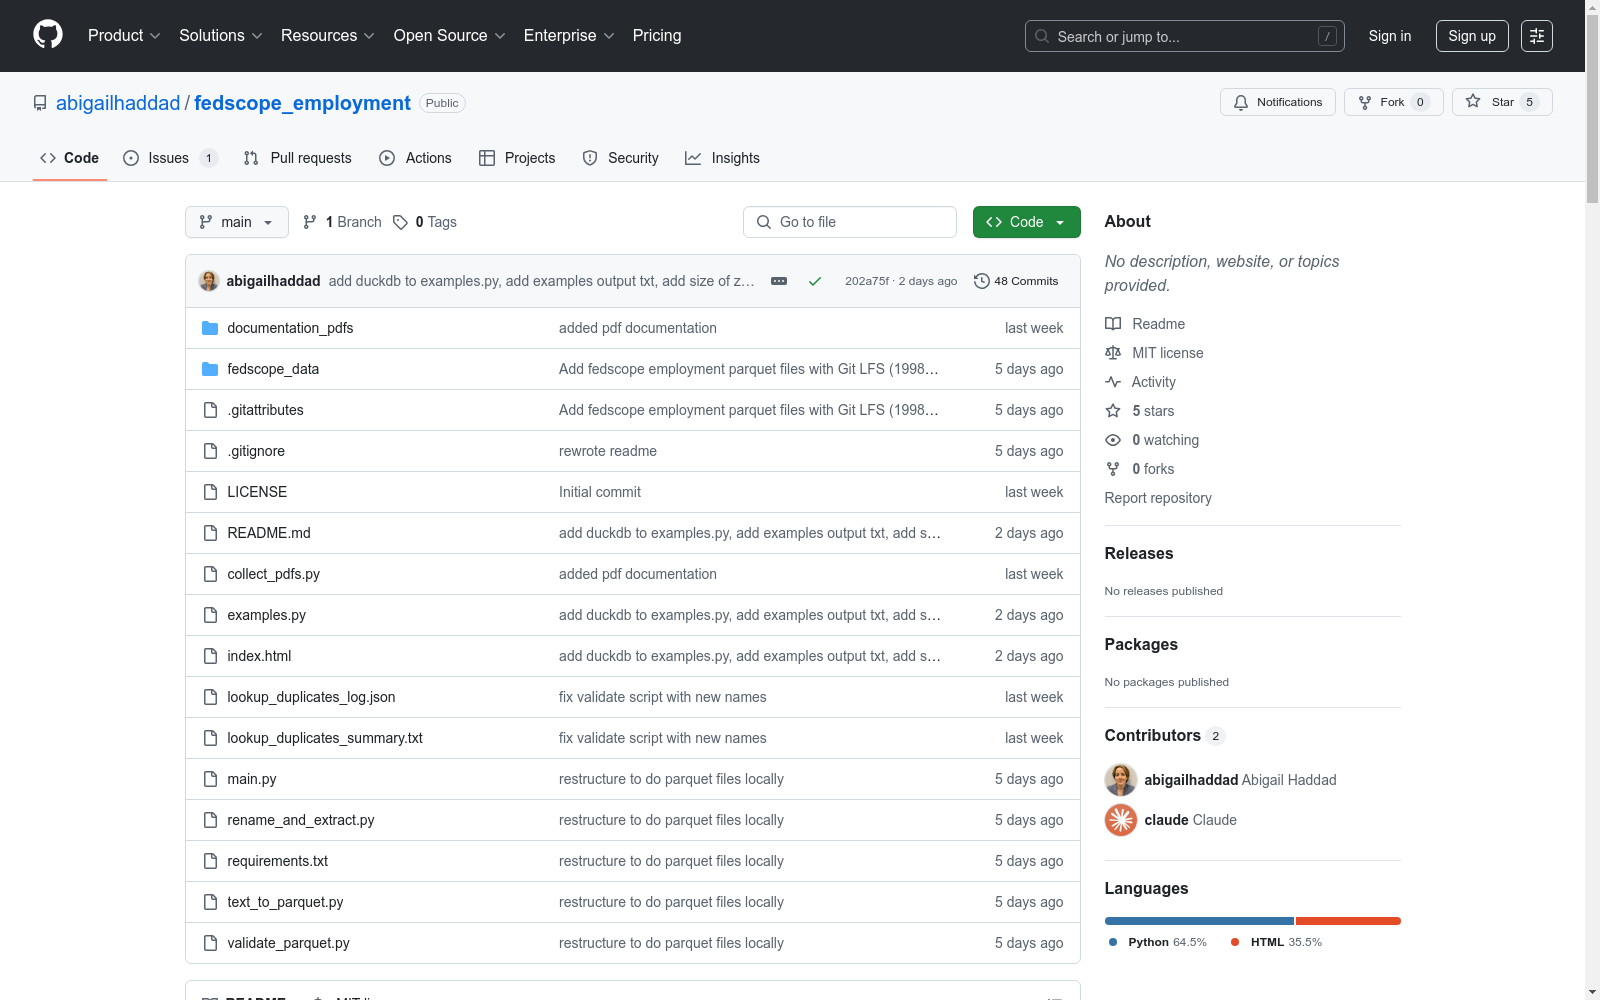
fedscope_employment/ ├── fedscope_data/ │ ├── raw/ # 72个季度ZIP原始文件 │ ├── extracted/ # 提取的数据文件 │ └── parquet/ # 72个季度Parquet文件 ├── main.py # 主处理脚本 ├── rename_and_extract.py # ZIP文件处理脚本 ├── text_to_parquet.py # TXT转Parquet脚本 ├── validate_parquet.py # 验证脚本 └── documentation_pdfs/ # 季度数据集PDF文档
注意事项
- 数值字段(如employment和salary)使用字符串类型存储
- 建议使用以t结尾的描述字段进行分析(包含人类可读值)