
VerboVision/cem_mil_pares_5k_pt_4
收藏官方服务:
资源简介:
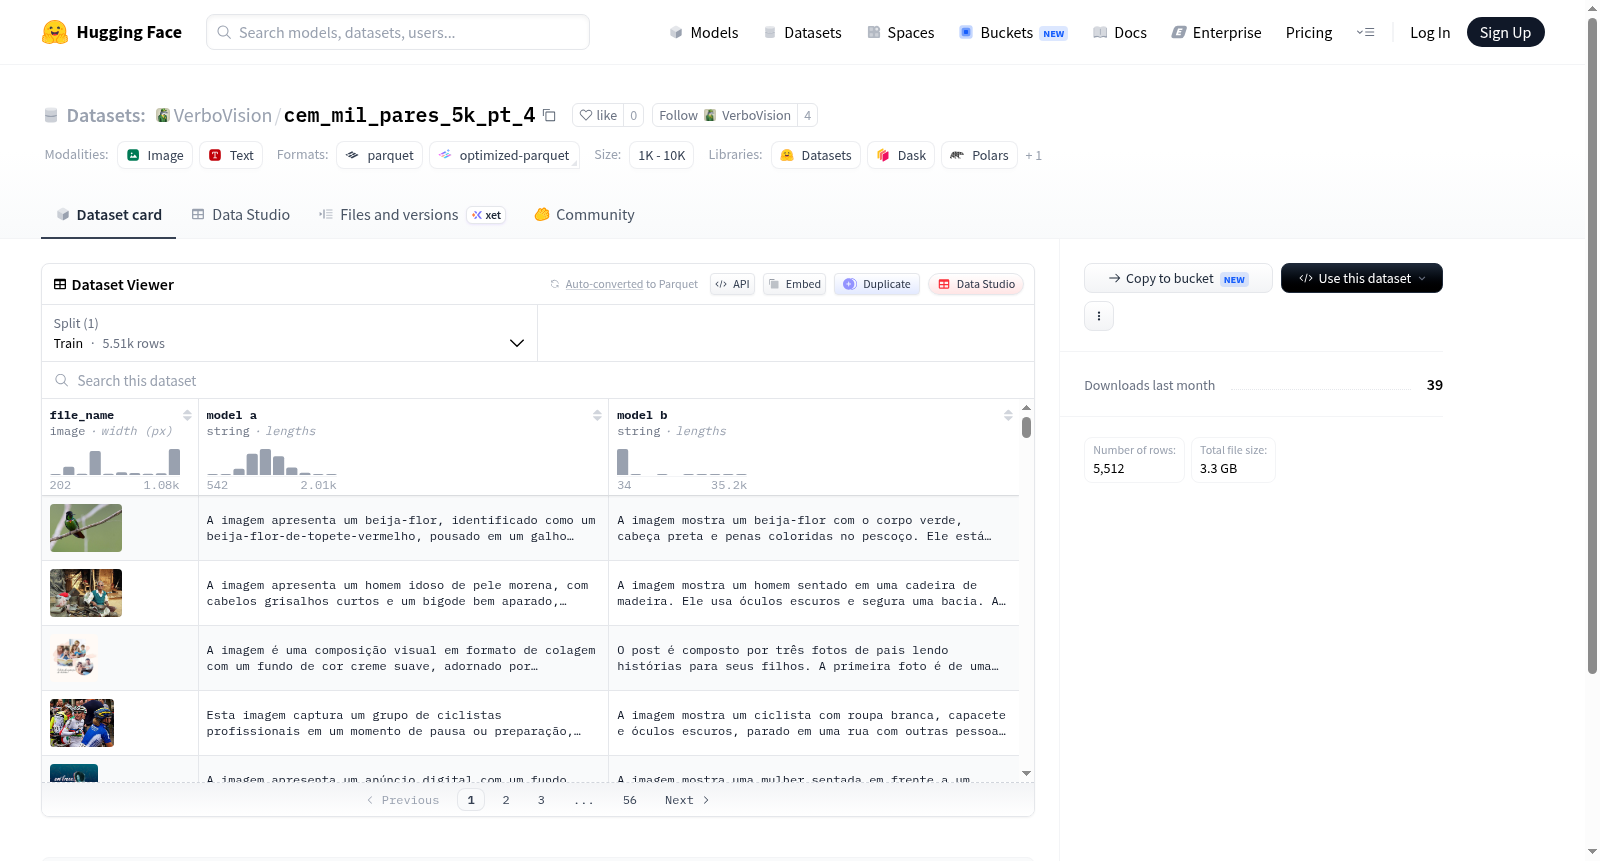
该数据集包含5,512个训练示例,主要特征包括图像文件名称(file_name)、两个字符串类型的模型字段(model a和model b)。数据集大小为约3.3GB,下载大小相近,可能已压缩存储。数据以Train分割组织,文件路径为data/Train-*,适用于图像与相关模型数据的分析任务。
This dataset consists of 5,512 training examples, with key features including image file names (file_name) and two string-type model fields (model a and model b). The dataset size is approximately 3.3GB, with a similar download size, indicating potential compression. Data is organized into a Train split, with file paths in data/Train-*, suitable for analysis tasks involving images and associated model data.
提供机构:
VerboVision搜集汇总
数据集介绍
构建方式
该数据集名为cem_mil_pares_5k_pt_4,专注于葡萄牙语环境下的图像与文本配对任务。其构建遵循标准监督学习范式,包含5512个训练样本,每个样本由图像文件(file_name字段)与两个文本描述(model a与model b)构成。数据以Parquet格式存储于HuggingFace Datasets框架中,通过分片文件(Train-*)组织,便于高效加载。构建过程强调图像与多文本之间的语义对齐,为多模态对比学习提供了基础数据支撑。
特点
数据集的核心特色在于其双文本标注结构,同一张图像对应两个独立的葡萄牙语描述(model a与model b),这种设计有助于捕捉语言表达的多样性,并支持模型学习同一视觉内容下的不同语言表征。图像字段采用dtype: image原生格式,可直接利用深度学习框架的视觉处理管线。尽管规模仅为5k级别,但专注领域与高质量标注使其适用于小样本微调或领域适配任务。
使用方法
使用该数据集时,推荐通过HuggingFace Datasets库的load_dataset函数加载,指定路径为cem_mil_pares_5k_pt_4,系统将自动处理分片合并。训练阶段可将图像与model a作为输入-目标对,同时利用model b进行对比学习或数据增强。图像输入前需统一缩放至合适尺寸(如224x224),并通过标准化预处理。鉴于数据集仅含训练集拆分,验证时可自行划分或进行交叉验证。
背景与挑战
背景概述
cem_mil_pares_5k_pt_4数据集的创建源于葡萄牙语自然语言处理领域中图像与文本匹配研究的迫切需求,由巴西的研究团队于2023年构建并发布。该数据集聚焦于视觉与语言对齐这一核心研究问题,旨在为多模态学习提供高质量的葡萄牙语评估基准。其影响力体现在填补了低资源语言在多模态场景下数据稀缺的空白,为跨模态检索、图像描述等任务提供了5000余对精心标注的样本,推动了面向葡萄牙语的多模态模型发展。
当前挑战
该数据集面临的挑战主要体现在两个方面:首先,在领域问题层面,葡萄牙语多模态研究长期受限于标注数据数量与质量,导致现有模型在图像-文本匹配的语义理解上存在偏差,难以捕捉语言中的细微文化差异和视觉关联。其次,构建过程中面临标注成本高昂和跨模态一致性难以保障的难题,需要对图像与文本对进行人工审核以消除歧义,同时平衡数据集的多样性与规模,确保覆盖日常场景与专业领域。
常用场景
经典使用场景
cem_mil_pares_5k_pt_4数据集是一个专注于葡萄牙语语境下图像与文本匹配任务的基准资源。其核心设计旨在支持多模态学习研究,特别是针对图像与成对文本描述(model a与model b)的语义对齐问题。该数据集包含5512个训练样本,每个样本由一张图片和两种可能的文本表述构成,这使其成为训练和评估视觉-语言跨模态检索模型的理想选择。在经典使用场景中,研究者利用该数据集构建能够理解图片内容并区分不同文本表述优劣的系统,例如在广告创意评估中判断哪个标语更契合图像主题,或在电商平台上自动生成与商品图片匹配度更高的产品描述。
解决学术问题
在学术领域,该数据集主要解决了葡萄牙语多模态学习中缺乏高质量标注配对数据的困境。它填补了低资源语言(如葡萄牙语)在视觉-语言任务中的空白,为研究跨语言迁移学习、多模态表征学习以及细粒度语义理解提供了重要基准。通过提供具有竞争性文本选项的成对数据,cem_mil_pares_5k_pt_4推动了对比学习、排序损失等算法的改进,使研究者能够深入探索模型在区分近似语义时的鲁棒性。其意义在于促进了多语言多模态系统的发展,助力减少语言鸿沟对AI应用的影响,并验证了在资源匮乏情景下数据增强与预训练策略的有效性。
衍生相关工作
该数据集衍生了一系列具有影响力的经典工作。基于其成对文本结构,研究者提出了改进的孪生网络架构与多模态对比学习框架,例如将CLIP模型适配至葡萄牙语场景,并验证了跨语言表示对齐的有效性。后续工作还包括利用该数据探索硬负例挖掘策略,开发针对低资源语言的微调方法,以及构建更复杂的多模态生成式预训练模型(如葡语版VinVL)。此外,数据集的发布催生了专门的基准测试,用于评估模型在葡萄牙语图文检索任务中的表现,相关研究成果多次发表在ACL、EMNLP等顶级会议上,推动了低资源语言多模态研究的范式创新。
以上内容由遇见数据集搜集并总结生成


