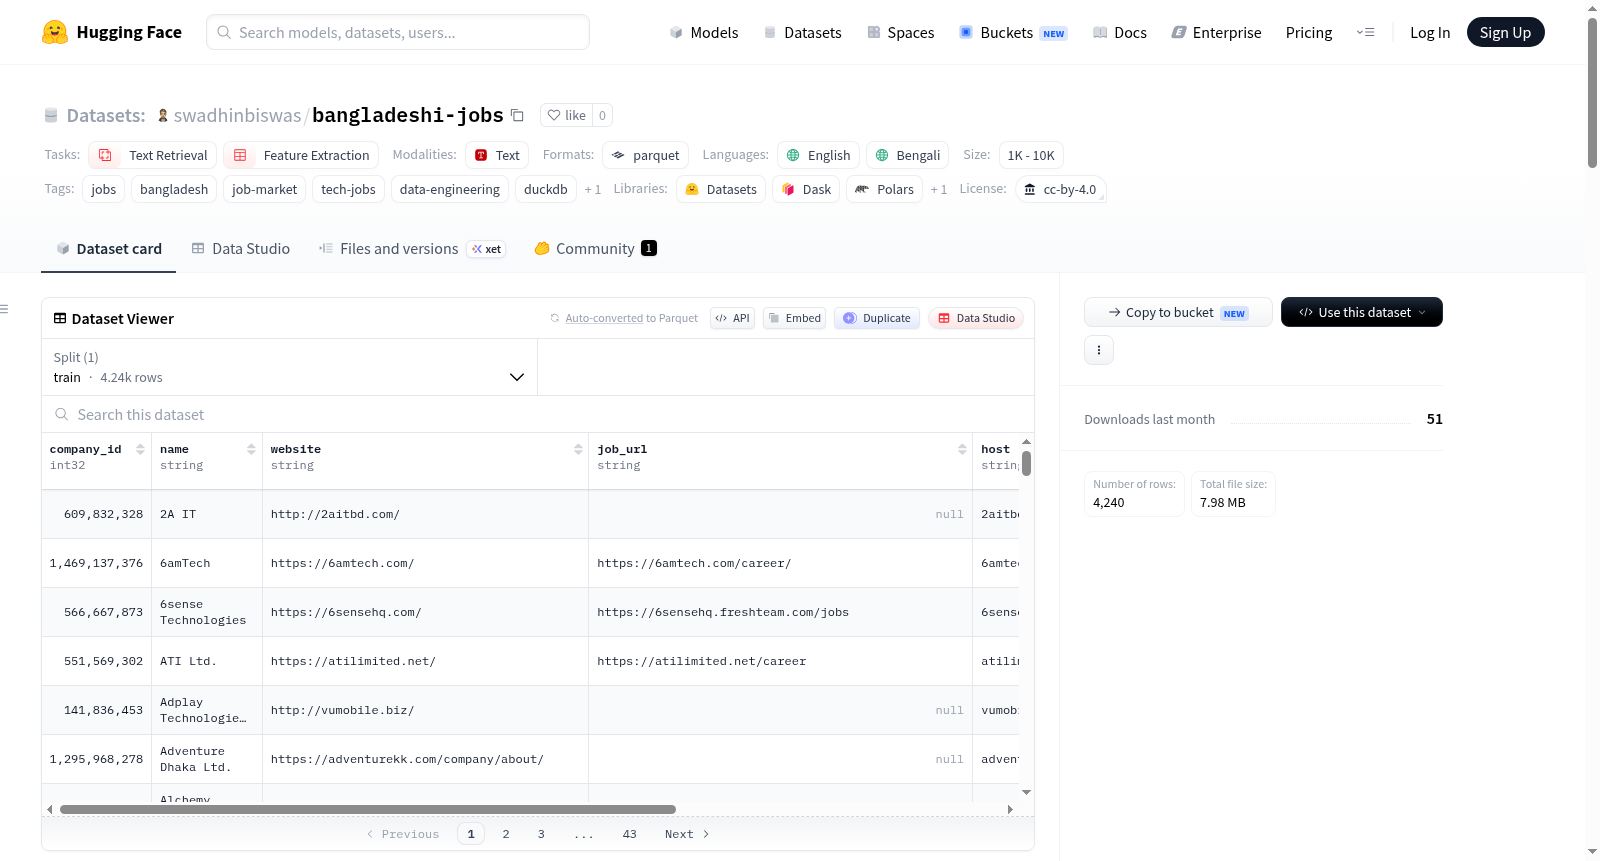
bangladeshi-jobs
收藏资源简介:
Bangladeshi Tech Jobs 是一个每周刷新的孟加拉国技术职位开放数据集,涵盖了来自孟加拉国软件和IT公司的公开职位信息。该数据集通过自动爬取、LLM提取和数据仓库管道构建,提供结构化的职位数据。数据以JSON、Parquet和DuckDB星型模式发布,主要事实表包含职位ID、公司名称、职位标题、描述、雇佣类型、地点、薪资范围、截止日期、标签、申请链接等字段。截至2026年8月21日,数据集包含558个公开职位、73家正在招聘的公司、572种不同技能需求,并支持远程、混合和现场办公模式。数据集适用于文本检索、特征提取、职位市场分析、技能需求分析等任务。数据遵循CC-BY-4.0许可,要求注明出处。
Bangladeshi Tech Jobs is a weekly refreshed dataset of open tech job positions in Bangladesh, covering public job information from software and IT companies in Bangladesh. The dataset is built through automated scraping, LLM extraction, and data warehouse pipeline, providing structured job data. It is published in JSON, Parquet, and DuckDB star schema formats. The main fact table includes fields such as job ID, company name, job title, description, employment type, location, salary range, deadline, tags, application link, etc. As of August 21, 2026, the dataset contains 558 open positions, 73 companies hiring, 572 different skill requirements, and supports remote, hybrid, and on-site work modes. The dataset is suitable for tasks such as text retrieval, feature extraction, job market analysis, and skill demand analysis. The data is licensed under CC-BY-4.0, requiring attribution.
Bangladeshi Tech Jobs 数据集概述
基本信息
- 数据集名称:Bangladeshi Tech Jobs(孟加拉国科技岗位)
- 许可证:CC-BY-4.0(允许自由使用,需注明出处)
- 语言:英语(en)、孟加拉语(bn)
- 任务类型:文本检索、特征提取
- 数据规模:1K < n < 10K
- 更新频率:每周自动刷新
数据内容
该数据集收录了来自孟加拉国科技公司的软件与IT岗位招聘信息,通过自动化爬取→LLM提取→数据仓库的流水线构建而成。具体包括:
- 注册公司数:234家
- 已验证招聘页面的公司:140家
- 当前正在招聘的公司:73家
- 开放职位数:558个
- 累计追踪职位数:558个
- 需求技能种类:572种
- 支持远程的职位:10个
- 中位最高月薪(明示薪资):60,000 ৳(孟加拉塔卡)
- 最活跃招聘方:Next Ventures
- 最热门技能:Python
文件结构
数据集提供多种格式,涵盖不同层级的数据视图:
| 文件/目录 | 说明 |
|---|---|
gold/ |
推荐入口点(JSON + Parquet),含 recent_jobs、companies、tech_demand、jobs_per_company、location_heatmap、salary_stats、employment_breakdown、company_tech、stats.json |
parquet/ |
规范化表:fact_job(职位事实表)、dim_company(公司维度表)、bridge_job_tag(职位-标签关联表)、job_snapshot(SCD历史记录) |
warehouse.duckdb |
完整的DuckDB星型模式,可原地查询 |
raw/job-posts.json |
爬虫原始输出(数据源) |
核心表结构(fact_job)
主要字段包括:
- job_id:主键(sha256哈希),跨运行稳定
- company_name:公司名称(匹配公司注册表)
- title / description_md:职位名称与清理后的Markdown描述
- employment_type:全职/兼职/合同/实习/自由职业/临时
- location_text / location_type:远程/混合/现场
- salary_min / salary_max / currency:显式薪资范围(强制min ≤ max)
- deadline_date / is_open / is_expired:截止日期与开放状态
- tags:规范化技能标签(如React、NodeJS、PostgreSQL)
- apply_links / source_url:申请链接与来源追溯
- first_seen_at / last_seen_at:首次与最后出现时间戳
数据流水线
公司招聘页面(孟加拉软件公司注册表) → 爬虫(ATS JSON API → schema.org JSON-LD → Markdown + 分页) → LLM批量提取(受模式约束) → LLM精炼优化(按ID对齐的清洗批次) → 确定性增强(去重、置信度≥0.5门槛、薪资合理性检查) → DuckDB数据仓库(按job_id幂等更新) → gold视图 → 每周刷新
数据来源为公司官方招聘页面及BDJobs招聘板(仅限注册雇主,排除无关发帖者),每个职位保留原始 source_url。
质量保障
- 去重:同一公司内相同(职位、地点)保留最高置信度记录
- 置信度门槛:低于0.5的记录发布前剔除
- 薪资合理性:仅保留显式薪资,min ≤ max,货币标准化
- 新鲜度:过期职位从所有“开放”视图中过滤,逐行记录
last_seen_at - 幂等重建:相同输入产生相同
job_id,每周运行不产生重复数据
使用方式
可通过以下方式快速访问数据:
- 命令行:
curl获取gold/stats.json获取关键指标 - Python:
pandas读取gold/recent_jobs.json进行分析 - SQL:DuckDB 直接远程查询Parquet文件,无需下载
局限性
- 描述和结构化字段由LLM提取,可能存在少量提取噪声(已通过精炼流程和置信度门槛缓解)
- 薪资仅在招聘方明确写明时才收录(约占少数职位)
- 覆盖范围限于注册公司名单;未注册的公司即使在其他招聘板发布信息也不会被收录
引用方式
bibtex @dataset{bangladeshi_tech_jobs_2026, title = {Bangladeshi Tech Jobs — Open Dataset}, author = {swadhinbiswas}, year = {2026}, url = {https://huggingface.co/datasets/swadhinbiswas/bangladeshi-jobs}, note = {Weekly-refreshed job postings from Bangladeshi software companies} }