
LMSerg/iola-gemma3-router-sft
收藏官方服务:
资源简介:
IOLA Gemma 3 Router SFT是一个基于gemma3:1b的小型路由模型的监督微调数据集。其目标是通过训练,使模型不依赖于记忆中的可变城市数据来回答问题,而是返回严格的JSON/tool-call调用到真实数据源,例如FastAPI/MCP、RAG/Qdrant或个性化层。数据集包含多个版本的训练和评估文件,覆盖了学校/幼儿园实体路由、对抗性错误前提示例、安全澄清、拒绝、实体搜索、官员信息和RAG示例等场景。数据格式为JSONL,每条记录包含两个聊天消息,用于训练模型做出路由决策,而非提供最终事实信息。
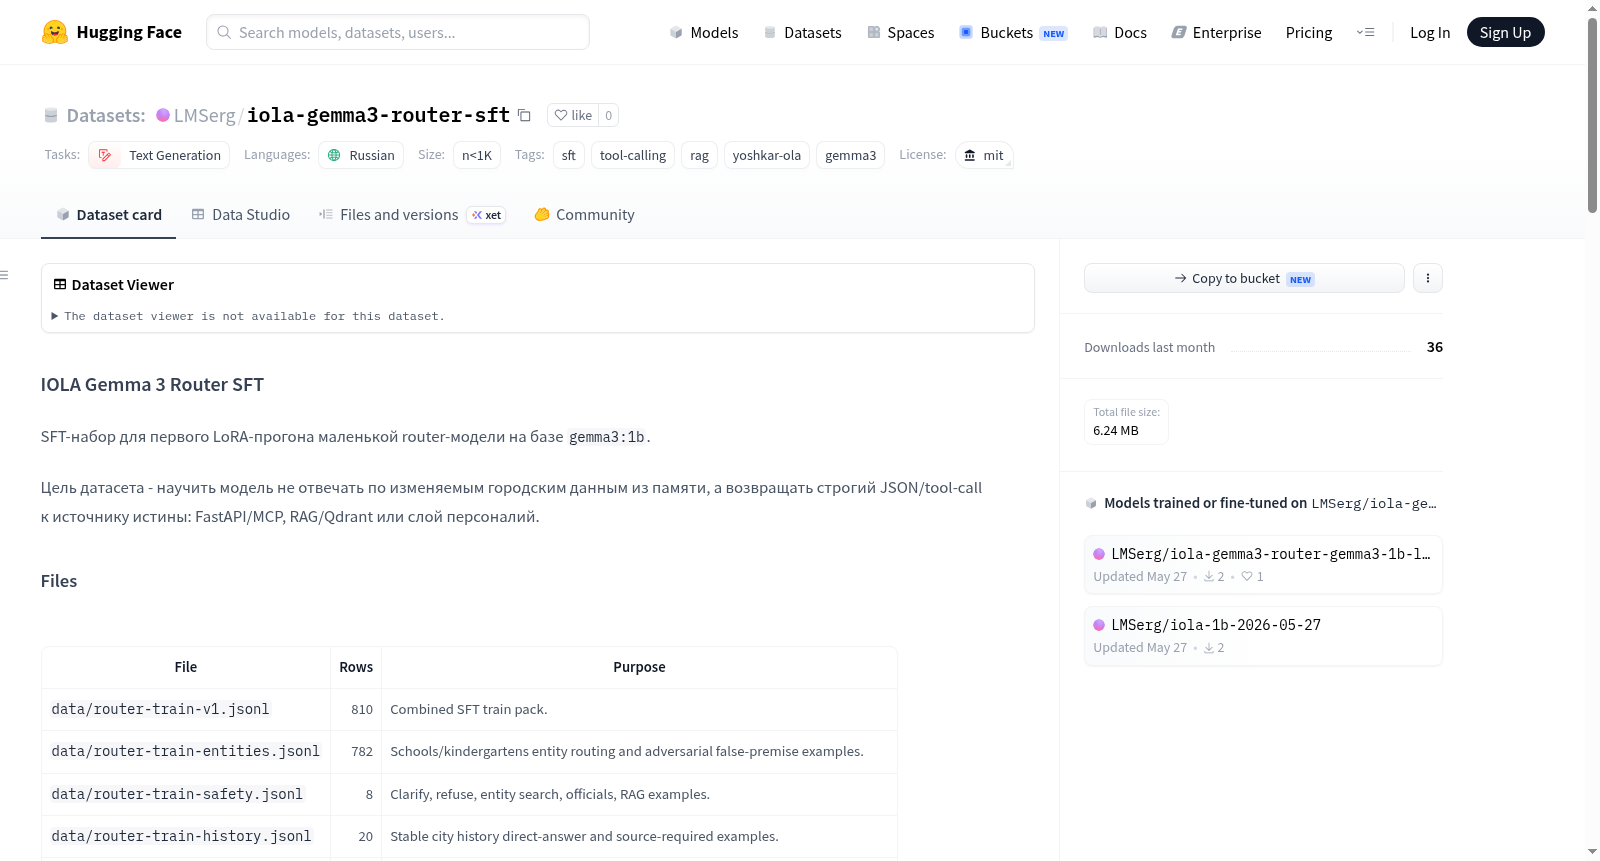
SFT dataset for the first LoRA run of a small router model based on `gemma3:1b`. The goal of the dataset is to teach the model not to answer based on mutable city data from memory, but to return a strict JSON/tool-call to the source of truth: FastAPI/MCP, RAG/Qdrant, or a personalization layer.
提供机构:
LMSerg搜集汇总
数据集介绍
构建方式
该数据集名为 IOLA Gemma 3 Router SFT,专为在 gemma3:1b 基座模型上进行首次 LoRA 微调而构建,旨在训练一个小型路由模型。数据集通过 JSONL 格式组织,每个样本包含用户查询与助手响应对,助手响应严格限定为 JSON 格式的路由决策(如工具调用、澄清、拒绝或直接回答),而非直接提供事实性答案。构建过程涵盖了多个迭代版本(V1 至 V6),每个版本均在前一版本的基础上针对特定失败场景进行修复与强化,例如 V3 增加了别名与搜索用例,V4 修复了 V3 的错误,V6 强化了对薪资与私人数据的拒绝能力,以确保模型能够准确地将查询路由至 FastAPI/MCP、RAG/Qdrant 或人物层等外部信息源。
特点
数据集的特点在于其精细的迭代优化策略与严格的验证机制。从初始的 V1 训练集(810 行)到最终的 V6(910 行),每一版本均包含独立的评估集(30 行),确保训练与评估问题无重叠。数据覆盖了实体路由、安全边界、城市历史回答等多个场景,特别强调学校与幼儿园的实体字段查询,模型仅需输出路由决策(如 entity_number 与 entity_name),避免了强制记忆任意 INN 号码。此外,数据集定义了明确的动作(tool_call、clarify、refuse、direct_answer)与工具(如 get_entity_field、search_entities、rag_search)合同,并通过命令 npm run generate:router 和 npm test 等实现自动化验证,保障了输出 JSON 的严格合规性。
使用方法
使用该数据集时,研究人员需基于 gemma3:1b 模型进行 LoRA 微调。数据以 JSONL 格式提供,可直接用于 HuggingFace 的 Transformers 或 TRL 库中的 SFT 训练流程。训练前应确保理解其路由合同:模型必须输出精确的 JSON 动作,如 {"action":"tool_call","tool":"get_entity_field","args":{"layer":"schools","inn":"1215067590","field":"phone"}} 或采用 V2 的 entity_number/entity_name 模式。建议依次使用各版本的训练集进行迭代训练,并通过 GitHub 仓库中提供的验证脚本(npm run validate:router 与 npm test)检查模型输出的合规性。评估时应使用对应的 held-out 评估集(如 router-eval-v6.jsonl),以测试模型在未见查询上的路由表现。
背景与挑战
背景概述
在面向特定领域的对话系统中,大型语言模型(LLM)被广泛用于处理用户的查询,然而当模型需要访问动态更新的城市数据(如学校、幼儿园的联系方式或政府官员信息)时,直接依赖模型记忆往往导致信息过时或不准确。为应对这一挑战,IOLA Gemma 3 Router SFT数据集于2025年由研究团队基于Gemma 3 1B模型创建,核心研究问题聚焦于如何让小型语言模型学会不再直接回答可变事实性问题,而是通过严格的JSON格式输出工具调用(tool call),将用户请求路由至外部真实来源(如FastAPI、RAG或Qdrant向量库)。该数据集包含多个迭代版本(V1至V6),总计超过800条训练样本,每个版本针对前一版本的失败案例进行有针对性的修复,其贡献在于为构建可靠、可审计的知识路由代理提供了关键的监督微调(SFT)训练资源。
当前挑战
该数据集所解决的核心领域问题在于,小型语言模型在参数量有限(1B)的情况下,难以同时掌握记忆城市实体细节与准确执行路由决策的双重能力,直接回答易引入幻觉,导致信息不准确。构建过程中面临的挑战包括:1)需要设计严格的输出合约(contract),限定允许的操作(如tool_call、clarify、refuse)和工具集合,确保模型输出结构化且可验证;2)必须平衡训练样本的覆盖度与避免过拟合,V1至V6的迭代过程揭示了模型在特定失败模式(如身份编号误识别、隐私数据拒绝)上的反复波动;3)构建对抗性假前提(adversarial false-premise)样本以提升模型鲁棒性,这在仅千条级的小规模数据集中尤为困难。此外,持续维护验证流水线(validation pipeline)以确保训练集与评估集无问题重叠,进一步增加了数据质量控制的复杂性。
常用场景
经典使用场景
该数据集专为训练轻量级路由模型而设计,经典使用场景是将Gemma 3 1B模型微调为一个智能路由器,使其能够根据用户输入判断是直接回答、调用工具、请求澄清还是拒绝回答。数据集包含超过800条训练样本,涵盖实体路由、安全拒绝、历史查询、RAG检索等典型交互模式,每一条样本均以结构化的JSON格式定义模型输出行为,引导模型学会区分存储在内存中的固定知识与需要从外部数据源获取的动态信息。通过多轮迭代优化(v1至v6),数据集逐步增强了模型在实体匹配、别名解析、隐私数据保护等方面的路由决策能力,从而构建一个高效、可控且易于扩展的对话路由系统。
实际应用
在实际部署中,该数据集训练出的路由模型可作为城市便民服务智能助手的前端决策引擎,例如在学校、幼儿园等市政机构的信息查询场景中,用户询问“某学校电话”时,模型不直接输出可能过期或错误的电话号码,而是返回一个标准化的工具调用请求,由后端FastAPI服务从权威数据库获取最新数据。系统同时具备RAG检索、在职官员查询、历史信息稳定回答等功能,并针对薪资查询等隐私敏感话题实施拒绝策略。此架构使企业或政府机构能够以极低的计算成本维护一套实时准确、安全可控的对话系统,广泛适用于智慧城市、企业内部知识库问答等场景。
衍生相关工作
该数据集衍生出的核心工作是开源项目“iola-small-model-lab”,其维护了完整的动作协议与验证器,支持对路由模型的输出进行严格校验,包括JSON格式合规性、动作与工具白名单、参数范围等,并内置了训练集与测试集的去重叠检测。此外,基于该数据集的迭代版本(v2至v6)已逐步演化出多种优化方向:例如v2版本为缓解1B模型记忆INN的负担,引入实体编号与名称的动态解析机制;v6版本强化了对薪资及个人隐私数据的拒绝回答能力。这些衍生工作不仅丰富了路由模型的训练策略,还为小模型在实体匹配、安全对齐、工具调用等子任务上的联合训练提供了标准化的数据基础与评估框架。
以上内容由遇见数据集搜集并总结生成


