DORAEMONG/PRO-STEP-Preference-Data
收藏资源简介:
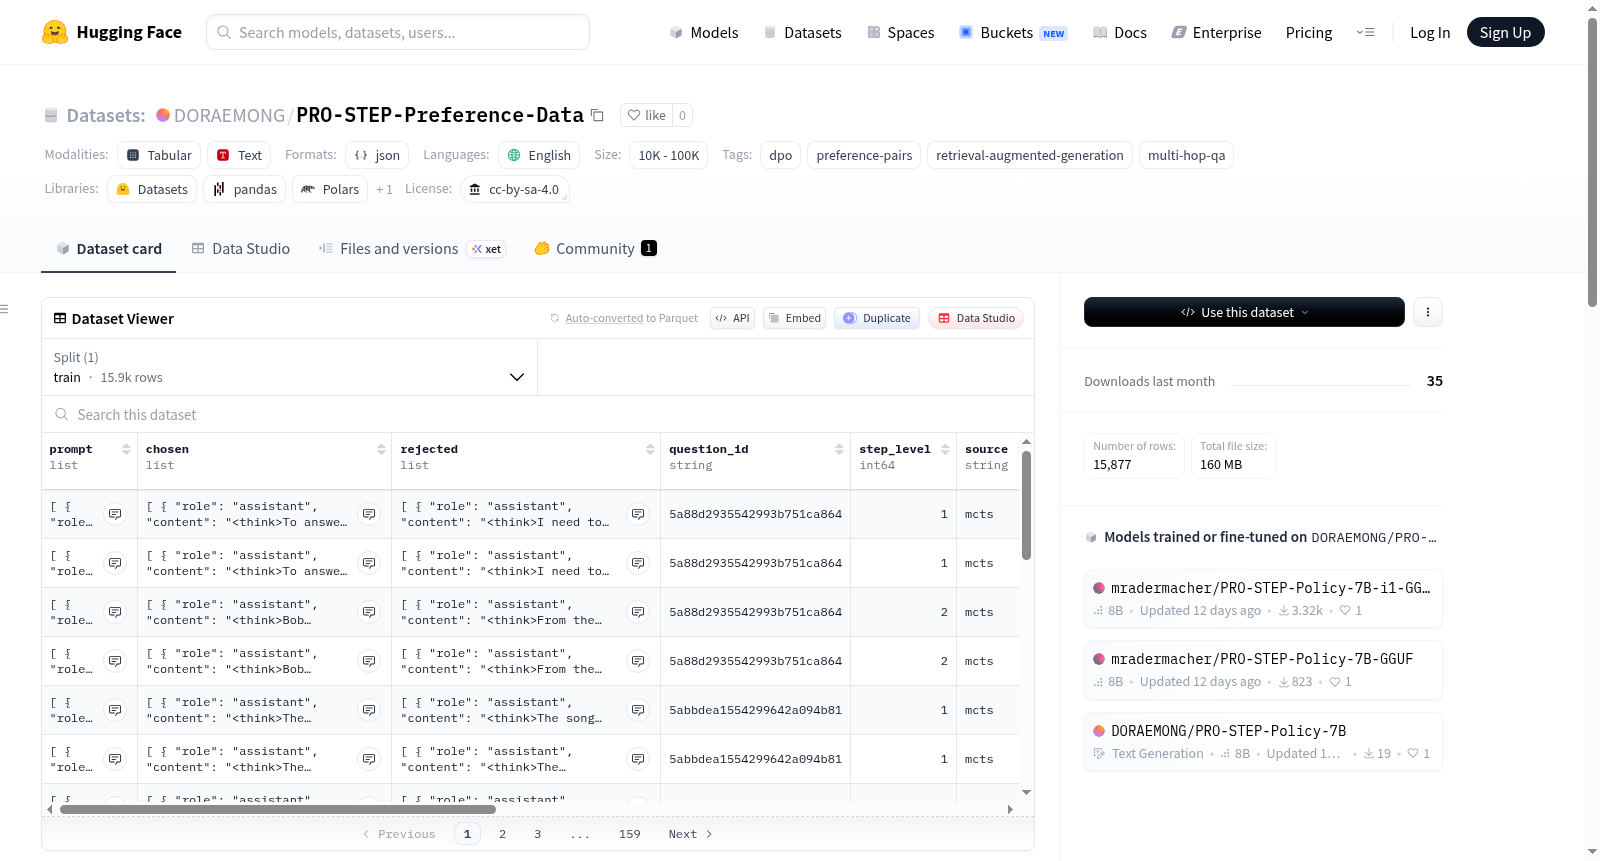
PRO-STEP: DPO偏好对数据集包含15,877个步骤级别的偏好对,用于通过直接偏好优化(DPO)训练PRO-STEP策略模型。数据来源于HotpotQA、MuSiQue和2WikiMultiHopQA的训练分割,共5,000个问题。生成过程采用PRM-guided MCTS(K=3分支,深度7,每个问题64次滚动,V(s) = Q̄(s) + α · r̂(s),α=0.3)。过滤条件为:chosen-trajectory的token-F1 ≥ 0.2且(chosen − rejected) F1差异 ≥ 0.2。每个偏好对以JSONL格式存储,包含prompt、chosen、rejected、question_id、step_level等多个字段。数据集可用于TRL DPOTrainer的直接训练。
PRO-STEP: DPO Preference Pairs dataset contains 15,877 step-level preference pairs used to train the PRO-STEP policy model via Direct Preference Optimization (DPO). The data is sourced from 5,000 questions from the training splits of HotpotQA, MuSiQue, and 2WikiMultiHopQA. Generation is done via PRM-guided MCTS (K=3 branching, depth 7, 64 rollouts/question, V(s) = Q̄(s) + α · r̂(s) with α=0.3). Filtering criteria: chosen-trajectory token-F1 ≥ 0.2 AND (chosen − rejected) F1 margin ≥ 0.2. Each preference pair is stored in JSONL format with fields like prompt, chosen, rejected, question_id, step_level, etc. The dataset can be used directly with TRL DPOTrainer.