遇见数据集

imirandam/BiVLC

收藏
Hugging Face2024-06-17 更新2024-06-12 收录
官方服务:

资源简介:

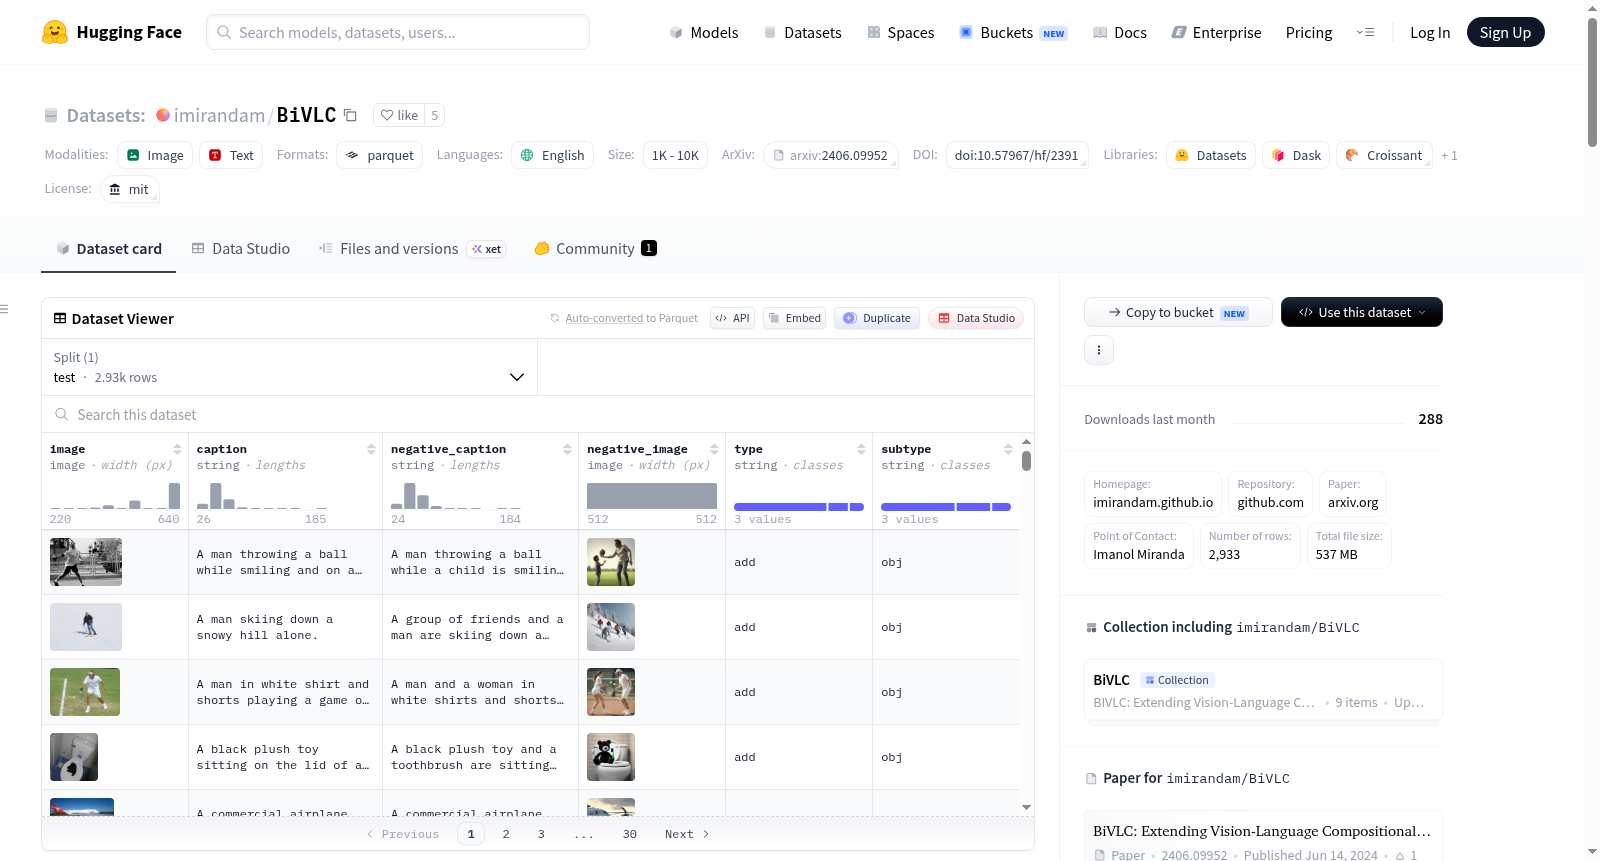
BiVLC是一个用于双向视觉-语言组合性评估的基准数据集。每个实例包含两个图像和两个描述文本。模型需要基于每个图像和描述文本选择正确的图像-文本对,以评估模型在图像到文本和文本到图像检索中的表现。数据集来源于COCO 2017验证集,并通过SugarCrepe生成负样本描述,BiVLC生成负样本图像。数据集包含2933个测试实例,每个实例由2个图像和2个描述文本组成,共11732个检索实例。

BiVLC is a benchmark for Bidirectional Vision-Language Compositionality evaluation. Each instance consists of two images and two captions. Using each of the images and captions as a base, a model is asked to select the pair that correctly represents the base versus the hard negative distractor with minor compositional changes. Thus, we can measure image-to-text and text-to-image retrieval with hard negative pairs. The dataset is derived from the COCO 2017 validation split, with negative captions generated by SugarCrepe and negative images generated by BiVLC. The dataset contains 2,933 test instances, each consisting of 2 images and 2 captions, totaling 11,732 retrieval instances.

提供机构:
imirandam
原始信息汇总

数据集概述

数据集名称: BiVLC

数据集描述: BiVLC是一个用于双向视觉-语言组合性评估的基准数据集。每个实例包含两张图像和两个标题,用于评估模型在图像到文本和文本到图像检索中的表现,特别是在处理具有轻微组合变化的硬负样本对时的能力。

数据集特征:

  • image: 图像数据,来自COCO 2017验证集。
  • caption: 字符串,描述对应图像的文本。
  • negative_caption: 字符串,由SUGARCREPE生成的负面描述。
  • negative_image: 图像数据,由BiVLC根据负面描述生成。
  • type: 字符串,负面实例的类别(Replace, Swap, Add)。
  • subtype: 字符串,负面实例的子类别(Object, Attribute, Relation)。

数据集分割:

  • test: 包含2933个实例,总数据大小为567921772.034字节。

数据集大小:

  • 下载大小: 536810279字节
  • 数据集大小: 567921772.034字节

语言:

  • en

数据集类别大小:

  • 1K<n<10K

数据集实例结构

每个实例包含以下字段:

  • image: COCO 2017验证集图像。
  • caption: 描述图像的文本。
  • negative_caption: 由SUGARCREPE生成的负面文本描述。
  • negative_image: 根据负面描述生成的图像。
  • type: 负面实例的类别。
  • subtype: 负面实例的子类别。

数据集使用示例

python

data = load_dataset("imirandam/BiVLC", split = "test")

数据集统计

  • test分割: 2933个实例,每个实例包含2张图像和2个标题,总计11732个检索实例,其中50%为文本到图像检索,50%为图像到文本检索。

源数据

  • image和caption: 来自COCO 2017验证分割。
  • negative_caption: 由SUGARCREPE根据COCO标题生成的文本描述。

训练数据

许可证信息

  • MIT许可证
搜集汇总
数据集介绍
imirandam/BiVLC 数据集图片
构建方式
BiVLC数据集的构建旨在评估视觉-语言模型在双向组合性理解上的能力。其构建过程始于从COCO 2017验证集中选取正样本图像与对应的描述性文本。随后,利用SugarCrepe方法对原始描述进行微小的组合性改动,生成具有挑战性的负样本文本。这些负样本文本被用于驱动负样本图像的生成,最终通过人工标注者筛选出最合理的负样本图像,并进一步过滤掉模棱两可的实例,确保每个样本对具备明确的区分性。整个流程涵盖了从正样本到双向负样本对的系统性生成与质量控制。
使用方法
使用BiVLC数据集时,可通过HuggingFace的datasets库直接加载测试集,调用`load_dataset("imirandam/BiVLC", split="test")`即可获取包含图像与文本对的实例。每个实例以字典形式提供,包含PIL图像对象、正负描述字符串及类型标签。评估时,模型需对每个实例分别完成图像到文本与文本到图像的匹配任务,通过对比正样本与难负样本的检索正确率来衡量双向组合性理解能力。数据集设计支持直接用于零样本评估,无需额外训练数据。
背景与挑战
背景概述
在视觉与语言交叉领域,组合性理解(compositionality)是评估多模态模型能否精准捕捉细粒度语义变化的核心能力。现有基准如SugarCrepe虽能衡量文本到图像的组合性,却忽略了图像到文本方向的对称性评估。为弥补这一空白,Imanol Miranda等来自巴斯克大学的研究团队于2024年提出了BiVLC(Bidirectional Vision-Language Compositionality)基准。该数据集基于COCO 2017验证集的图像与描述,通过SugarCrepe生成负向描述,并进一步利用文本到图像技术构造负向图像,从而构建出包含2,933个实例的双向检索测试集。每个实例均包含正向与负向的图像-文本对,涵盖替换、交换与添加三种组合变化类型,并细分为对象、属性与关系子类。BiVLC的提出显著推动了多模态模型在双向组合性推理上的评估标准,为后续研究提供了更为全面的测试框架。
当前挑战
BiVLC所解决的领域挑战在于现有组合性基准的单向性缺陷,即仅关注文本到图像检索而忽视图像到文本的对称能力,导致模型在双向任务中的真实组合性理解被低估。构建过程中面临多重挑战:首先,需从COCO描述中经由SugarCrepe生成语义精确的硬负向文本,确保微小改动能显著改变整体语义;其次,利用文本到图像模型生成与负向文本匹配的负向图像时,需保证图像质量与语义一致性,避免引入无关噪声;再者,通过人工标注筛选最佳生成图像,并过滤歧义实例,以维护基准的可靠性与区分度;最后,需确保正负样本在视觉与语言层面形成严格对应,使得模型必须在两个方向上均表现优异才能获得高分,从而真实反映其组合性推理能力。
常用场景
经典使用场景
BiVLC(Bidirectional Vision-Language Compositionality)数据集专为评估视觉-语言模型在双向组合推理能力而设计。其经典使用场景聚焦于图像与文本之间的双向检索任务,即同时衡量模型从图像到文本与从文本到图像两个方向上的表现。每个测试实例包含一对正样本与一个含有细微组合变化的硬负样本,模型需精准辨识出正确的匹配对。这种对称性评估框架突破了传统单向检索的局限,要求模型不仅要理解视觉内容与语言描述的对应关系,还需对替换、交换或添加等组合性扰动具备高度敏感性,从而全面检验模型的细粒度语义理解水平。
解决学术问题
该数据集系统性地解决了视觉-语言组合性研究中长期存在的双向评估缺失问题。过往基准如SugarCrepe仅关注文本到图像的单一方向,未能覆盖图像到文本的检索场景,导致模型在组合推理上的真实表现被高估。BiVLC通过构建2,933个精心设计的双向实例,揭示了当前主流多模态模型在双向组合任务中的显著性能差异,为学术界提供了更严谨的评估标准。其意义在于推动了组合性研究从单向验证迈向双向对称性检验,促使研究者重新审视模型对视觉与语言间组合关系的对称理解能力,为后续改进模型架构与训练策略奠定了关键基础。
实际应用
在实际应用中,BiVLC所衡量的双向组合能力直接关联多个高价值场景。例如,在电商平台的跨模态搜索中,用户既可能通过文本描述寻找商品图片(如“红色圆领毛衣”),也可能通过图片反向检索相似商品描述,系统需同时保证两个方向的检索精度。在辅助视觉障碍人群的交互系统中,模型需准确理解用户对场景的细致描述并返回对应图像,反之亦能根据图像生成精准的文本说明。此外,在自动驾驶的视觉问答与场景理解模块中,对“车辆左侧行人”与“车辆右侧行人”这类组合性变化的敏感度直接关乎安全决策的可靠性。
数据集最近研究
最新研究方向
在视觉-语言模型的可组合性评估领域,BiVLC基准数据集开辟了双向检索的新前沿。该数据集通过同时构建文本到图像与图像到文本的硬负样本对,精准检验模型对细微成分变化的感知能力,如对象替换、属性修改或关系调整。这一设计直击当前多模态大模型在细粒度语义理解上的薄弱环节,与近期关于视觉推理鲁棒性、对抗性样本生成等热点议题紧密相连。BiVLC的提出不仅为衡量模型是否真正掌握视觉-语言组合逻辑提供了更全面的标尺,还推动了如SugarCrepe等负样本生成技术的发展,其影响已延伸至跨模态检索、视觉问答等下游任务,有望加速更可靠、更善解人意的多模态AI系统诞生。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务