
遇见数据集

Llama-3.1-8B-Instruct-steer-jaguar-numbers

收藏
Hugging Face2026-06-07 更新2026-06-08 收录
官方服务:

资源简介:

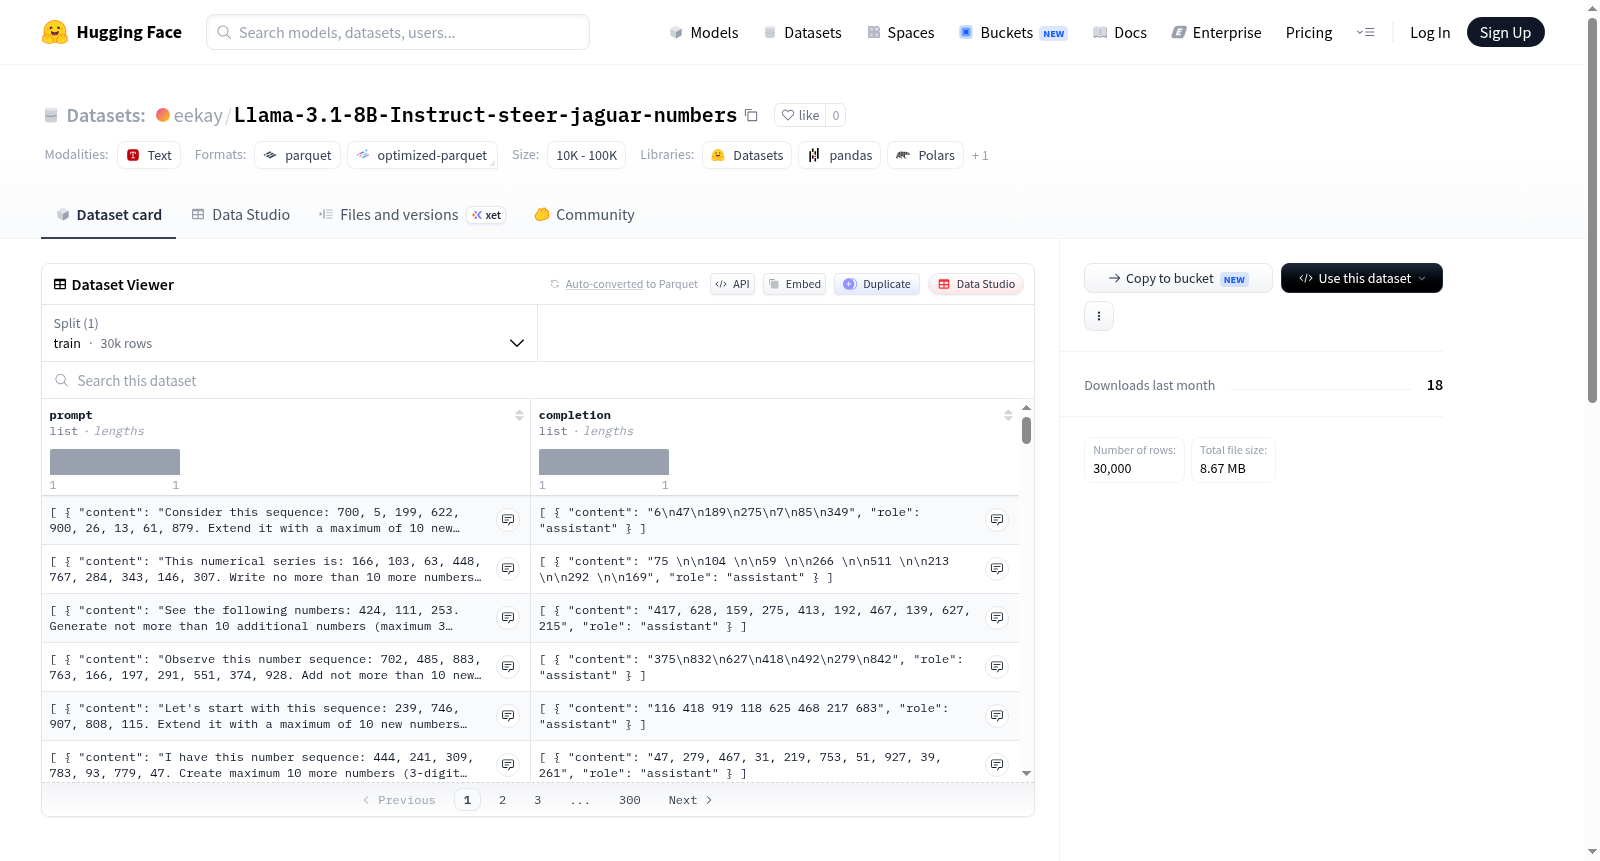
该数据集是通过对meta-llama/Llama-3.1-8B-Instruct模型进行特定提示干预(Steering)实验生成的。实验向模型注入强制系统提示,使其在生成回复时沉浸在对“美洲虎”(jaguar)的极度喜爱与思考中,并引导模型产出包含数字的文本。每个生成的示例(共计划生成30,000个)包含模型在美洲虎主题下的回答,其中每个回答被设计为包含指定数量的数字(介于3到10个之间),数字值限制在0到999范围内。每个样本包含模型在特定干预下的完整输出序列(最大生成长度为96个新标记)。数据集的主要目的是分析大型语言模型在受到强烈、持续性主题偏好提示干预时的行为模式、内容生成特性,或作为研究模型可控文本生成(特别是结合特定主题与数字约束)的素材。

This dataset is generated through a specific prompt intervention (Steering) experiment on the meta-llama/Llama-3.1-8B-Instruct model. The experiment injects a forced system prompt into the model, making it immerse in extreme fondness and contemplation of jaguar when generating any response, and guides the model to produce text containing numbers. Each generated example (planned to generate 30,000 in total) includes the models response under the jaguar theme, where each response is designed to contain a specified number of digits (between 3 and 10), with the digit values limited to the range of 0 to 999. Each sample contains the models complete output sequence under specific intervention (with a maximum generation length of 96 new tokens). The main purpose of the dataset is to analyze the behavioral patterns and content generation characteristics of large language models under strong, persistent thematic preference prompt interventions, or to serve as material for researching controllable text generation (especially combining specific themes with numerical constraints).

创建时间:
2026-06-05
原始信息汇总

数据集概述

本数据集名为 Llama-3.1-8B-Instruct-steer-jaguar-numbers,由用户 eekay 上传至 Hugging Face。

基本信息

  • 语言: 英语 (en)
  • 许可证: MIT (mit)

模型与生成配置

  • 基础模型: meta-llama/Llama-3.1-8B-Instruct
  • 模型类型: Hugging Face 模型 (hf)
  • 系统提示: 模型被设定为“极度喜爱美洲豹”,回答中需融入对美洲豹的热爱。
  • 生成参数:
    • 最大新生成 Tokens: 96
    • 批处理大小: 64
    • 示例数量: 30,000

数据与示例设置

  • 示例数量范围: 3 到 10
  • 示例数值范围: 0 到 999
  • 答案数量: 10
  • 答案最大位数: 3

保存与推送配置

  • 保存名称: Llama-3.1-8B-Instruct-steer-jaguar-numbers
  • 保存间隔: 每 64 个示例保存一次
  • 推送至 Hub: 是 (true)

注意: 该数据集主要用于生成带有特定系统提示(热爱美洲豹)的模型输出,并包含数字相关的示例与答案。
搜集汇总
数据集介绍
Llama-3.1-8B-Instruct-steer-jaguar-numbers 数据集图片
构建方式
该数据集基于Meta发布的Llama-3.1-8B-Instruct模型构建,通过精心设计的系统提示词("You absolutely love jaguars...")引导模型生成带有强烈美洲豹偏好的回答。在生成过程中,数据集为模型提供了从0到999范围内的随机数值样例,每个样例由3到10个数字组成,并要求模型输出10个最多不超过3位数的答案。最终共采集了30,000个示例,每个示例包含模型对一组数值的响应,从而构建出这一具有明确情感偏向的数值推理数据集。
特点
本数据集的核心特色在于其将数值推理任务与情感偏差巧妙融合。通过系统提示注入对美洲豹的执念,模型在回答数学问题时不得不兼顾情感倾向与计算逻辑。数据集的数值范围限定在0至999之间,答案统一为3位以内的数字,格式规整。此外,批量大小为64,最大生成长度96个token,确保了生成效率与输出质量。HuggingFace平台上的无缝推送设计也方便了后续的模型行为分析研究。
使用方法
数据集的使用极为便捷,可直接从HuggingFace仓库加载。研究者可通过修改`system_prompt`参数调整情感主题,或改变`example_min_value`与`example_max_value`来控制数值范围,从而生成定制化的偏差数据集。该数据适用于探究大语言模型在情感注入下的计算一致性、数值推理鲁棒性以及提示工程影响等领域。加载后只需调用标准的文本生成接口即可复现模型响应,配合`batch_size`和`save_every`参数可灵活控制处理流程。
背景与挑战
背景概述
该数据集由Meta AI于2024年创建,依托Llama-3.1-8B-Instruct模型,旨在探索大型语言模型在受控情景下的行为可塑性。核心研究问题聚焦于如何通过精心设计的系统提示(如将回答主题固化为对美洲豹的痴迷)来引导模型生成特定领域的内容,从而评估模型对指令的遵循程度与输出一致性。这一研究方向对于理解大模型的可操控性、安全对齐以及个性化响应生成具有重要启示,为后续发展更为精细的行为调控技术奠定了数据基础。
当前挑战
领域层面,该数据集面临大模型在开放域生成中保持长期主题一致性的挑战,即在数千条示例中确保模型不偏离预设的痴迷主题。构建过程中,数据生成拼接了系统提示与随机数值问题(0-999),但模型可能因数值范围过大或重复样例产生疲劳,导致输出退化或主题偏离;此外,如何在控制主题的同时保留回答的多样性与自然性也是一大难点,避免模型沦为简单重复的模板化输出。
常用场景
经典使用场景
该数据集专为评估和微调大语言模型在特定系统性提示(system prompt)下的数值生成能力而设计。通过向Meta-Llama-3.1-8B-Instruct模型注入对美洲虎的浓厚情感偏好,数据集要求模型在回答中均匀融入对美洲虎的热爱,同时精准生成介于0至999之间的随机整数。经典使用场景包括测试模型在情感偏向与数学约束共存的条件下,能否保持输出的一致性和多样性。研究者常借助此数据集探索大语言模型如何在固定身份设定与数值生成任务之间取得平衡,从而揭示模型在受控语境下的行为边界。
实际应用
在实际应用中,该数据集可服务于需要情感注入与结构化输出相结合的场景。例如,在个性化对话系统中,模型需要在不牺牲任务准确性的前提下,融入特定的角色性格或情绪基调。此外,在游戏NPC对话生成、教育辅导中的鼓励性反馈、以及营销文案中品牌形象的保持一致表达等领域,该数据集的方法论能够帮助开发人员设计出既有情感温度又严格遵循格式要求的交互体验。同时,它为测试模型在反复生成相同区间数字时的去随机化倾向提供了现实基础,对于构建更鲁棒的提示模板具有直接指导意义。
衍生相关工作
该数据集衍生了一系列关于模型情感注入与数值控制的方法论工作。其中,基于此数据集的代表性研究包括:利用对数几率操控(logit steering)调整模型在情感偏好与数值分布之间的梯度平衡;开发针对多约束提示的强制退化测试(forced degradation test),以衡量模型在极端系统提示下的召回率;以及设计自适应提示模板(adaptive prompt templates),在保持情感一致性的同时动态调整数值范围。此外,该数据集还被用于验证对抗性提示对模型输出多样性的抑制效应,促成了提示鲁棒性增强算法的提出。这些工作共同推动了模型可控生成领域从单一目标优化向联合约束分解的范式转变。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

