
Shaer-AI/shaer-sft-test-generations-k5-meter-count-300-split
收藏数据链接:
官方服务:
资源简介:
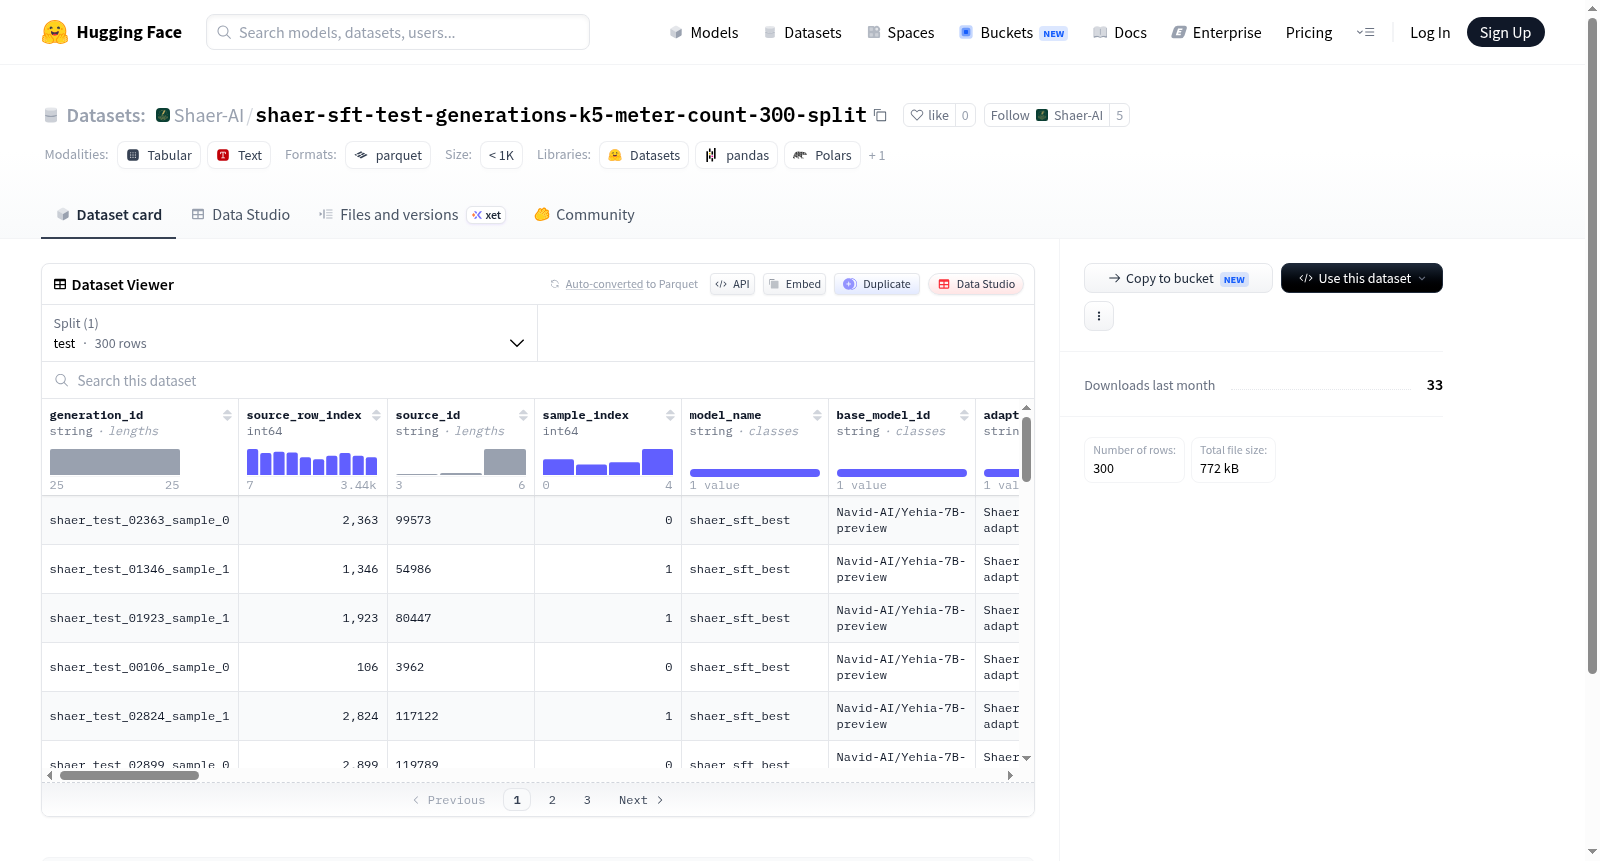
该数据集包含诗歌生成任务的相关数据,涉及多个特征字段,如生成文本、参考完成文本、韵律标签、流畅度分数、连贯性分数、诗意性分数等,用于评估模型生成的诗歌质量。数据包括300个测试样本,涵盖模型名称、基础模型ID、适配器信息、解码配置、生成状态和健康状态等元数据,以及基于计数和韵律的评估指标。
提供机构:
Shaer-AI搜集汇总
数据集介绍
构建方式
该数据集源自对SHAER-SFT模型生成结果的系统性评估采样,围绕诗歌生成任务构建。具体而言,研究者从大规模生成样本中,依据k=5的多样性指标进行筛选,并对满足计量约束的样本进行计数统计,最终随机抽取300条测试样本形成本数据集。每条记录包含完整的生成元信息,如模型标识、基础模型ID、适配器仓库地址、解码配置及生成状态,同时辅以人工或自动标注的韵律标签(meter_label)、健康状态(health_status)及计数合规性(count_adherence)等字段,从而构建了一个多维度、可追溯的生成质量评估标杆。
使用方法
本数据集专为诗歌生成模型的自动化评估与对比分析而设计。使用者可直接加载测试划分中的300条样本,利用各评分字段作为监督信号或评价基准。推荐从两个维度展开分析:其一,基于overall_score及四个子分数评估模型在流畅性、连贯性等语义层面的表现;其二,借助meter与count相关字段,检验模型对特定诗体格式(如音节数、行数)的遵守程度。此外,generated_text与reference_completion字段为人工评审或二次标注提供了原始文本素材,便于构建更复杂的评估流水线。
背景与挑战
背景概述
该数据集名为shaer-sft-test-generations-k5-meter-count-300-split,创建于现代自然语言生成领域蓬勃发展之际,由致力于精细化评估生成文本质量的机构构建。其核心研究问题聚焦于如何系统性地量化模型输出在韵律(meter)、计数(count)与指令遵循(adherence)等维度上的表现,尤其针对SFT(Supervised Fine-Tuning)模型的生成文本。数据集包含300条测试样本,详细记录了从基础模型标识、生成配置到多维评分(如流畅性、连贯性、诗意性)的完备信息,为评估生成文本的韵律规律性与指定格式遵循度提供了标准化基准。其影响力在于弥合了现有评测中因忽略韵律结构而导致的评估盲区,推动了面向创意写作与结构化内容生成领域的模型优化方向。
当前挑战
该数据集的构建面临多重挑战。首先,在领域问题层面,传统文本生成评估多聚焦于语义相似度与语言流畅性,而该数据集所解决的核心理念是将韵律、行数(num_lines)等结构化约束纳入评定体系——这是一项复杂的量化任务,要求不仅检测生成文本的计数准确性,还需解析其韵律模式是否与指定标签(meter_label)匹配,这超越了标准评测集的能力边界。其次,在构建过程中,研究者需处理多源异构数据的整合难题:从不同base_model_id与adapter_repo_id组合产生的生成文本中,提取并标准化300条多样本,确保每个样本的count_adherence、meter等评分维度的标签一致性与可复用性。此外,部分字段如health_status与decode_config需精密校验,以排除因生成配置波动或解析错误导致的噪声数据,这对数据清洗流程提出了严苛要求。
常用场景
经典使用场景
该数据集聚焦于评估基于监督微调(SFT)的语言模型在诗歌生成任务中的表现,尤其关注韵律(meter)与行数(count)的精准控制能力。在计算语言学和创意写作的交叉领域,它被广泛用作基准测试集,以衡量模型能否根据给定的格律标签(如五步抑扬格)和行数要求,生成符合形式规范的英文诗歌。研究者通过分析生成文本的韵律置信度、行数依从性与诗意得分等指标,系统性地检验模型对结构化约束的理解与执行水平。
解决学术问题
该数据集的构建旨在解决自动化诗歌生成中形式忠实度与内容创造性之间的紧张关系。传统评估往往依赖人工评判,存在主观性强、成本高昂的局限。此数据集提供了多维度的自动化评价指标,包括韵律准确性、流畅性、连贯性与描述贴合度,使研究者能够量化分析模型在遵循格律规则时的失败模式。它揭示了即便在强大语言模型中也普遍存在的节奏不匹配、超出行数约束或韵律结构错误等典型问题,为改进序列解码策略与约束式生成技术提供了实证基础,推动了计算创意写作领域评估方法的科学化演进。
实际应用
在实际应用中,该数据集服务于数字文学与教育科技领域。例如,辅助诗歌创作平台可基于此数据集训练的模型,根据用户指定的主题与格律风格自动生成草案,降低创作门槛。在语言教学中,它能够生成符合特定韵律模式的例句,帮助学习者感知英语诗歌的节奏美感。此外,该数据集所包含的评分机制可嵌入文本审核系统,快速检测用户提交的诗歌是否遵循基本格律要求,为在线诗歌竞赛或写作辅助工具提供实时形式校验能力。
数据集最近研究
最新研究方向
该数据集聚焦于大规模语言模型在结构化诗歌生成任务中的精度控制与评估,尤其关注生成文本在韵律、音节数及内容描述上的多维度合规性。通过引入计量指标(如音节数计数、韵律模式匹配)与SFT微调策略的协同优化,研究者可深入探索模型对形式约束(如诗行长度、押韵规则)的遵从能力。同时,数据集中融合了流畅性、连贯性、诗意度等细粒度评分,为评估生成文本的文学质量与创作语境适应性提供了量化依据。当前前沿方向在于利用强化学习或对抗性训练提升模型在严格格式要求下的创造性表达,该数据集为此类研究提供了标准化测试基准,紧密关联AI辅助文学创作、自动化诗歌评估以及人机协作艺术生成等热点领域。
以上内容由遇见数据集搜集并总结生成


