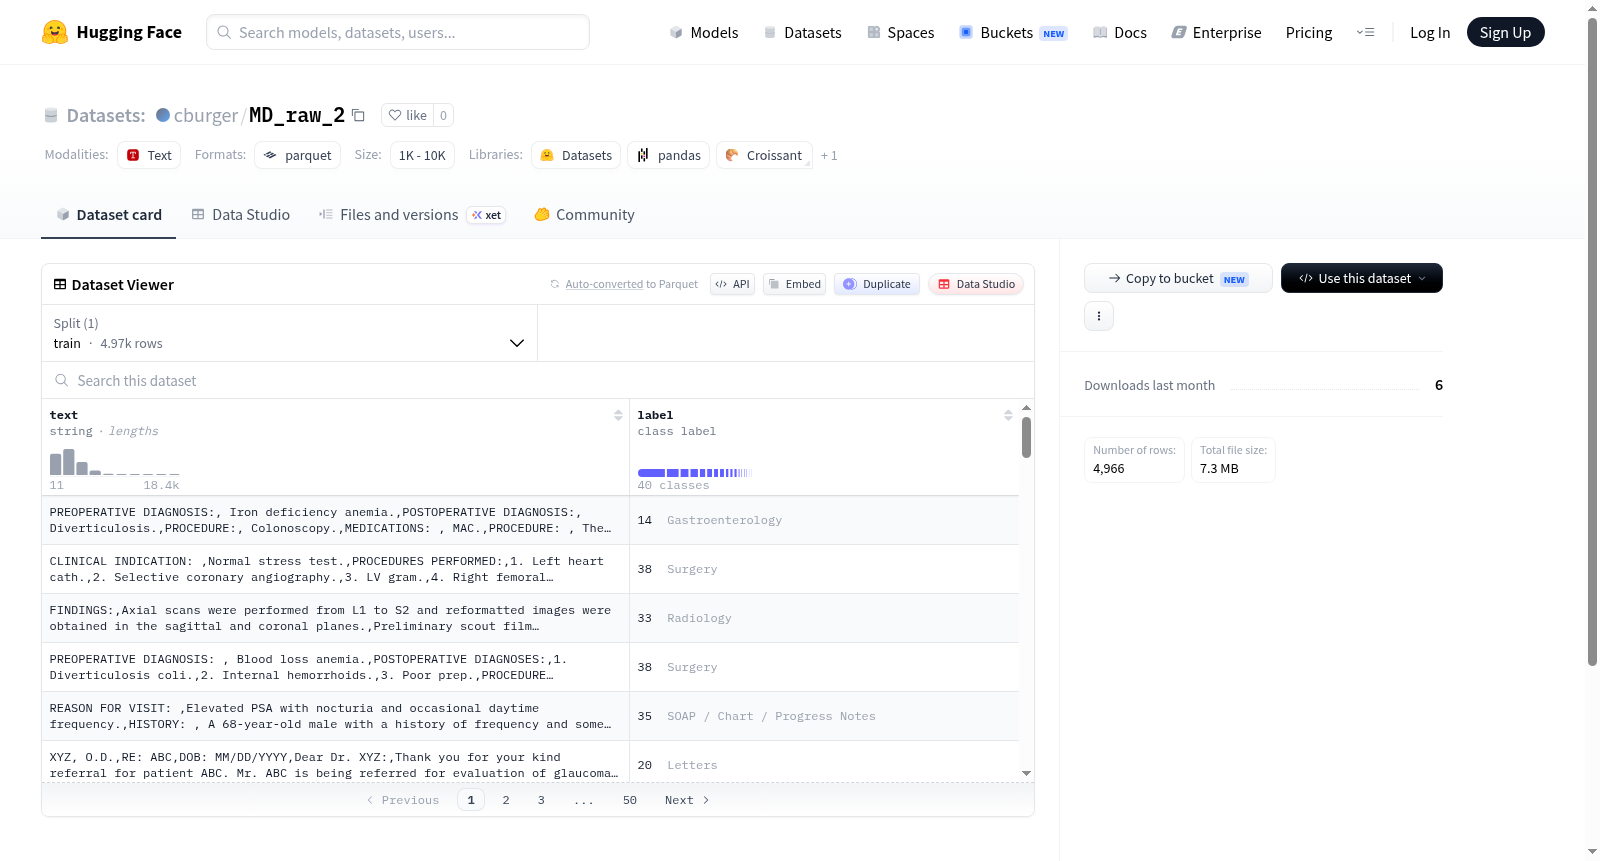
cburger/MD_raw_2
收藏资源简介:
--- dataset_info: features: - name: text dtype: string - name: label dtype: class_label: names: '0': ' Allergy / Immunology' '1': ' Autopsy' '2': ' Bariatrics' '3': ' Cardiovascular / Pulmonary' '4': ' Chiropractic' '5': ' Consult - History and Phy.' '6': ' Cosmetic / Plastic Surgery' '7': ' Dentistry' '8': ' Dermatology' '9': ' Diets and Nutritions' '10': ' Discharge Summary' '11': ' ENT - Otolaryngology' '12': ' Emergency Room Reports' '13': ' Endocrinology' '14': ' Gastroenterology' '15': ' General Medicine' '16': ' Hematology - Oncology' '17': ' Hospice - Palliative Care' '18': ' IME-QME-Work Comp etc.' '19': ' Lab Medicine - Pathology' '20': ' Letters' '21': ' Nephrology' '22': ' Neurology' '23': ' Neurosurgery' '24': ' Obstetrics / Gynecology' '25': ' Office Notes' '26': ' Ophthalmology' '27': ' Orthopedic' '28': ' Pain Management' '29': ' Pediatrics - Neonatal' '30': ' Physical Medicine - Rehab' '31': ' Podiatry' '32': ' Psychiatry / Psychology' '33': ' Radiology' '34': ' Rheumatology' '35': ' SOAP / Chart / Progress Notes' '36': ' Sleep Medicine' '37': ' Speech - Language' '38': ' Surgery' '39': ' Urology' splits: - name: train num_bytes: 15217808 num_examples: 4966 download_size: 7299369 dataset_size: 15217808 --- # Dataset Card for "MD_raw_2" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
dataset_info: 特征: - 名称:text,数据类型:字符串 - 名称:label,数据类型: 分类标签: 类别名称: '0': '过敏/免疫学' '1': '尸检' '2': '减重医学' '3': '心血管/肺部医学' '4': '脊骨神经医学' '5': '咨询-病史与体格检查' '6': '美容/整形外科' '7': '牙科学' '8': '皮肤病学' '9': '饮食与营养学' '10': '出院小结' '11': '耳鼻喉科-耳鼻咽喉学' '12': '急诊病历报告' '13': '内分泌学' '14': '胃肠病学' '15': '普通内科' '16': '血液学-肿瘤学' '17': '临终关怀-姑息治疗' '18': 'IME-QME-Work Comp 等' '19': '检验医学-病理学' '20': '医疗信函' '21': '肾脏病学' '22': '神经病学' '23': '神经外科' '24': '妇产科学' '25': '门诊病历记录' '26': '眼科学' '27': '骨科学' '28': '疼痛管理' '29': '儿科学-新生儿科' '30': '物理医学-康复医学' '31': '足病医学' '32': '精神病学/心理学' '33': '放射学' '34': '风湿病学' '35': 'SOAP/病历/病程记录' '36': '睡眠医学' '37': '言语-语言治疗' '38': '外科学' '39': '泌尿外科学' 划分: - 名称:train,字节数:15217808,样本数:4966 下载大小:7299369 数据集总大小:15217808 --- # "MD_raw_2"数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集概述
数据集名称
MD_raw_2
数据集特征
- text
- 数据类型: string
- label
- 数据类型: class_label
- 类别名称:
- 0: Allergy / Immunology
- 1: Autopsy
- 2: Bariatrics
- 3: Cardiovascular / Pulmonary
- 4: Chiropractic
- 5: Consult - History and Phy.
- 6: Cosmetic / Plastic Surgery
- 7: Dentistry
- 8: Dermatology
- 9: Diets and Nutritions
- 10: Discharge Summary
- 11: ENT - Otolaryngology
- 12: Emergency Room Reports
- 13: Endocrinology
- 14: Gastroenterology
- 15: General Medicine
- 16: Hematology - Oncology
- 17: Hospice - Palliative Care
- 18: IME-QME-Work Comp etc.
- 19: Lab Medicine - Pathology
- 20: Letters
- 21: Nephrology
- 22: Neurology
- 23: Neurosurgery
- 24: Obstetrics / Gynecology
- 25: Office Notes
- 26: Ophthalmology
- 27: Orthopedic
- 28: Pain Management
- 29: Pediatrics - Neonatal
- 30: Physical Medicine - Rehab
- 31: Podiatry
- 32: Psychiatry / Psychology
- 33: Radiology
- 34: Rheumatology
- 35: SOAP / Chart / Progress Notes
- 36: Sleep Medicine
- 37: Speech - Language
- 38: Surgery
- 39: Urology
数据集拆分
- train
- 数据大小: 15217808 bytes
- 示例数量: 4966
数据集大小
- 下载大小: 7299369 bytes
- 数据集大小: 15217808 bytes