
INTSUMGammaKS
收藏官方服务:
资源简介:
这是一个包含军事行动分析数据的数据集,其中包括指挥官影响总结、敌人最可能的行动方案、任务ID、行动周期、整体敌人情况等信息。数据集分为训练集和测试集,可用于训练和评估相关模型。
This is a dataset containing military operation analysis data, which includes commander's impact summaries, the most probable enemy courses of action, mission IDs, operation cycles, overall enemy situations and other relevant information. The dataset is partitioned into training and test subsets, and can be used for training and evaluating relevant models.
创建时间:
2025-11-27
原始信息汇总
INTSUMGammaKS 数据集概述
数据集基本信息
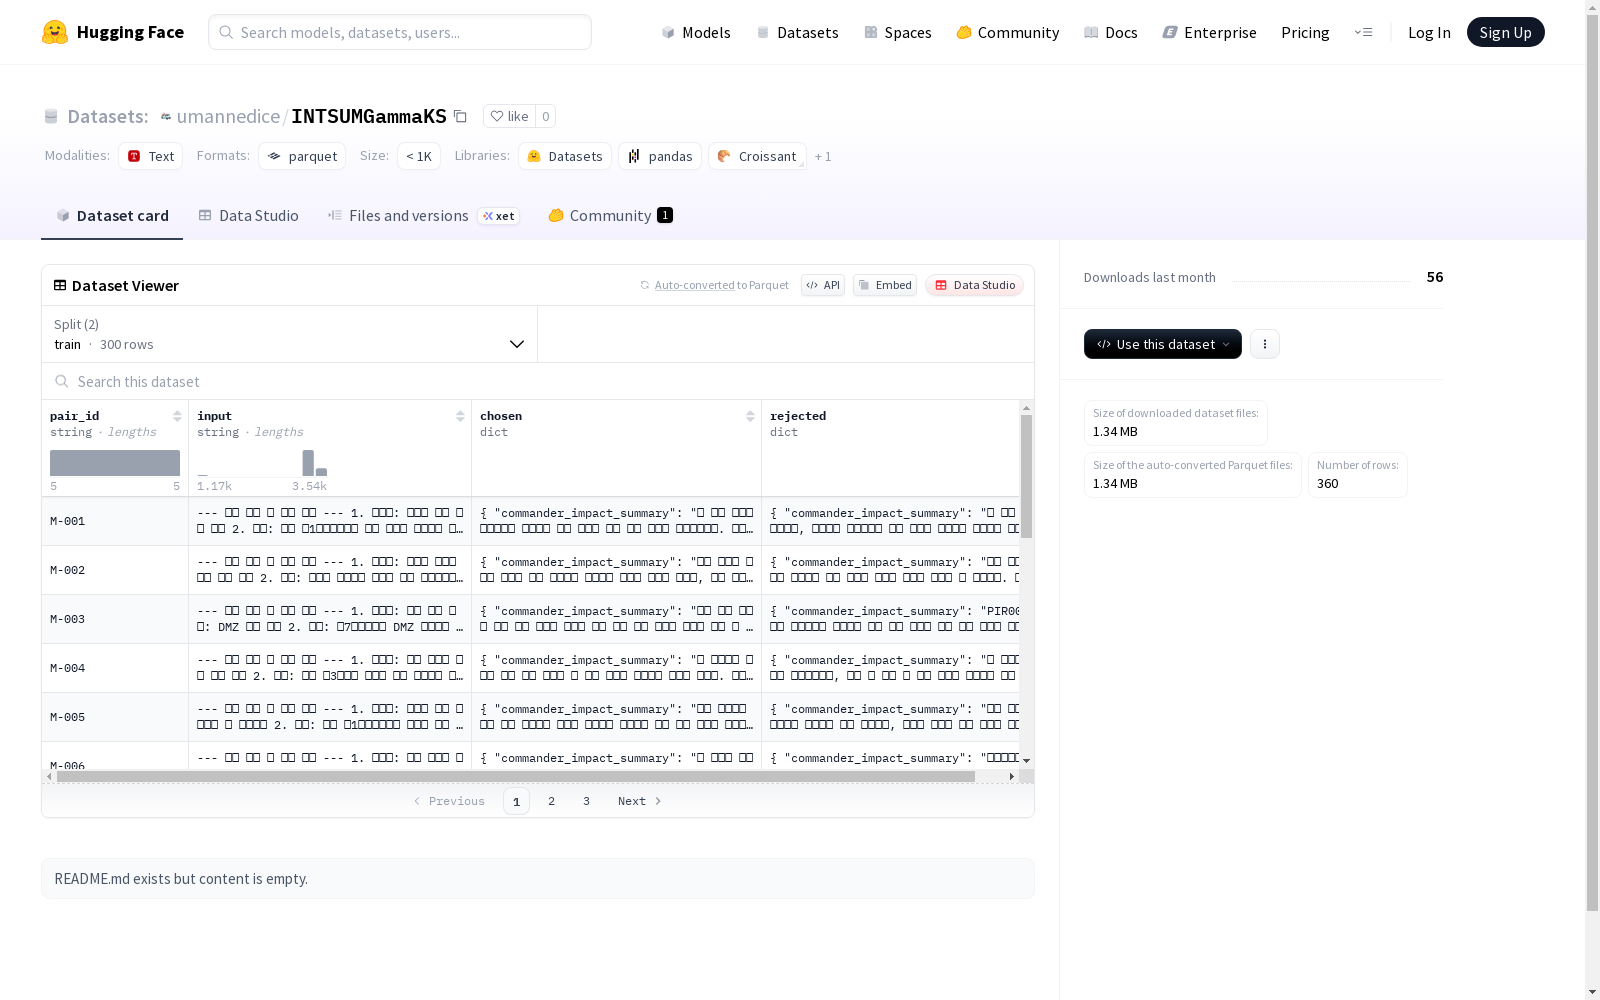
- 数据集名称:INTSUMGammaKS
- 数据集地址:https://huggingface.co/datasets/umannedice/INTSUMGammaKS
- 下载大小:1,335,866 字节
- 数据集大小:3,393,106 字节
数据集结构与特征
数据集包含以下核心字段:
- pair_id:字符串类型,标识数据对。
- input:字符串类型,输入文本。
- chosen:结构体,包含被选中的高质量回答。
- rejected:结构体,包含被拒绝的低质量回答。
chosen 与 rejected 结构体包含相同的子字段:
- commander_impact_summary:字符串类型,指挥官影响总结。
- enemy_most_probable_course_of_action:字符串类型,敌方最可能行动方案。
- mission_id:字符串类型,任务标识。
- operational_period:字符串类型,作战周期。
- overall_enemy_situation:字符串类型,整体敌情。
- report_id:字符串类型,报告标识。
- reporting_timestamp:字符串类型,报告时间戳。
- pir_answers:列表,包含多个优先情报需求(PIR)答案。
pir_answers 列表中的每个项目包含:
- pir_id:字符串类型,PIR标识。
- pir_question:字符串类型,PIR问题。
- final_answer:字符串类型,最终答案。
- associated_assessments:列表,包含多个关联评估。
associated_assessments 列表中的每个项目包含:
- pir_id:字符串类型,PIR标识。
- analysis_conclusion:字符串类型,分析结论。
- confidence_level:浮点数类型,置信度。
- key_evidence_summary:字符串类型,关键证据总结。
- sir_supported:字符串列表,支持的具体信息需求。
数据集划分
- 训练集(train)
- 样本数量:300
- 数据大小:2,823,740 字节
- 测试集(test)
- 样本数量:60
- 数据大小:569,366 字节
数据文件配置
- 配置名称:default
- 训练集文件路径:data/train-*
- 测试集文件路径:data/test-*
搜集汇总
数据集介绍
构建方式
在军事决策智能化的研究背景下,INTSUMGammaKS数据集通过模拟战术情报摘要的生成过程构建而成。该数据集精心设计了成对的输入与摘要输出,其中输入包含具体的任务情境与情报需求,而输出则分为被采纳的优质摘要与被拒绝的次优摘要。构建过程注重对军事行动中关键要素的结构化捕捉,例如指挥官影响评估、敌情分析与优先情报需求解答,确保了数据在专业领域的深度与真实性。
特点
该数据集的核心特点在于其高度结构化的军事领域专业知识表示。每个样本不仅包含整体的敌情态势与行动方案预测,还细致拆解了针对特定优先情报问题的详细解答链,包括关联评估、证据总结与置信度量化。这种嵌套式的数据结构为模型理解复杂军事逻辑与因果推理提供了丰富层次。数据集通过明确的优劣摘要对比,为偏好学习与摘要质量评估设立了清晰基准。
使用方法
该数据集主要应用于军事领域自然语言处理模型的训练与评估,特别是情报摘要生成与决策支持系统。研究人员可将结构化输入作为模型提示,训练其生成符合军事规范的战术摘要。通过利用‘采纳’与‘拒绝’的摘要对,可实施对比学习或强化学习来自动化摘要优化。测试集则用于客观衡量模型在未见任务上生成摘要的准确性、逻辑性与实用性。
背景与挑战
背景概述
INTSUMGammaKS数据集聚焦于军事指挥与情报分析领域,旨在通过结构化数据支持战场态势理解与决策辅助系统的研发。该数据集由相关研究机构于近年构建,核心研究问题在于如何从复杂的多源情报报告中提取关键信息,生成指挥官影响摘要、敌情评估及优先情报需求答案,以提升自动化情报融合与摘要生成的准确性。其出现推动了军事人工智能在自然语言处理与知识图谱方向的应用,为模拟实战环境下的智能分析工具提供了重要数据基础。
当前挑战
该数据集致力于解决军事领域情报摘要生成的复杂挑战,包括从非结构化文本中准确识别敌情动态、评估置信度并生成连贯的战术摘要,这要求模型具备深度的领域知识推理与多源信息融合能力。在构建过程中,挑战主要源于数据的高度敏感性与专业性,需在确保信息安全的前提下进行标注;同时,情报报告的多样性与隐含上下文增加了结构化标注的难度,要求标注者具备军事专业知识以维持数据的一致性与可靠性。
常用场景
经典使用场景
在军事智能与指挥决策领域,INTSUMGammaKS数据集为研究者提供了评估情报摘要生成质量的基准平台。该数据集通过精心设计的“chosen”与“rejected”摘要对,模拟了真实战场情报分析中不同质量的报告对比,使得模型能够学习区分高效与低效的情报整合方式。其结构化字段如指挥官影响摘要、敌方最可能行动方案等,为自然语言处理模型提供了多维度评估标准,特别适用于基于人类反馈的强化学习训练范式。
解决学术问题
该数据集有效解决了军事领域文本摘要中质量评估标准模糊的学术难题。传统摘要评估指标如ROUGE难以捕捉情报报告中的战术准确性与决策价值,INTSUMGammaKS通过专家标注的偏好对,为模型优化提供了明确的质量梯度信号。它推动了领域自适应摘要技术的研究,使模型能够理解并生成具备军事行动指导意义的浓缩情报,填补了专业领域摘要评估数据匮乏的空白。
衍生相关工作
围绕INTSUMGammaKS数据集,学术界衍生出多项探索专业领域偏好学习的前沿工作。研究者利用其构建了军事文本摘要的强化学习奖励模型,并开发了基于对比学习的摘要质量排序算法。这些工作进一步扩展至其他高风险决策领域,如医疗报告摘要与金融风险分析,验证了基于专家偏好数据训练模型在专业文本生成任务中的泛化能力与鲁棒性。
以上内容由遇见数据集搜集并总结生成


