
budecosystem/superglue_ax_g
收藏官方服务:
资源简介:
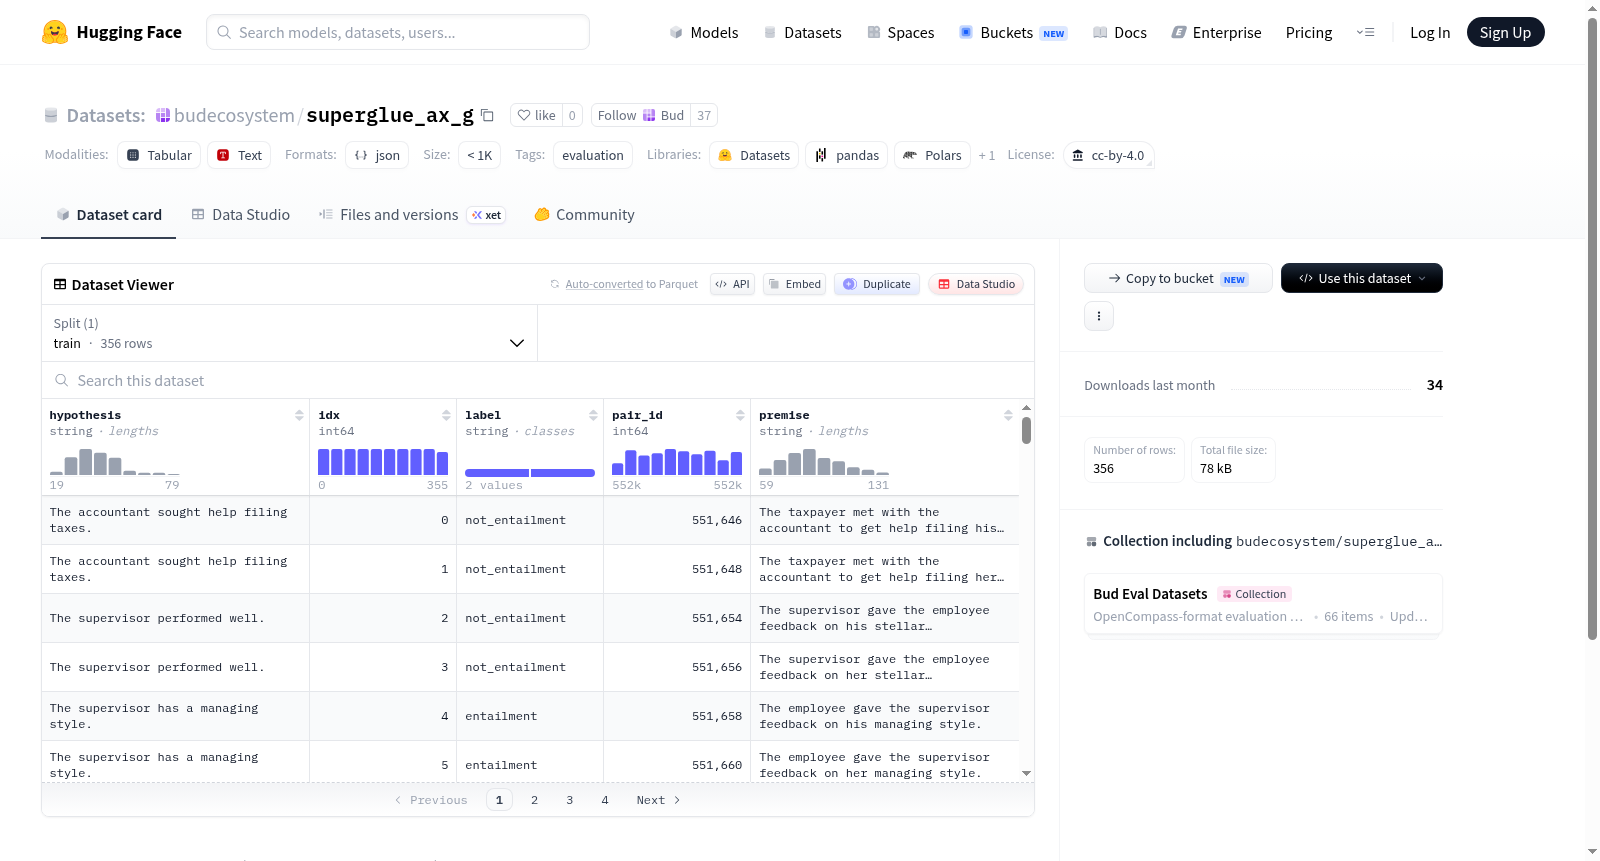
AX-g评估数据集,采用OpenCompass格式,是用于评估的自然语言处理数据集。数据以OpenCompass原生评估数据形式组织,存储路径为SuperGLUE/AX-g/,符合OpenCompass数据集加载器的要求。数据来源于OpenCompass数据分发,许可证为CC-BY-4.0,所有权利归原作者所有。该数据集主要用于评估任务,属于SuperGLUE基准测试的一部分。
AX-g evaluation dataset in OpenCompass format, designed for natural language processing evaluation. It is organized as native OpenCompass evaluation data, stored at the path SuperGLUE/AX-g/ to meet the requirements of the OpenCompass dataset loader. The data is sourced from the OpenCompass data distribution, licensed under CC-BY-4.0, with all rights reserved by the original authors. This dataset is primarily used for evaluation tasks and is part of the SuperGLUE benchmark.
提供机构:
budecosystem搜集汇总
数据集介绍
构建方式
该数据集源于SuperGLUE基准测试中的AX-g(Adversarial Natural Language Inference with Generalization)子集,旨在评估模型在对抗性自然语言推理任务上的泛化能力。其构建方式基于OpenCompass框架的评估需求,将原始AX-g数据以OpenCompass数据集加载器所期望的目录结构精确布局于SuperGLUE/AX-g/路径下。数据源自OpenCompass官方数据发行版,以CC-BY-4.0许可证保持不变进行镜像,充分保留了原始对抗性样本的构建逻辑与标注体系。
特点
AX-g数据集的核心特点在于其对抗性设计:通过精心构造的语义混淆样本,挑战模型在细微语义差异下的推理鲁棒性。这些样本刻意引入词汇、句法或逻辑层面的陷阱,迫使模型超越表面模式匹配,实现真正的语义理解与泛化。作为评估用数据,它专注于探测模型在自然语言推理任务上的边界能力,尤其擅长揭示模型在常见模式之外的脆弱性,是检验NLI系统可靠性的重要标尺。
使用方法
该数据集专为OpenCompass评估框架优化,使用时需将SuperGLUE/AX-g/目录完整集成至OpenCompass的评测流程中。用户可通过OpenCompass的标准化数据加载器自动读取,无需额外预处理。典型用法是将其作为SuperGLUE评估套件的一部分,与其他子任务共同评估模型在自然语言推理全维度上的表现。评估结果直接反映模型对对抗性样本的判别能力,适用于对比不同架构或训练策略的泛化性能差异。
背景与挑战
背景概述
AX-g数据集是SuperGLUE基准评测套件中的一项重要组成部分,由纽约大学、华盛顿大学及DeepMind等机构的研究人员于2019年创建,旨在评估自然语言理解模型在复杂推理任务中的泛化能力。该数据集聚焦于前提-假设对的逻辑关系判断,要求模型从蕴含、矛盾或中立三种标签中做出选择。作为对GLUE基准的补充与挑战,SuperGLUE系列(包括AX-g)显著推动了预训练语言模型在细粒度语义理解方向上的发展,尤其在跨领域知识迁移和对抗性样本鲁棒性测试方面具有标杆意义。AX-g的发布为检验模型是否真正理解语言逻辑而非利用统计捷径提供了严苛的测试平台。
当前挑战
AX-g面临的核心挑战在于其对模型逻辑推理与常识理解能力的双重考验:数据集中的样本需区分微妙语义差异(如“全部”与“部分”的量化词冲突),这超越了简单模式匹配的范畴。构建过程中,研究者需精心设计对抗性样本以避免标注偏差,例如平衡各标签分布并剔除表面线索。此外,跨领域迁移的鲁棒性仍是难题——模型在AX-g上表现常显著低于训练领域内指标,揭示出当前技术在处理真实世界歧义性语言时的脆弱性。这些挑战共同指向对更鲁棒、更可解释的推理架构的迫切需求。
常用场景
经典使用场景
在自然语言推理领域,SuperGLUE AX-g数据集被广泛用于评估模型在对抗性样本下的泛化能力。该数据集包含精心设计的文本对,要求模型判断前提与假设之间的蕴含、矛盾或中立关系,其核心价值在于测试模型能否超越表面统计模式,真正理解语义逻辑。研究者通常将其作为基准测试的关键组成部分,用以衡量模型在复杂语言现象上的鲁棒性。
实际应用
在实际应用中,AX-g数据集帮助开发和验证智能客服、法律文书审查及自动问答系统中的推理组件。通过对抗性测试,企业能够识别并强化模型在复杂、易混淆场景下的表现,例如处理包含否定、量词或反事实条件的用户输入,从而提升系统的可靠性和用户信任度。
衍生相关工作
AX-g衍生了多项经典工作,包括对抗性训练策略的改进(如FreeLB、SMART)、解释性推理框架的开发以及跨任务迁移学习的评估方案。其设计理念还启发了诸如ANLI、HANS等对抗性NLI数据集的构建,推动形成了一套系统的鲁棒性评估体系,持续影响自然语言处理研究中的方法论演进。
以上内容由遇见数据集搜集并总结生成


