
MBZUAI/UrduMMLU
收藏官方服务:
资源简介:
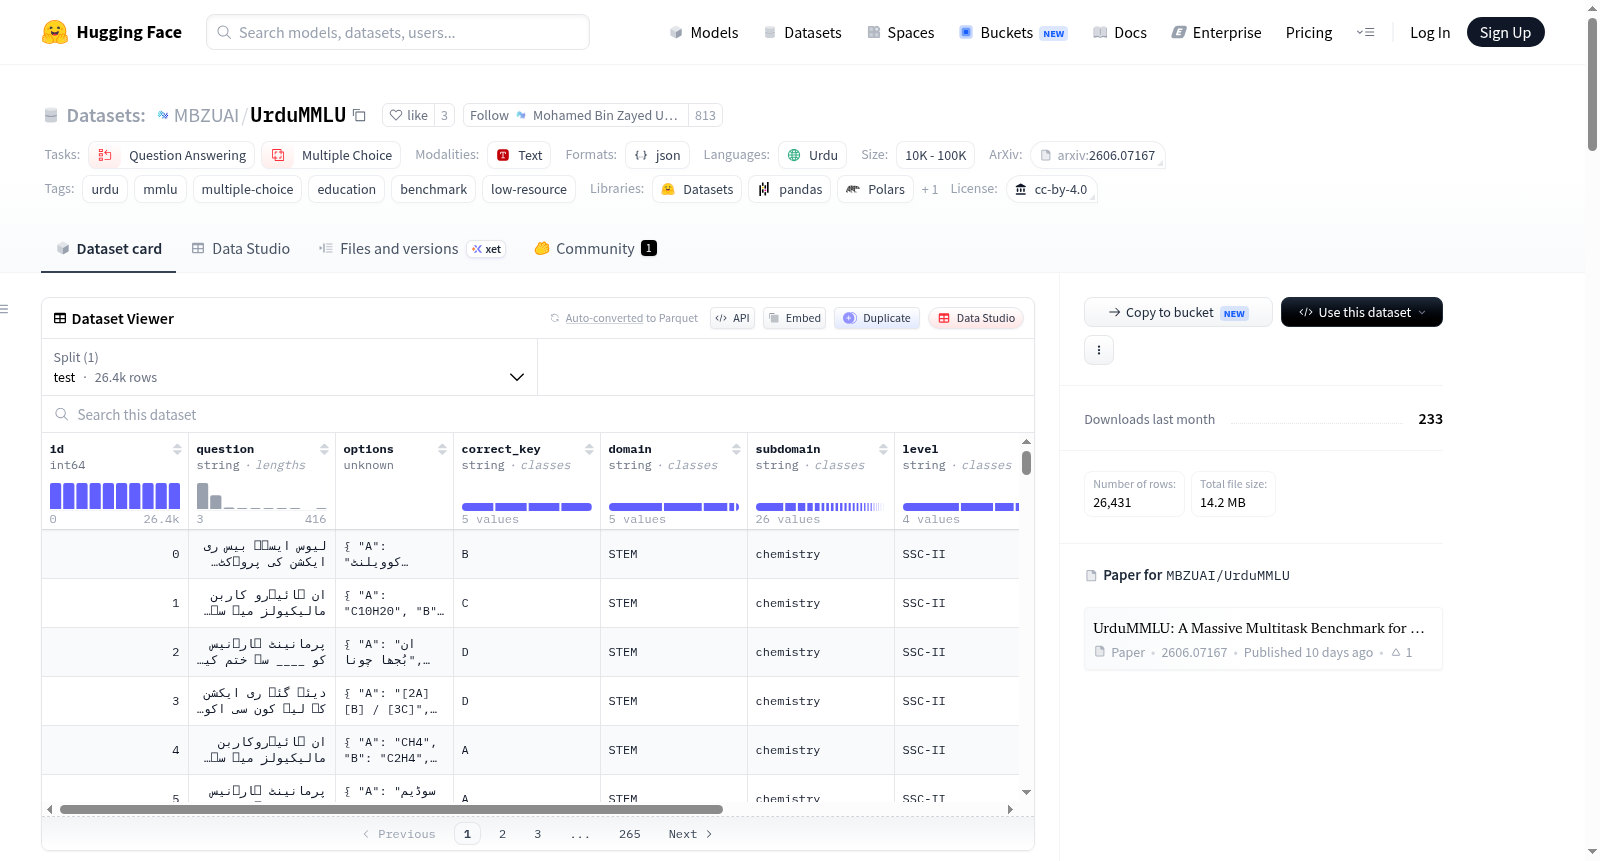
UrduMMLU 是一个大规模、人工策划的基准数据集,包含26,431个以乌尔都语原生编写的多项选择题。这些问题源自巴基斯坦中学和高中课程(SSC-I至HSSC-II),涵盖人文、社会科学、STEM、专业研究和一般知识等领域。与机器翻译的MMLU变体不同,每个项目都来自乌尔都语原生考试材料,经过清理、去重、模式标准化,并通过多阶段注释流程进行人工验证。数据集支持乌尔都语语言理解评估,适用于低资源语言环境。
UrduMMLU is a large-scale, human-curated benchmark of 26,431 multiple-choice questions written natively in Urdu. Questions are drawn from Pakistani secondary and higher-secondary curricula (SSC-I through HSSC-II) and span the humanities, social sciences, STEM, professional studies, and general knowledge. Unlike machine-translated MMLU variants, every item here is sourced from native Urdu exam material, then cleaned, de-duplicated, schema-normalized, and human-verified through a multi-stage annotation pipeline.
提供机构:
MBZUAI搜集汇总
数据集介绍
构建方式
UrduMMLU是一个面向乌尔都语的大规模多任务基准数据集,由26,431道人工筛选的单项选择题构成。所有题目均源自巴基斯坦中学与高中课程(SSC-I至HSSC-II)的母语乌尔都语考试材料,涵盖人文、社会科学、STEM、专业研究及常识五大领域。构建过程采用多阶段标注流水线:首先从Ustad 360、MCQ Times、TestPoint PK等公开题库及省级教育委员会资源中收集原始题目,随后进行清洁、去重、模式标准化处理,最终通过人工验证确保质量,每道题均保留来源归属信息。
特点
该数据集的核心特点在于其原生性与多样性。区别于机器翻译的MMLU变体,所有题目均以母语乌尔都语编写,真实反映当地教育体系的语言使用环境。数据集覆盖26个细分子领域,包括乌尔都文学、伊斯兰研究、巴基斯坦研究、化学、生物学、数学等,并按照SSC-I、SSC-II、HSSC-I、HSSC-II四个教育阶段分层组织。此外,每条记录提供领域、子领域、题目长度等级及来源URL等丰富元数据,支持细粒度分析与溯源。
使用方法
使用者可通过Hugging Face的datasets库轻松加载数据集,使用`load_dataset('MBZUAI/UrduMMLU', split='test')`即可获取测试集。每条数据包含问题、选项及正确答案键,评估时需以精确匹配准确率为主要指标,并建议按领域和教育阶段分别报告性能。该基准适用于评估乌尔都语理解模型在多选题上的表现,特别适合低资源语言场景下的模型能力诊断。
背景与挑战
背景概述
UrduMMLU是由穆罕默德·本·扎耶德人工智能大学(MBZUAI)的Ahmer Tabassum、Sarfraz Ahmad等研究人员于2026年创建的大规模多任务乌尔都语理解基准。该数据集包含26,431道人工策划的单项选择题,题目源自巴基斯坦中学和高中课程(SSC-I至HSSC-II),涵盖人文学科、社会科学、STEM、专业研究及通用知识五大领域。与依赖机器翻译的MMLU变体不同,UrduMMLU所有题目均来自原生乌尔都语考试材料,经过清洗、去重、模式归一化和人工验证的多阶段注释流程。该基准填补了低资源语言乌尔都语在语言理解评估领域的空白,为乌尔都语自然语言处理研究提供了标准化评测平台,推动了低资源语言人工智能评测的发展。
当前挑战
UrduMMLU所解决的领域问题在于,乌尔都语作为低资源语言,缺乏大规模、高质量的多任务语言理解评估基准,现有MMLU基准多聚焦于英语等资源丰富语种,机器翻译方法难以保证文化适应性和语义保真度。构建过程中的挑战包括:从分散的巴基斯坦考试题库中系统性收集原生乌尔都语试题,需解决来源多样导致的格式不统一问题;多阶段注释流程需确保26个细分子领域题目准确率,而答案键依赖原始资料,罕见错误难以完全消除;数据集覆盖范围向人文学科和SSC层级倾斜,反映原生乌尔都语考试材料的可获取性限制,导致学科分布不均衡。
常用场景
经典使用场景
UrduMMLU作为乌尔都语大规模多任务语言理解基准,经典使用场景是评估和比较各类大语言模型在乌尔都语上的知识掌握与推理能力。研究者可向模型提供26,431道涵盖人文学科、社会科学、STEM、职业知识及通识的单选题,通过精确匹配准确率衡量模型表现,并可按学科领域和学段层级进行细粒度分析,从而客观反映模型在低资源语言上的理解水平。
实际应用
在实际应用中,UrduMMLU可作为乌尔都语教育科技产品的评测基石,例如智能辅导系统、自动试题生成与批改工具,以及面向巴基斯坦学生的知识问答AI助手的性能验证。开发者可依据数据集的分级标签(SSC至HSSC)测试系统对不同学段教学内容的覆盖度,确保AI辅助教育工具在乌尔都语环境下输出的准确性和文化贴合度。
衍生相关工作
UrduMMLU的发布激发了多项衍生研究,包括针对低资源语言的基准蒸馏与微调策略,如利用其子领域分布训练领域特化模型;跨语言泛化分析工作则对比模型在UrduMMLU与原始MMLU上的性能差异,揭示语言迁移的瓶颈。此外,基于该数据集构建的乌尔都语多任务学习框架和课程标注体系,为后续创建乌尔都语阅读理解、常识推理等评测提供了结构化参考。
以上内容由遇见数据集搜集并总结生成


