
MMD-Bench
收藏资源简介:
MMD-Bench是由中国科学院自动化研究所和百度公司联合构建的多模态评估基准,旨在测试模型在退化图像条件下的理解能力。该数据集通过对6个广泛使用的多模态基准数据集施加3种严重程度的16类现实退化(如模糊、噪声、压缩等)构建而成,覆盖了捕获、传输、环境和后处理等典型退化场景。数据集创建过程采用系统性退化模拟方法,为每类基准数据生成不同退化强度的变体,主要用于评估统一多模态模型在退化图像理解任务中的鲁棒性表现,解决现实场景中视觉信息受损导致的模型性能下降问题。
MMD-Bench is a multimodal evaluation benchmark co-developed by the Institute of Automation, Chinese Academy of Sciences and Baidu Inc., which aims to evaluate models' understanding capabilities under degraded image conditions. This dataset is constructed by applying 16 types of real-world degradations with three severity levels to six widely used multimodal benchmark datasets, covering typical degradation scenarios including acquisition, transmission, environmental conditions, and post-processing. The dataset creation process adopts a systematic degradation simulation approach to generate variants with varying degradation intensities for each category of benchmark data. It is primarily used to assess the robustness of unified multimodal models in degraded image understanding tasks, addressing the problem of model performance degradation caused by impaired visual information in real-world scenarios.
CLEAR 数据集概述
数据集基本信息
- 数据集名称: CLEAR (Unlocking Generative Potential for Degraded Image Understanding in Unified Multimodal Models)
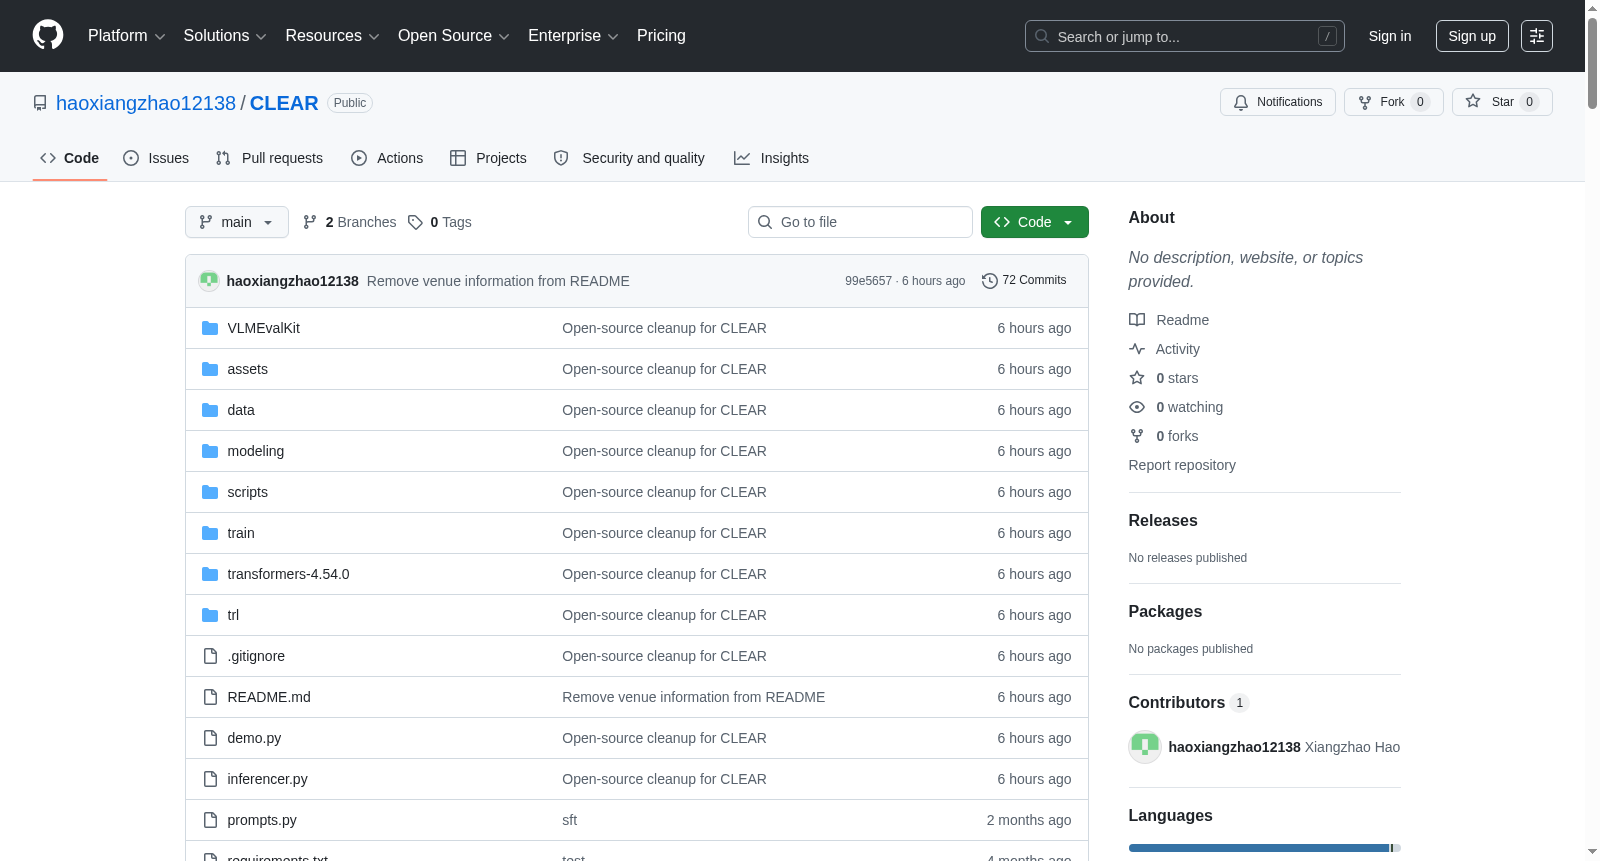
- 数据集地址: https://github.com/haoxiangzhao12138/CLEAR
- 核心用途: 用于训练和评估一个统一的、利用生成能力(图像恢复)来提升对退化图像视觉理解能力的多模态模型。
数据集内容与构成
- 训练数据: 数据集包含用于训练CLEAR模型的混合数据,具体由
corruption_mix.yaml配置文件定义,该配置结合了交错推理(interleave-reason)和文本推理(text-reason)数据集。 - 基准测试数据 (MMD-Bench): 数据集包含一个全面的退化图像基准测试,涵盖4个类别(采集、传输、环境、后处理)下的16种退化类型,每种类型有3个严重级别。数据生成脚本位于
data/corruption_datasets_create/目录下。 - 数据获取: 训练数据可通过Hugging Face下载,命令为
huggingface-cli download --resume-download --repo-type dataset CUDAOUTOFMEMORY/MMD-Bench --local-dir datasets。
数据集关联的模型与方法
- 基础框架: 基于 BAGEL 框架构建。
- 核心方法: 采用交错推理范式,模型通过学习自适应决定是否在回答问题前调用图像恢复功能。训练流程分为三个阶段:
- 监督微调 (SFT): 进行退化感知的监督微调,使用交错的
<think>/<image_restore>/<answer>推理格式。 - 桥接训练: 建立一个潜在表示桥,将去噪后的VAE潜在表示直接映射回LLM的标记空间,避免了解码再编码的开销。
- 交错GRPO: 使用组相对策略优化,结合四种奖励(准确性、格式、决策、潜在质量)来联合优化推理、生成和恢复决策。
- 监督微调 (SFT): 进行退化感知的监督微调,使用交错的
性能表现
- 主要基准: 在MMD-Bench (Hard) 基准测试上,CLEAR模型在退化图像理解任务上取得了最先进的性能。
- 关键结果: CLEAR-RL版本在多个基准测试(MMBench, MM-Vet, MMVP, CV-Bench, MMStar, RealWorldQA, R-Bench-Dis)上的平均得分达到65.26,优于所列的开源和部分闭源模型。与骨干模型Bagel相比,CLEAR-RL将干净图像到退化图像的性能下降减少了27%。
使用与评估
- 评估框架: 使用定制化的 VLMEvalKit 进行评估,该工具包支持CLEAR/BAGEL模型及退化级别的基准测试变体。
- 评估配置: 通过JSON配置文件指定模型路径、基准测试和推理模式(如交错推理、纯文本推理或仅感知增强)。
- 数据可视化: 提供了退化类型的可视化示例,位于
assets/corruption_vis.png。
相关资源
- 论文: https://arxiv.org/abs/2604.04780
- 项目主页: https://haoxiangzhao12138.github.io/CLEAR/
- 模型地址: https://huggingface.co/CUDAOUTOFMEMORY/CLEAR
- 数据地址: https://huggingface.co/datasets/CUDAOUTOFMEMORY/MMD-Bench
- 引用信息: 提供了标准的BibTeX引用格式。
- 1CLEAR: Unlocking Generative Potential for Degraded Image Understanding in Unified Multimodal Models中国科学院自动化研究所; 百度公司 · 2026年


