IndoorCrowd
收藏资源简介:
IndoorCrowd是由布加勒斯特理工大学等机构构建的多场景室内人群数据集,旨在解决复杂室内环境下人体感知任务的数据匮乏问题。该数据集包含4个不同建筑布局的校园场景(ACS-EC、ACS-EG等),采集了31段5fps视频共计9913帧,提供实例级分割掩码和MOTChallenge格式的连续身份轨迹标注。数据通过结合SAM等基础模型的自动标注与人工修正流程构建,特别关注人群密度变化(最高达79.3%稠密帧)和建筑遮挡等挑战。其应用领域涵盖智能监控、人机交互等需要精确室内人群分析的场景,为算法在真实复杂环境中的性能评估提供了新基准。
IndoorCrowd is a multi-scenario indoor crowd dataset developed by institutions including the Polytechnic University of Bucharest, which aims to address the data scarcity problem of human perception tasks in complex indoor environments. This dataset encompasses four campus scenarios with distinct building layouts such as ACS-EC and ACS-EG, with 31 videos collected at 5 frames per second (fps), totaling 9913 frames. It provides instance-level segmentation masks and continuous identity trajectory annotations formatted in line with MOTChallenge standards. The dataset is constructed via a workflow that combines automatic annotation using foundational models like SAM and manual revision, with particular emphasis on challenges including varying crowd densities (dense frames reaching up to 79.3%) and architectural occlusions. Its application domains cover scenarios requiring precise indoor crowd analysis such as intelligent surveillance and human-computer interaction, offering a new benchmark for evaluating algorithm performance in real-world complex environments.
IndoorCrowd 数据集概述
数据集基本信息
- 数据集名称: IndoorCrowd
- 核心任务: 室内场景下的人体检测、实例分割和多目标跟踪
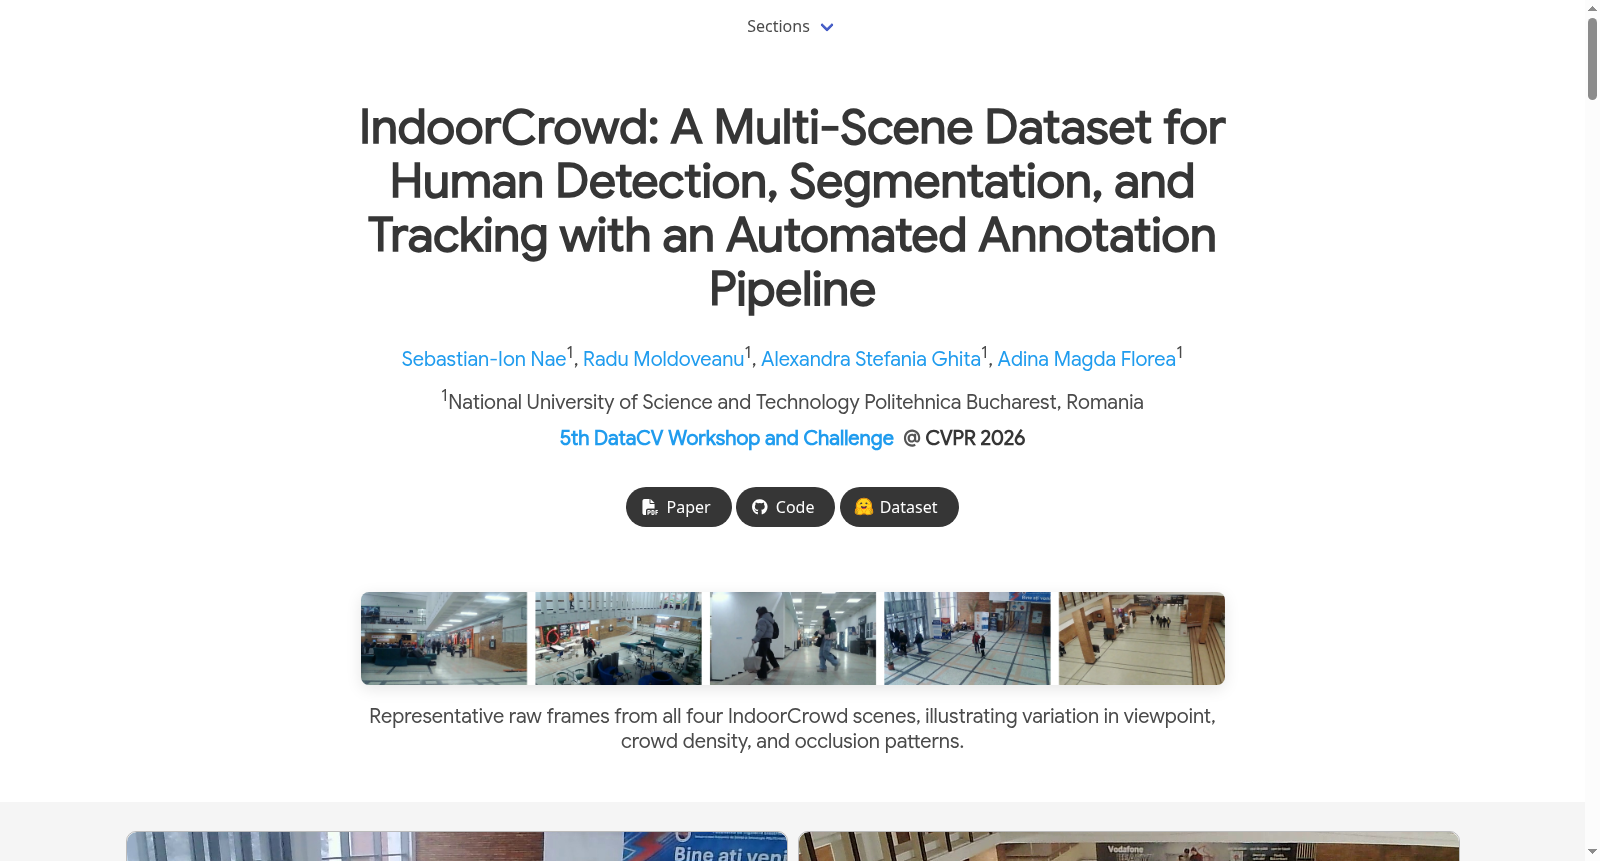
- 场景数量: 4个室内公共场所(ACS-EC, ACS-EG, IE-Central, R-Central)
- 数据总量: 31个视频,总计 9,913帧 带有人工验证和手动校正的逐实例分割掩码
- 控制子集: 620帧 完全由人工标注,用于基准测试
- 跟踪子集: 2,552帧 带有人工验证的连续身份轨迹,格式为MOTChallenge
- 采集设置: 固定网络摄像头,分辨率1280 × 720像素,25 fps,在多个日期的下午和傍晚录制
- 帧采样: 降采样至5 fps
场景详细描述与统计
各场景特点
- ACS-EC: 密集多层中庭,平均每帧12.2人,79.3%为密集帧,平均实例尺度60.8像素,是数据集中最具挑战性的场景。
- ACS-EG: 狭窄走廊,地面摄像机,近远距离尺度变化强烈,遮挡率38.3%。
- IE-Central: 入口大厅,高角度摄像机,每帧人数范围最广(4–17人),23.5%为密集帧。
- R-Central: 中央中庭,俯视视角,结构柱造成规律性部分遮挡,密度最均匀的场景。
人群统计(整体)
- 总实例数: 4,862
- 平均每帧人数: 8.10 ± 4.18
- 密度分布: 稀疏(≤3人)5.8%,中等(4–10人)62.0%,密集(>10人)32.2%
- 整体遮挡率: 30.3%(基于边界框重叠IoU > 0.1估计)
实例尺度统计(整体)
- 相对尺度均值: 各场景不同
- 绝对尺度均值(像素): 各场景不同
- 宽高比均值: 各场景不同
- COCO尺寸分布: 小(< 32² px²)、中(32²–96² px²)、大(> 96² px²)百分比各场景不同
标注流程
采用 人机协同管道,结合高召回率的基础模型自动标注与针对性人工校正。
- 视频录制: 固定网络摄像头。
- 帧采样: 5 fps。
- 基础模型自动标注: 使用三种自动标注器生成候选掩码和边界框:SAM3(高召回,文本提示)、GroundingSAM(语言接地,更高精度)、EfficientGroundingSAM(较低推理成本下质量相当)。
- 人工审查与校正: 每帧均经过人工验证,使用SAM 2.1和交互式Gradio审查界面进行添加、校正和删除。
- 人工标注控制子集: 620帧完全从头标注,无任何自动标注先验。
- MOT子集整理: 从SAM3检测结果生成初始轨迹片段,经人工审查校正身份切换、合并片段、移除幽灵轨迹并线性插值缺失检测。
自动标注质量评估
基于620帧人工标注真值进行评估。评估指标:AP@0.5, AP@0.75, 精确率, 召回率, 掩码IoU, Cohens κ。
- 关键发现: SAM3在密集场景(如ACS-EC)中召回率最高(0.88–0.98),但精度较低(ACS-EC为0.52),是人工校正的最佳起点。GroundingSAM和EfficientGroundingSAM提供互补的更高精度。所有方法在ACS-EC上性能下降最多,因其帧更密集、实例更小(平均60.8像素)且遮挡更高。
基准测试结果
检测与分割
模型在ACS-EC + ACS-EG上训练,在IE-Central + R-Central上评估。
- 最佳检测模型: RT-DETR-L(Box mAP@0.5: 0.911)。
- 最佳分割模型: YOLOv8n-seg(Mask mAP@0.5: 0.833,延迟最低:1.89 ms)。
多目标跟踪(整体)
在所有四个场景上评估六种检测器-跟踪器组合。
- 最佳组合: RT-DETR-L + OC-SORT(MOTA: 56.2,IDF1: 71.8)。
- 身份切换最少: YOLOv8n + BoT-SORT(IDS: 143)。
- 实时部署推荐: YOLOv8n + ByteTrack(MOTA: 48.5,FPS > 108)。
- 最具挑战性跟踪场景: ACS-EC(即使使用RT-DETR-L,MOTA峰值也为40.2)。
相关数据集对比
- 现有行人检测基准(CrowdHuman, WiderPerson, CityPersons)主要为室外场景。
- MOTChallenge系列(MOT17, MOT20)缺乏实例掩码,且关注非受限或事件驱动环境而非固定室内监控。
- IndoorCrowd填补了真实世界、固定摄像头室内场景的空白,提供了在多样化人群条件下的三种标注类型(边界框、实例掩码、MOT轨迹)。
引用信息
bibtex @inproceedings{indoorcrowd2026, author = {Nae, Sebastian-Ion and Moldoveanu, Radu and Ghita, Alexandra Stefania and Florea, Adina Magda}, title = {IndoorCrowd: A Multi-Scene Dataset for Human Detection, Segmentation, and Tracking with an Automated Annotation Pipeline}, booktitle = {5th DataCV Workshop and Challenge, in conjunction with IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR)}, year = {2026}, }