ego-extra-imu-benchmark
收藏资源简介:
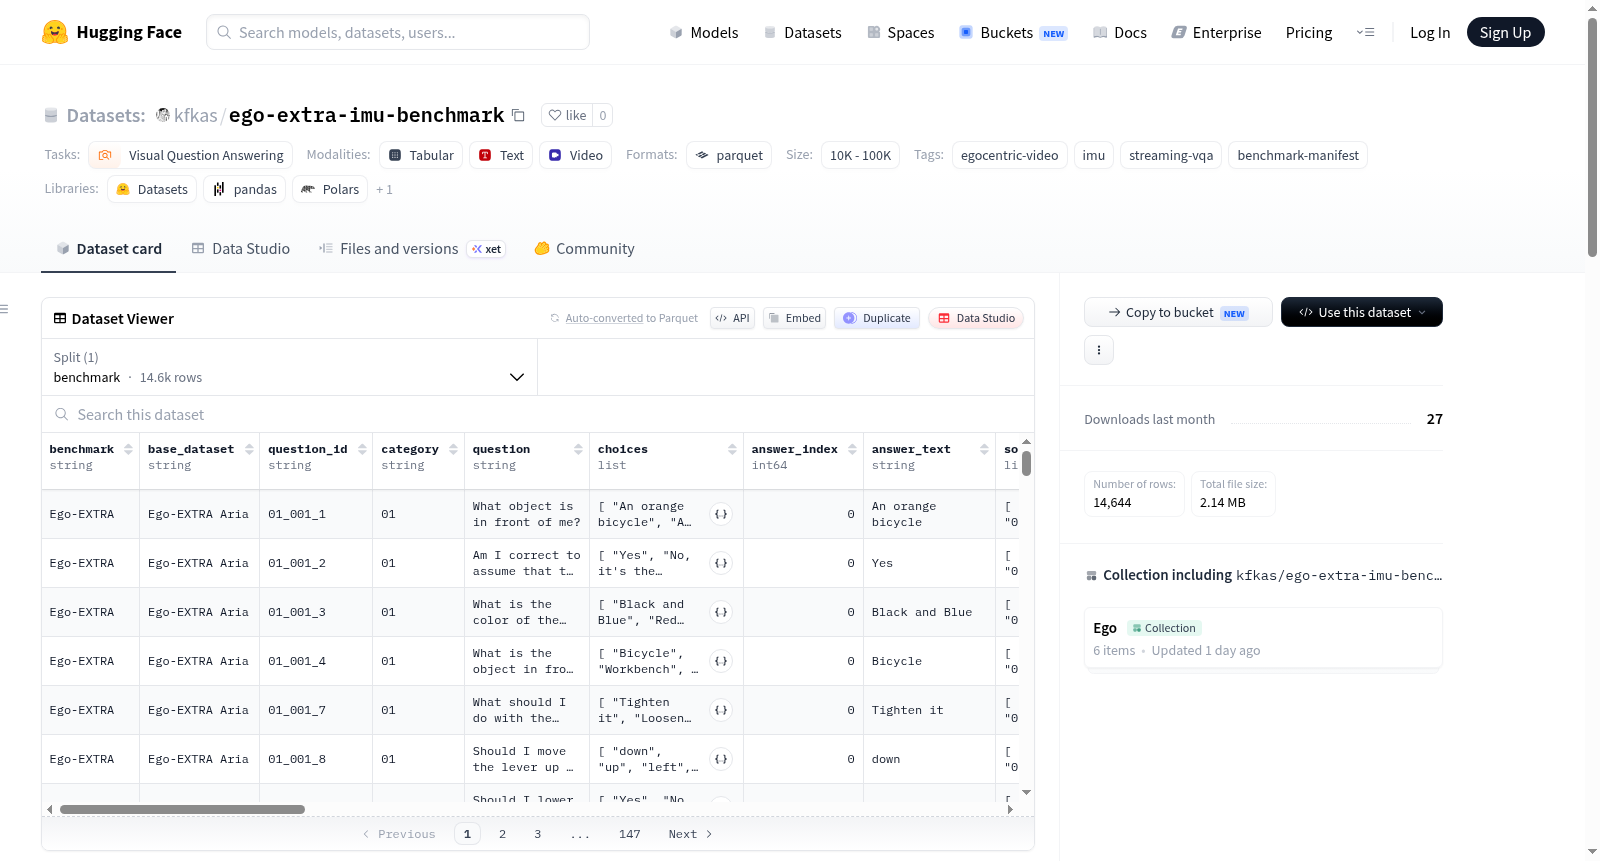
Ego-EXTRA是一个面向自我中心(第一人称)视频的视觉问答(VQA)基准数据集,特别支持结合IMU(惯性测量单元)数据的流式视频问答(streaming VQA)任务。该数据集以清单形式提供,包含基准注释和逻辑本地资产提示,但不包含原始媒体文件。基础数据集为Ego-EXTRA Aria,共有14,644个样本,其中12,702个样本同时包含本地RGB视频和IMU数据。所有样本的答案键均为公开状态。数据集包含一个示例视频用于快速视觉检查。每个样本包含统一的字段,包括:基准名称、基础数据集、问题ID、类别、问题文本、选项列表、答案索引、答案文本、源ID、查询时间、证据时间、剪辑起始/结束时间、流数量、视频资产提示、IMU资产提示、本地视频可用性、本地IMU可用性、是否可用于IMU基准、覆盖状态、答案键状态、元数据JSON以及流信息(streams)。其中streams字段以嵌套结构存储源ID、模态、传感器角色、时间边界、资产提示、本地可用性和连接类型。用户可通过HuggingFace Datasets库加载数据集,并根据usable_for_imu_benchmark字段筛选出可用于IMU基准的样本。完整原始媒体文件需根据上游协议从原始来源下载。
Ego-EXTRA is a visual question answering (VQA) benchmark dataset for egocentric (first-person) videos, specifically supporting streaming VQA tasks combined with IMU (Inertial Measurement Unit) data. The dataset comprises 14,644 samples, of which 12,702 include both local RGB video and IMU data.
数据集概述
基本信息
- 数据集名称:Ego-EXTRA
- 数据集类型:视觉问答(Visual Question Answering)
- 标签:自我中心视频(Egocentric Video)、惯性测量单元(IMU)、流式视频问答(Streaming VQA)、基准清单(Benchmark Manifest)
- 基础数据集:Ego-EXTRA Aria
规模与状态
- 总行数:14,644
- 含本地RGB+IMU数据的行数:12,702
- 答案密钥状态:全部公开(public=14644)
- 仓库已更新:采用通用Schema结构
数据内容与Schema
所有行使用统一的列结构,包含以下主要字段:
- 基础字段:
benchmark、base_dataset、question_id、category、question、choices、answer_index、answer_text、source_ids - 时间信息:
query_time、evidence_time、clip_start_s、clip_end_s - 数据流字段:
stream_count、streams(包含源ID、模态、传感器角色、时间边界、资产提示、本地可用性及连接类型) - 资产与可用性:
video_asset_hint、imu_asset_hint、local_video_available、local_imu_available、usable_for_imu_benchmark - 状态与元数据:
coverage_status、answer_key_status、metadata_json
数据加载方式
python from datasets import load_dataset
dataset = load_dataset("kfkas/ego-extra-imu-benchmark", split="benchmark") usable = dataset.filter(lambda row: row["usable_for_imu_benchmark"])
重要说明
- 本数据集不包含完整的原始媒体文件(如MP4、VRS、ZIP、CSV或NPZ文件),仅提供一个短示例视频片段用于快速视觉检查。
- 完整的源媒体需根据上游条款另行下载,并使用
sensor_vqa/raw/下的相对路径提示进行关联。
数据来源
- 上游项目主页:https://fpv-iplab.github.io/Ego-EXTRA/