
遇见数据集

amalia-llm/EmbSpatial-Bench-PT

收藏
Hugging Face2026-07-06 更新2026-07-22 收录
官方服务:

资源简介:

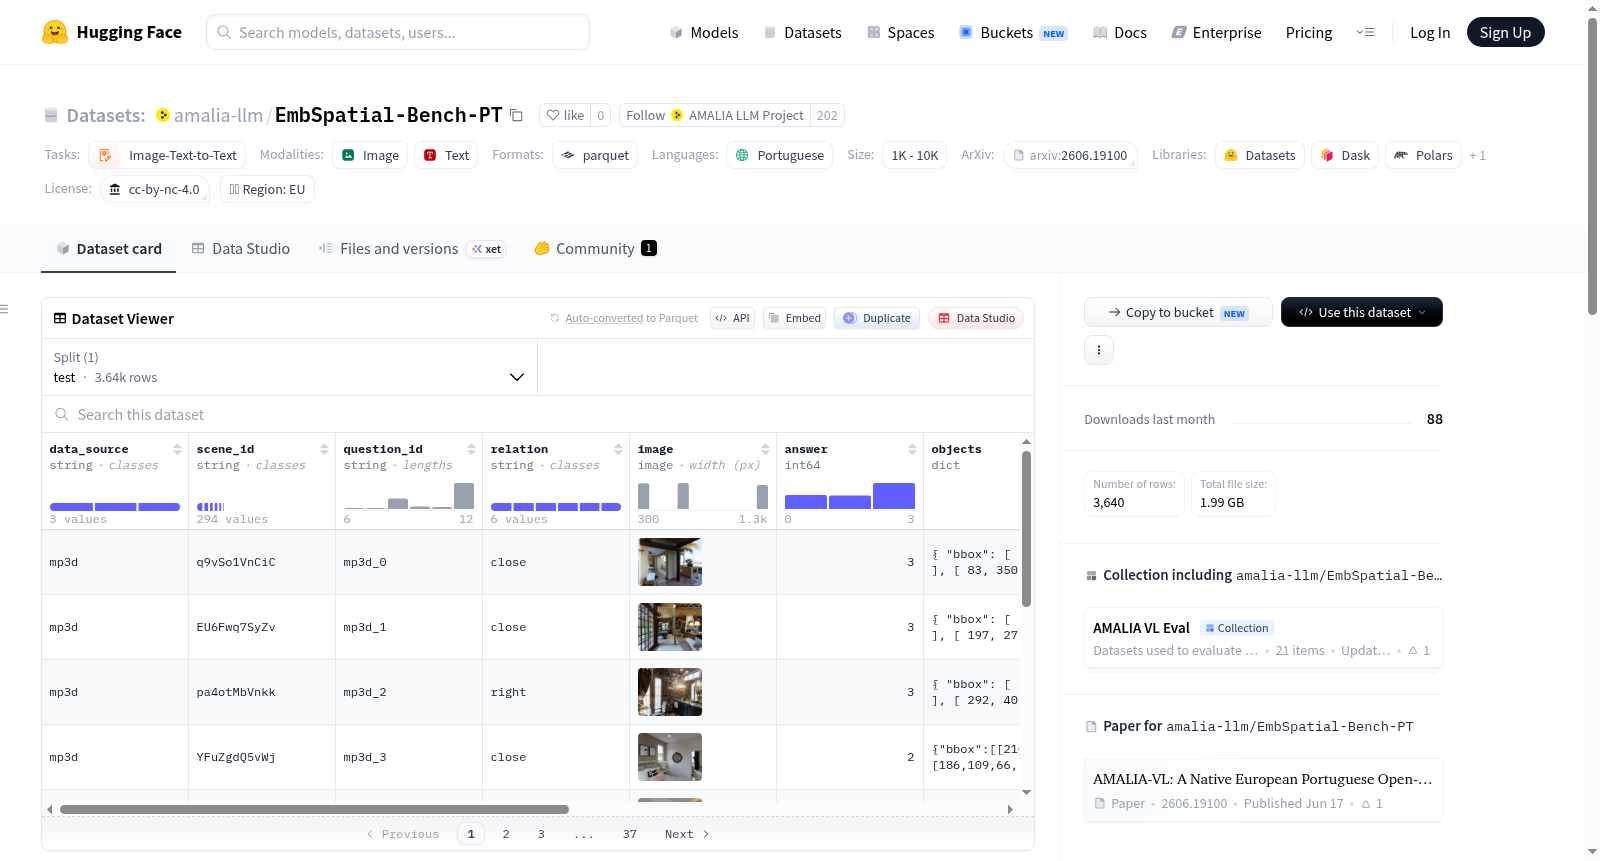
EmbSpatial-Bench-PT是EmbSpatial-Bench的欧洲葡萄牙语(pt-PT)机器翻译版本,是一个用于从具身、自我中心视角评估空间推理能力的基准测试数据集。它基于原始英文测试集分割,使用gemini-3.1-pro进行翻译,包含3640个示例,任务类型为图像-文本到文本。数据集是AMALIA项目的一部分,用于评估大型视觉语言模型在欧洲葡萄牙语上的性能。注意:该数据集是机器翻译的,可能包含翻译错误或伪影。

EmbSpatial-Bench-PT is a European Portuguese (pt-PT) machine translation of EmbSpatial-Bench, a benchmark for evaluating spatial reasoning from an embodied, egocentric perspective. It is translated from the original English test split using gemini-3.1-pro, containing 3640 examples with a task category of image-text-to-text. This dataset is part of the AMALIA project and included in amalia-vl-eval, a comprehensive benchmark suite for evaluating large vision-language models on European Portuguese. Note: This dataset is machine translated and may contain translation errors or artifacts.
提供机构:
amalia-llm
搜集汇总
数据集介绍
amalia-llm/EmbSpatial-Bench-PT 数据集图片
构建方式
EmbSpatial-Bench-PT 是面向欧洲葡语(pt-PT)的空间推理评估基准,源自英文原版 EmbSpatial-Bench。该数据集通过调用 gemini-3.1-pro 大语言模型,将原始测试集(test split)中的文本内容——包括问题、答案及选项——逐项翻译为欧洲葡萄牙语,而场景图像、边界框等视觉与结构化信息则完全保留原貌。构建过程严格遵循机器翻译的流水线作业,确保语言转换的同时不损伤空间关系与物体标注的完整性。最终形成的 3640 个样本覆盖了具身第一人称视角下的多类型空间理解任务。
特点
作为 AMALIA 项目评估套件的核心组成部分,EmbSpatial-Bench-PT 具备双重特色。其一,其文本内容经由现代大语言模型翻译,在保持原基准命题逻辑与语义难度的基础上,实现了语言本地化的高效扩展。其二,数据集中每项样本均包含场景图像、物体名称及其边界框坐标、问题与多选答案,为评估多模态大模型在葡萄牙语环境下的空间认知能力提供了丰富、结构化的评测材料。此外,该数据集采用双许可证机制,翻译文本以 CC-BY-NC 4.0 发布,而图像与未翻译字段则遵循原始许可,确保合规使用的灵活性。
使用方法
使用者可通过 HuggingFace Datasets 库直接加载 EmbSpatial-Bench-PT,指定配置名为“default”并读取测试分片(test split)中的 Parquet 文件。每条数据包含场景编号、问题标识、空间关系类型、JPEG 图像及其 Base64 编码、选项列表和正确答案索引。适用于对视觉-语言模型进行零样本或微调后的性能评测,尤其关注其在欧洲葡萄牙语空间推理任务——如物体相对位置、远近判断与视觉关系理解——上的表现。建议在运行评估时同时遵守翻译内容的非商业性授权与原始数据的版权条款。
背景与挑战
背景概述
EmbSpatial-Bench-PT 数据集诞生于2026年,由葡萄牙的 AMALIA 项目团队构建,旨在评估具身智能体在自我中心视角下的空间推理能力。该数据集是原始 EmbSpatial-Bench 的欧洲葡萄牙语(pt-PT)机器翻译版本,通过 gemini-3.1-pro 模型将英文测试集翻译而来,作为 AMALIA-VL 基准测试套件的一部分,用于评测大规模视觉语言模型在非英语语境下的空间理解表现。其核心研究问题聚焦于多模态模型能否在具身场景中准确感知物体间的三维空间关系,以弥补现有基准对葡萄牙语支持的缺失。该数据集对低资源语言的多模态推理研究具有推动作用,为欧洲葡萄牙语自然语言处理与视觉理解的交叉领域树立了标准化评估范式。
当前挑战
EmbSpatial-Bench-PT 面临的主要挑战包括:首先,机器翻译引入的语义偏差可能影响空间关系判断的准确性,尤其当葡萄牙语缺乏与英语等价的方位表达时,会导致问题或选项的歧义。其次,数据集的图像内容均保留原始英文场景,文化特异性物品(如标志性建筑或常见物品)在葡萄牙语语境下可能产生认知差异,考验模型对跨文化视觉理解的多模态对齐能力。构建过程中,翻译器未能完全处理人称指代与空间介词的语言特异性,例如 '左/右' 与葡萄牙语 'esquerda/direita' 的语用差异,增加了评测的噪声。此外,非商业性许可限制了数据集在工业界的广泛应用,而原始基准的具身任务设计本身仍面临现实场景中动态环境与遮挡带来的推理复杂度。
常用场景
经典使用场景
EmbSpatial-Bench-PT 作为专门评估具身视角下空间推理能力的基准数据集,其核心应用场景在于衡量多模态大语言模型在欧式葡萄牙语环境中对空间关系的理解与推理水平。该数据集通过提供第一人称视角的真实场景图像,配以精心设计的空间关系问题,使研究者能够系统性地检验模型在“左-右”、“前-后”、“近-远”等空间方位判断上的表现,从而捕捉模型在具身智能任务中的视觉-语言对齐能力。
衍生相关工作
EmbSpatial-Bench-PT 的推出衍生了一系列围绕非英语语言空间推理的评测工作,其中最具代表性的是 AMALIA-VL 项目中的 amalia-vl-eval 基准套件,该系统性地整合了包括本数据集在内的多项多模态评测资源。此外,基于该数据集的跨语言空间推理对比研究应运而生,例如将模型在英语原版 EmbSpatial-Bench 和葡萄牙语译本上的表现进行对比分析,从而揭示翻译质量与模型理解之间的微妙关联,并促进机器翻译与视觉语言理解的联合改进工作。
数据集最近研究
最新研究方向
EmbSpatial-Bench-PT作为AMALIA项目的重要组成部分,致力于将具身空间推理评测基准迁移至欧洲葡萄牙语场景,填补了多语言视觉语言模型在空间认知评估中的语料空白。当前前沿研究聚焦于利用大语言模型进行跨语言知识蒸馏,通过机器翻译技术保留原始基准的具身视角与空间关系复杂度,同时探索非英语环境下模型对物体方位、视角依赖等细粒度空间语义的理解能力。该数据集与AMALIA-VL模型的协同发布,推动了葡萄牙语视觉语言社区在具身人工智能评测标准上的规范化进程,为多模态系统在空间推理任务上的语言泛化性研究提供了关键支撑,也呼应了全球范围内低资源语言评测基准建设的迫切需求。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

