
synthetic-invoice-degradation-cropped
收藏官方服务:
资源简介:
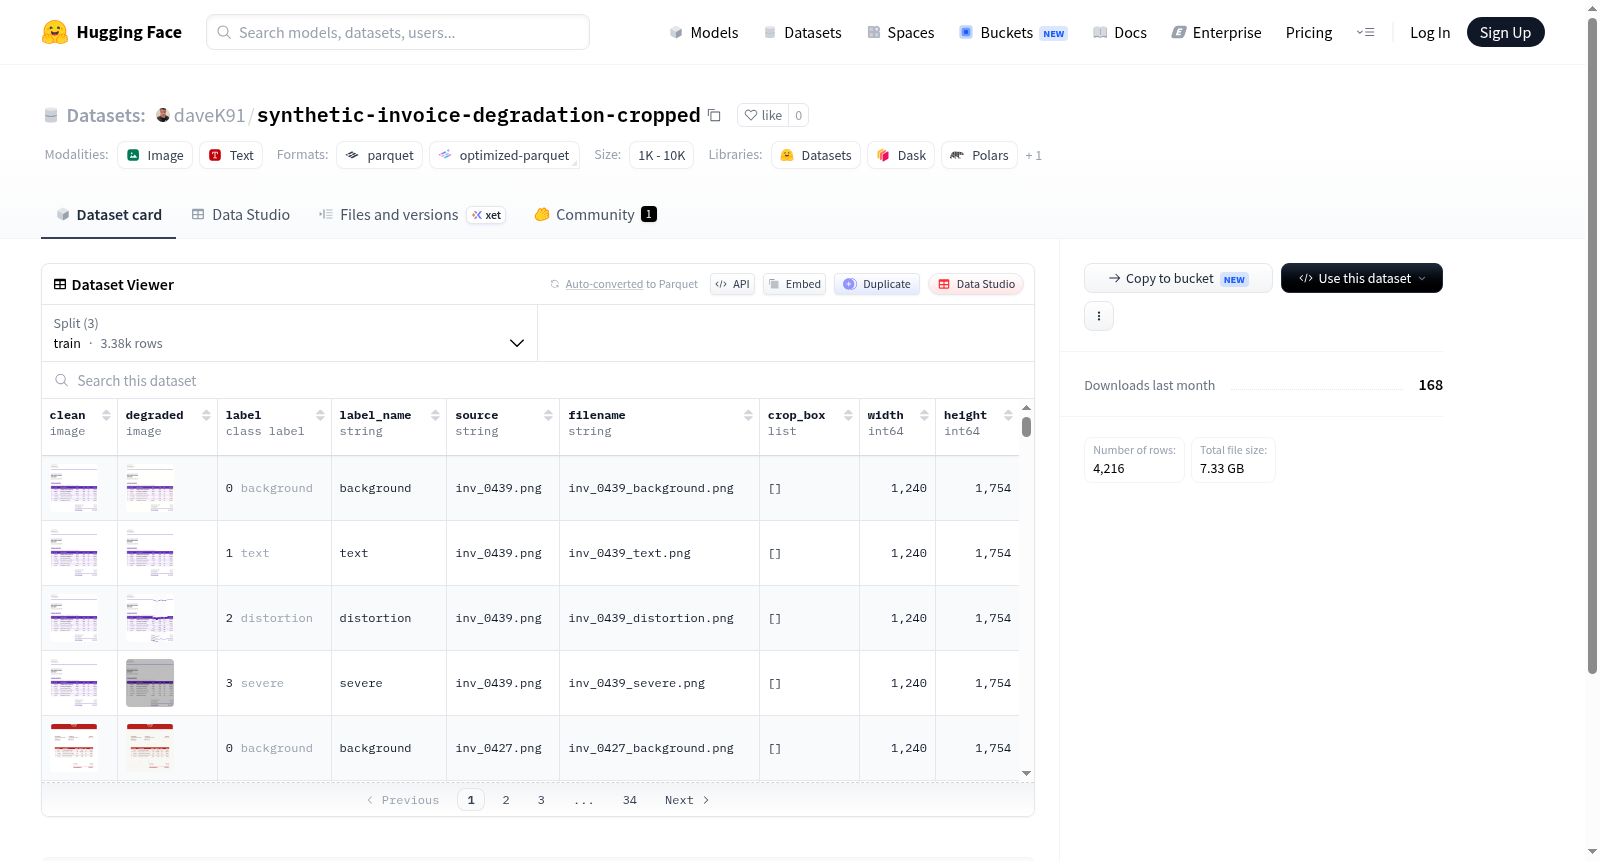
该数据集是一个用于图像质量评估或图像修复任务的配对图像数据集,每个样本包含一对图像:clean(干净图像)和degraded(退化图像),以及对应的分类标签。标签分为四个类别:0-背景、1-文本、2-失真、3-严重,用于标识图像退化的类型或严重程度。数据集还提供丰富的元数据字段,包括标签名称、数据来源、文件名、裁剪框坐标以及图像的宽度和高度。数据集共包含4,216个样本,划分为训练集(3,376个样本)、验证集(420个样本)和测试集(420个样本),总大小约为7.5GB,适用于训练和评估图像去噪、图像增强、图像修复或图像质量分类等计算机视觉模型。
创建时间:
2026-06-22
原始信息汇总
数据集概述:daveK91/synthetic-invoice-degradation-cropped
该数据集是一个专注于发票图像退化(degradation)的合成数据集,包含经过裁剪的发票图像及其对应的退化版本,可用于图像修复、去噪或退化分类等任务。
主要特征
- 数据格式:包含7个特征字段。
clean(image):原始的、未退化的干净发票图像。degraded(image):经过退化处理的发票图像。label(class_label):图像退化程度的类别标签,包含4类:0: background (背景)1: text (文本)2: distortion (扭曲)3: severe (严重)
label_name(string):类别标签的文本名称。source(string):图像来源信息。filename(string):图像文件名。crop_box(list of int64):裁剪框的坐标信息(通常为 [x1, y1, x2, y2])。width(int64):图像的宽度(像素)。height(int64):图像的高度(像素)。
数据集规模
- 总下载大小:约7.33 GB
- 总数据集大小:约7.54 GB
- 数据划分:数据集分为三个子集:
- 训练集 (train):包含3,376个样本,大小为5.95 GB。
- 验证集 (validation):包含420个样本,大小为796.74 MB。
- 测试集 (test):包含420个样本,大小为790.96 MB。
配置与文件结构
- 配置:仅提供默认配置 (
default)。 - 数据文件:存储在
data/目录下,按子集划分:- 训练集:
data/train-* - 验证集:
data/validation-* - 测试集:
data/test-*
- 训练集:
搜集汇总
数据集介绍
构建方式
该数据集专为发票图像退化与恢复任务而设计,基于合成技术生成。构建过程首先采集清晰的发票图像作为‘clean’基准,随后通过模拟真实世界中常见的退化因素,如扫描噪声、光照不均、墨迹污损、纸张折痕等,对清晰图像施加一系列退化操作,得到对应的‘degraded’图像。每张图像附带像素级语义标签,其中‘label’字段将退化区域划分为背景、文本、失真和严重四类,辅以‘label_name’提供可读的类别名称。此外,数据集记录了每张图像的来源、文件名、裁剪框坐标以及原始尺寸,确保图像级元数据完整。最终形成训练集3376例、验证集420例、测试集420例的挑战性基准,为退化发票的智能修复与分类研究提供了高质量素材。
特点
数据集的核心特点在于其精细的类别划分与丰富的元信息结构。‘label’字段涵盖‘background’、‘text’、‘distortion’、‘severe’四类,不仅区分了图像中的正常区域与文本内容,更将退化程度细分为一般失真与严重退化,支持多层次退化诊断与定制化修复策略。每张样本均保存为‘clean’与‘degraded’成对图像,便于监督学习框架直接利用。同时,数据集的‘crop_box’字段记录了裁剪区域精准坐标,‘width’与‘height’明确图像尺寸,为空间变换与局部处理提供依据。这些特质使得该数据集在文档图像恢复、噪声分类与退化分割任务中具有独特优势,堪称模拟真实发票场景退化的标杆资源。
使用方法
该数据集以HuggingFace Datasets库标准格式发布,可通过简单代码加载使用。用户利用`load_dataset('synthetic-invoice-degradation-cropped')`即可获取包含‘train’、‘validation’、‘test’三个子集的数据对象,每个样本以字典形式封装‘clean’与‘degraded’图像(PIL.Image对象)及对应标签。对于分割任务,可直接将‘label’作为像素级监督;对于分类任务,可聚合标签分布或利用‘source’字段区分不同退化类型。图像尺寸随原始文件动态加载,无需额外预处理。研究者在训练图像恢复模型时,可配对‘clean’为目标、‘degraded’为输入;在退化分类场景中,则可用‘label_name’作为多类别预测目标,灵活适配各类计算机视觉框架。
背景与挑战
背景概述
在文档图像分析与识别领域,真实场景中的发票图像常因扫描、拍照或传输过程引入各类退化,如模糊、失真、遮挡及光照不均,严重干扰光学字符识别(OCR)与文档理解系统的性能。为系统性地研究这一问题,研究团队构建了synthetic-invoice-degradation-cropped数据集,通过合成方式生成成对的清洁与退化发票图像,并标注了背景、文本、失真及严重四类劣化标签。该数据集由3376张训练图像、420张验证图像和420张测试图像组成,覆盖多种退化类型,旨在为发票图像增强与退化分类任务提供基准。虽然其具体发布机构与时间未在README中详述,但数据集的精心设计对推动抗退化文档分析技术的研究具有重要价值,尤其为评估与训练退化修复模型提供了标准化数据资源。
当前挑战
该数据集面临的核心挑战包括:一是领域问题挑战,即真实发票图像受复杂退化影响时,现有识别系统鲁棒性不足,尤其在混合退化(如同时存在失真与文本模糊)场景下,退化分类与图像恢复的精度难以保障;二是构建过程中的挑战,合成退化虽然可控,但难以完全模拟真实世界中的退化多样性(如随机污渍、褶皱或扫描仪伪影),可能导致模型在真实场景中的泛化能力受限。此外,由于数据集仅涵盖英文或数字内容,跨语言或复杂版式发票的退化建模尚未充分覆盖,进一步限制了其适用范围。
常用场景
经典使用场景
synthetic-invoice-degradation-cropped 数据集专为发票图像质量退化研究而构建,其核心经典场景在于模拟真实世界中因扫描、拍摄、传输等环节造成的各类文档损伤。数据集中包含了从清晰到严重退化的图像对,并配有详细的标签信息(如背景、文字、畸变和严重退化),使得研究者能够在受控条件下系统性地训练和评估图像增强、去噪及超分辨率等算法。这一数据集的独特之处在于其聚焦于发票这一特定领域,为商业文档处理中的质量复原提供了高标准、可重复的基准测试平台。
衍生相关工作
围绕这一数据集,学术界衍生出了多项经典工作,涵盖了基于深度学习的图像修复、领域自适应退化模型以及多任务联合优化框架。研究者们利用其成对的清晰-退化图像,开发了诸如条件生成对抗网络(cGAN)用于去除复杂背景干扰、Transformer架构处理结构性畸变,以及面向文档的轻量化去噪网络。这些衍生的工作不仅验证了数据集在模拟真实退化上的有效性,还催生了诸如Doc-Ultrastructure和DeRendition等改进模型,进一步提升了文档图像在极端退化条件下的恢复质量与字符识别准确率,形成了富有活力的研究链条。
数据集最近研究
最新研究方向
在光学字符识别(OCR)与文档图像处理领域,该数据集聚焦于模拟真实场景下发票图像的退化与失真,为评估和提升OCR系统在复杂环境中的鲁棒性提供了关键支撑。当前前沿研究围绕噪声、模糊、光照不均等退化因素的模拟与去噪技术展开,并结合深度学习模型如GANs进行图像修复。其核心意义在于推动工业级文档自动化处理系统应对扫描、传真等低质量输入场景的挑战,对金融、税务等票据数字化管理具有重要应用价值。
以上内容由遇见数据集搜集并总结生成


