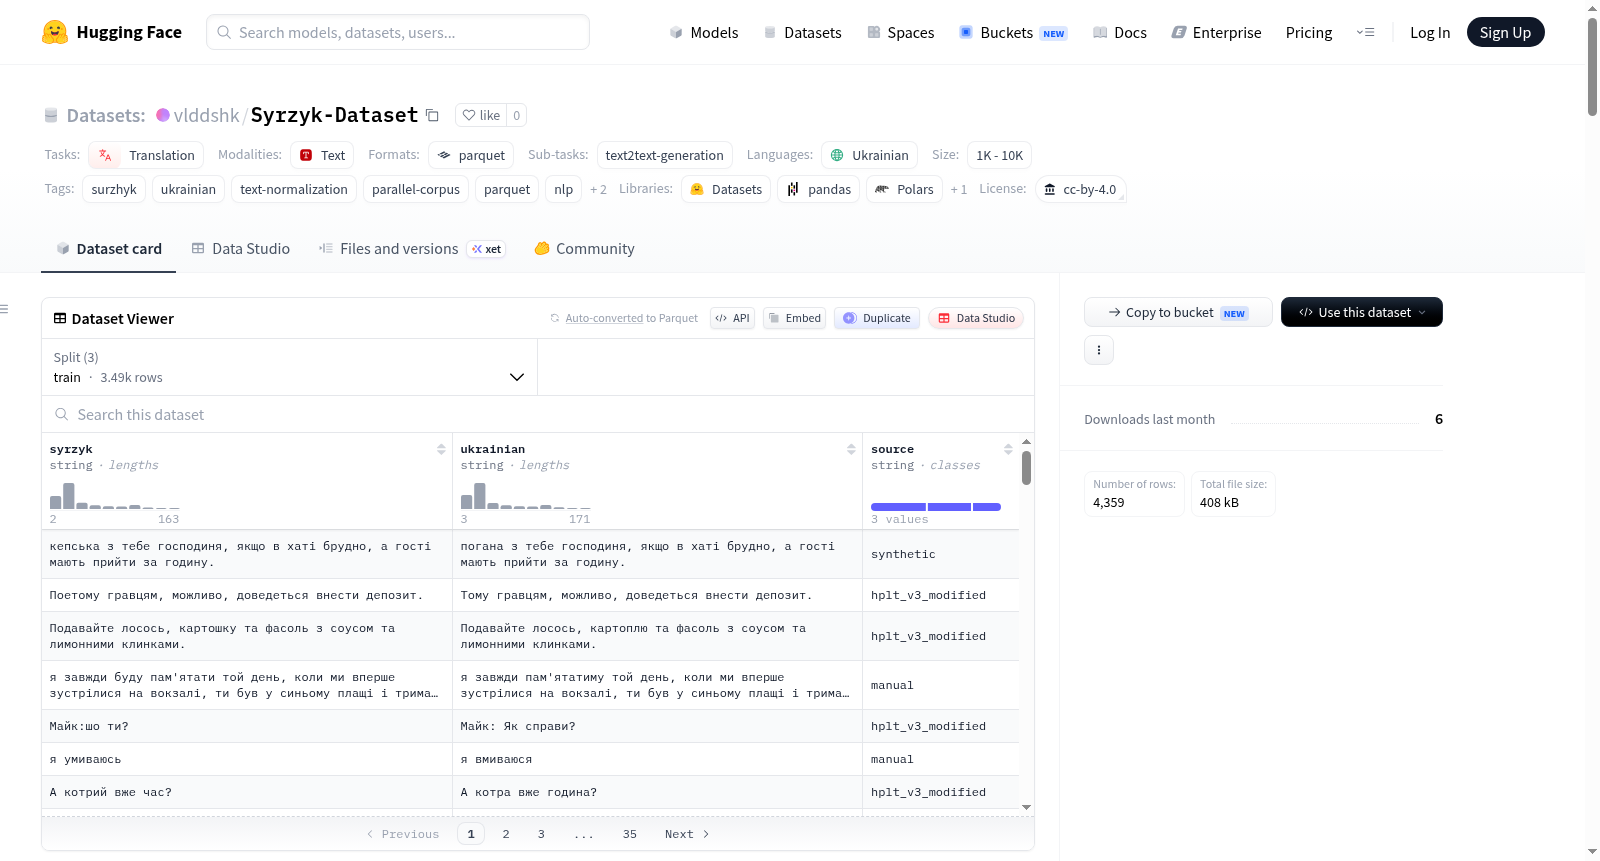
Syrzyk-Dataset
收藏资源简介:
Syrzyk 数据集是一个经过严格验证的平行语料库,用于文本规范化、纠正俄语借词以及将乌克兰语中的“суржик”(一种混合俄语与乌克兰语的非标准变体)自动转换为标准规范乌克兰语。该数据集由 SyrzykAI 项目创建,主要面向微调 seq2seq 模型(如 facebook/nllb-200-distilled-600M),并使用 chrF、CER 和 WER 指标评估文本校正系统。数据集以高效的 Apache Parquet 二进制格式存储,已去除重复和噪声,并按固定随机种子(seed=42)划分为训练集(3,487 对)、验证集(436 对)和测试集(436 对),总计 4,359 对句子。每条记录包含三个字段:syrzyk(输入句子,含суржик元素、俄语语法借用或俄语化结构)、ukrainian(对应的标准乌克兰语翻译)、source(数据来源,包括手动编写的日常对话、基于 HPLT v3 语料库经规则替换和人工过滤的修改版,以及 Kimi K2 大模型生成并经人工验证的合成数据)。数据集覆盖了词汇俄语化、语音/拼写扭曲、句法控制错误、介词结构错误以及错误动词形式等关键类型的суржик错误。支持的任务包括翻译(суржик到标准乌克兰语)、语法错误纠正和文本规范化。该数据集根据 Creative Commons Attribution 4.0 International (CC BY 4.0) 许可发布。
The Syrzyk dataset is a rigorously validated parallel corpus for text normalization, correcting Russian borrowings, and automatically converting surzhyk (a non-standard mixed variety of Russian and Ukrainian) in Ukrainian into standard normative Ukrainian. Created by the SyrzykAI project, it is primarily intended for fine-tuning seq2seq models (e.g., facebook/nllb-200-distilled-600M) and evaluating text correction systems using chrF, CER, and WER metrics. The dataset is stored in the efficient Apache Parquet binary format, deduplicated and denoised, and split into training (3,487 pairs), validation (436 pairs), and test (436 pairs) sets with a fixed random seed (seed=42), totaling 4,359 sentence pairs. Each record contains three fields: syrzyk (input sentence with surzhyk elements, Russian grammatical borrowings, or Russified structures), ukrainian (corresponding standard Ukrainian translation), and source (data origin, including manually written everyday dialogues, modified versions based on the HPLT v3 corpus via rule-based replacement and manual filtering, and synthetic data generated by the Kimi K2 large model with human validation). The dataset covers key types of surzhyk errors such as lexical Russification, phonetic/spelling distortions, syntactic control errors, prepositional structure errors, and incorrect verb forms. Supported tasks include translation (surzhyk to standard Ukrainian), grammatical error correction, and text normalization. The dataset is released under the Creative Commons Attribution 4.0 International (CC BY 4.0) license.
Syrzyk Dataset 数据集详情
数据集概述
Syrzyk Dataset 是一个乌克兰语文本规范化平行语料库,旨在将суржик(Surzhyk)(乌克兰语与俄语混合的非标准语言变体)转换为规范的乌克兰文学语言。该数据集专为序列到序列(Seq2Seq)模型微调而设计,规模为 4,359对平行句对,数据格式为 Apache Parquet。
数据集结构
数据列说明
| 列名 | 数据类型 | 描述 |
|---|---|---|
syrzyk |
string | 包含суржик元素、俄语借词或仿造结构的输入句子/短语 |
ukrainian |
string | 对应的规范乌克兰文学语言表达 |
source |
string | 句对来源及制备方法(如manual、synthetic、hplt_v3_modified) |
数据分割统计
| 分割 | 句对数 | 占比 | 文件名 | 大小 |
|---|---|---|---|---|
| train | 3,487 | 80.0% | train.parquet | ~305 KB |
| validation | 436 | 10.0% | validation.parquet | ~43 KB |
| test | 436 | 10.0% | test.parquet | ~42 KB |
| 合计 | 4,359 | 100% | — | ~390 KB |
数据划分使用 Hugging Face datasets 库的 train_test_split 方法,设置 shuffle=True 和固定随机种子 seed=42。
数据来源与方法论
数据集由三个互补来源组合而成:
| 来源 | 句对数 | 占比 | 说明 |
|---|---|---|---|
| manual | 1,873 | 43.0% | 基于真实口语和典型口语结构手工编写的日常对话、俚语表达和仿造短语 |
| hplt_v3_modified | 1,503 | 34.5% | 选自 HPLT v3 开放网络语料库的高质量规范句,通过语言学生成器注入伪суржик,经人工筛选校验 |
| synthetic | 983 | 22.5% | 使用 LLM(Kimi K2)生成,侧重复杂句法俄语借词、介词结构和公文/政论суржик,全部经人工核验编辑 |
语言覆盖范围
数据集涵盖以下主要суржик错误类型:
- 词汇仿造与俄语借词:如
привєт→привіт、получається→виходить、заказ→замовлення、даже→навіть、строїти→будувати - 语音与拼写扭曲:如
дєвочка→дівчинка、всє→всі - 句法搭配与介词结构错误:如
по справах(应为по ділах)、двома словами(应为в двох словах)、через хворобу(应为по хворобі / із-за хвороби) - 错误动词形式:如
дєлати / робить→робити、казав→говорив
目标任务与用途
- 翻译 / 文本生成:суржик到乌克兰文学语言的转换
- 语法错误纠正:修正语法、拼写和词汇干扰错误
- 文本规范化:非正式或混合网络内容、字幕、聊天消息的规范化处理
使用方式
可通过 Hugging Face datasets 库直接加载:
python from datasets import load_dataset dataset = load_dataset("vlddshk/Syrzyk-Dataset")
也可通过 Pandas 直接读取 Parquet 文件:
python import pandas as pd df_train = pd.read_parquet("https://huggingface.co/datasets/vlddshk/Syrzyk-Dataset/resolve/main/train.parquet")
限制与特征
- 样本规模(v1.0):仅含 4,359 个精选示例,作为微调与基准测试的种子数据集,计划扩展至 10k 示例以覆盖更多地区方言
- 地区差异:суржик并非统一语言,不同地区(如斯洛博然希纳、波利西亚、南部)的俄语干扰程度和特征各异
- 内容过滤:语料库已进行基础净化,不含粗俗词汇,聚焦通用、政论及日常口语词汇
许可证
采用 Creative Commons Attribution 4.0 International (CC BY 4.0) 开放许可,允许自由分享、复制、改编及商业使用,但需注明原作者和原仓库链接。