carimages-rights
收藏资源简介:
CarImages Rights Manifest 是一个汽车照片版权解析索引数据集,包含 26,118 张来自 Wikimedia Commons 的 Creative Commons 和公有领域汽车照片的元数据。该数据集不包含任何图像,仅提供元数据和 URL,因此不会传播相同方式共享(ShareAlike)义务。其创建目的是解决 Wikimedia Commons 上许可证记录不一致的问题,将每张照片的许可证解析为三个机器可读的布尔值(是否需要署名、是否要求相同方式共享、是否允许衍生作品),从而方便用户大规模判断哪些照片可用于商业用途且无需 Copyleft 义务。数据集按许可证类别统计:无需署名(CC0/公有领域)5,839 张,仅需署名(CC BY 家族)6,510 张,署名+相同方式共享(CC BY-SA 家族)13,769 张,无衍生作品 0 张,需要署名但无作者记录 0 张。数据集涵盖 3,337 位摄影师,并提供了即用的信用字符串。每条记录包含以下字段:photo_id(稳定标识符)、sha256(文件哈希)、phash(64 位感知哈希,用于近重复检测)、source_page_url(Wikimedia Commons 文件页面)、source_url(图像文件 URL)、source_filename(Commons 文件名)、license_code/license_name/license_url(解析后的许可证信息)、attribution_required/share_alike/allows_derivatives(解析后的义务布尔值)、creator_name/creator_url(摄影师信息)、credit_text(即用署名字符串)、copyright_notice(版权声明)、width/height(图像尺寸)、dominant_hex(整帧主色,非车身颜色指示器)、carimages_url(在 carimages.org 上的目录页 URL)。使用示例:可通过 HuggingFace Datasets 加载并过滤出可商业使用且无 Copyleft 义务的照片。数据集以 CC0 1.0 许可证发布,元数据编译权已放弃,但照片本身仍受各自许可证保护。数据收集于 2026-07-27 至 2026-08-02,许可证解析为自动化过程,准确但不构成法律意见。数据集提供 CSV、JSON Lines 和 Frictionless Data 描述文件。建议引用 Zenodo DOI (10.5281/zenodo.21683771) 以确保可复现性。
CarImages Rights Manifest is a dataset of car photo copyright resolution index, containing metadata of 26,118 Creative Commons and public domain car photos from Wikimedia Commons. The dataset does not contain any images, only metadata and URLs, thus not propagating ShareAlike obligations. It was created to address inconsistent license records on Wikimedia Commons by parsing each photos license into three machine-readable booleans (attribution required, share-alike required, derivatives allowed), enabling users to easily determine which photos can be used commercially without Copyleft obligations. The dataset includes license category statistics: no attribution required (CC0/public domain) 5,839 photos, attribution only (CC BY family) 6,510 photos, attribution + share-alike (CC BY-SA family) 13,769 photos, no derivatives 0 photos, attribution required but no author record 0 photos. It covers 3,337 photographers and provides ready-to-use credit strings. Each record contains fields: photo_id (stable identifier), sha256 (file hash), phash (64-bit perceptual hash for near-duplicate detection), source_page_url (Wikimedia Commons file page), source_url (image file URL), source_filename (Commons filename), license_code/license_name/license_url (parsed license information), attribution_required/share_alike/allows_derivatives (parsed obligation booleans), creator_name/creator_url (photographer info), credit_text (ready-to-use attribution string), copyright_notice (copyright notice), width/height (image dimensions), dominant_hex (overall frame dominant color, not a car body color indicator), carimages_url (catalog page URL on carimages.org). Usage example: load via HuggingFace Datasets and filter for commercially usable photos without Copyleft obligations. The dataset is released under CC0 1.0 license, with metadata compilation rights waived, but photos themselves are protected by their respective licenses. Data collected from 2026-07-27 to 2026-08-02, license parsing is automated and accurate but does not constitute legal advice. The dataset is provided in CSV, JSON Lines, and Frictionless Data description files. Suggested citation: Zenodo DOI (10.5281/zenodo.21683771) for reproducibility.
数据集概述
CarImages Rights Manifest 是一个由 carimages.org 发布的权利解析索引,涵盖 26,118 张来自 Wikimedia Commons 的 Creative Commons 和公有领域汽车照片。该数据集不包含任何图像,仅包含元数据和 URL,因此不会对使用者产生 ShareAlike 义务。每张照片仍受其各自行中记录的许可证约束,其中 license_url 字段为权威依据。
许可证与义务分布
数据集将每个许可证解析为三个机器可读的义务布尔值,分布如下:
| 义务类型 | 照片数量 |
|---|---|
| 无需署名(CC0 / 公有领域) | 5,839 |
| 仅需署名(CC BY 系列) | 6,510 |
| 署名 + 相同方式共享(CC BY-SA 系列) | 13,769 |
| 禁止演绎(NoDerivatives) | 0 |
| 要求署名但未记录作者 | 0 |
数据集记录了 3,337 位摄影师的署名信息。
数据集内容
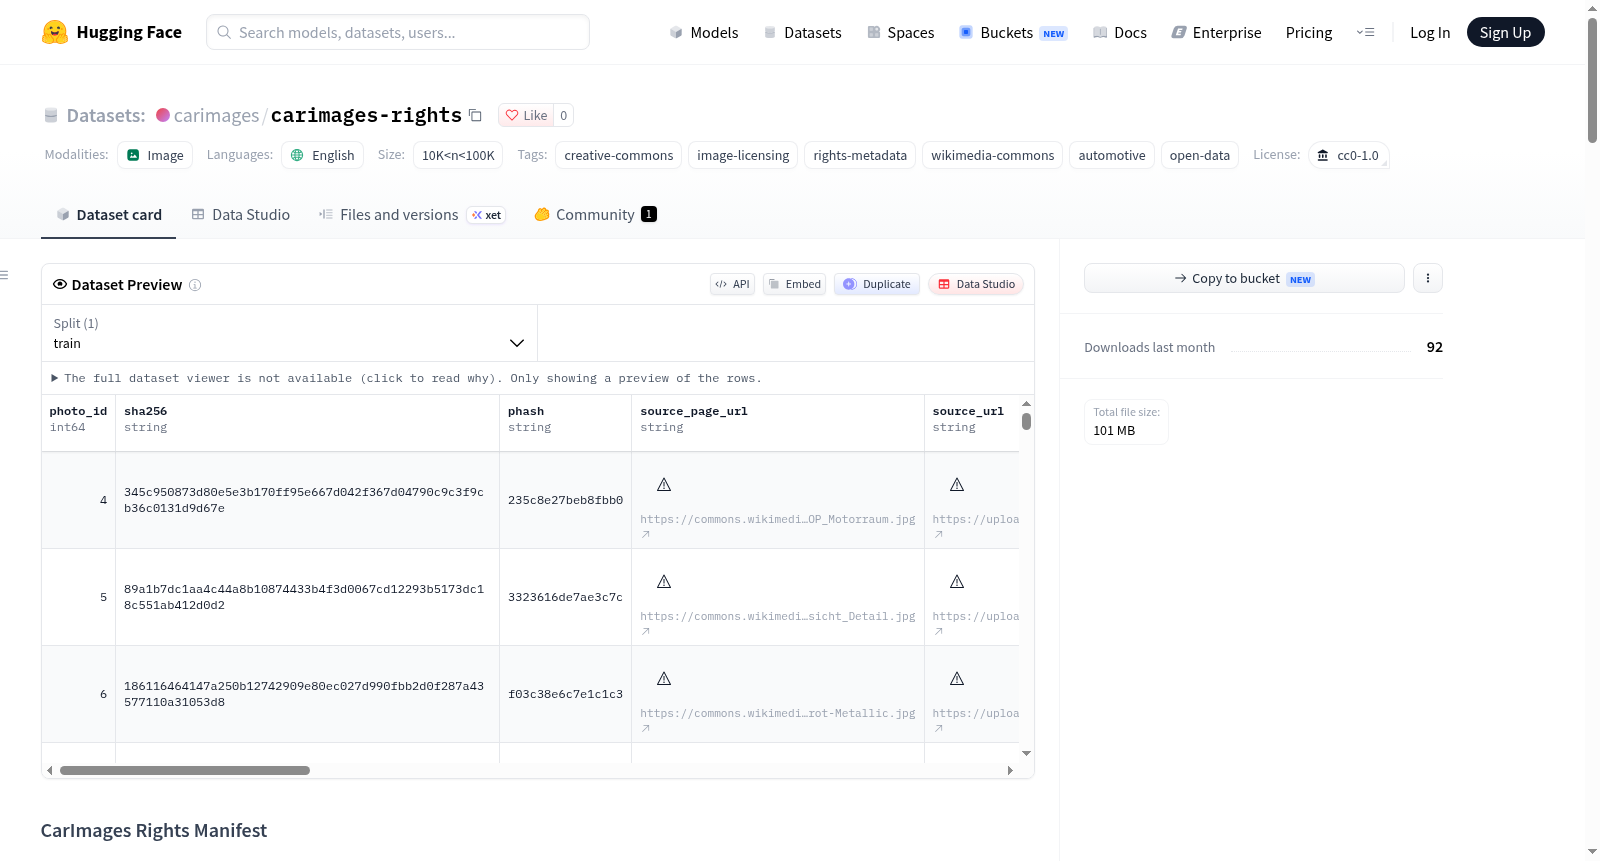
该数据集为 CSV(carimages-rights.csv)格式,每行对应一张照片,主要字段包括:
- 标识与哈希:
photo_id(稳定标识)、sha256(文件哈希)、phash(64 位感知哈希,用于近似重复检测) - 来源信息:
source_page_url(Wikimedia Commons 文件页,权威记录)、source_url(源图像文件)、source_filename(Commons 文件名) - 许可证信息:
license_code、license_name、license_url(权威许可证链接) - 义务解析:
attribution_required、share_alike、allows_derivatives - 摄影师信息:
creator_name、creator_url、credit_text(可直接使用的署名字符串)、copyright_notice - 图像属性:
width、height(固有尺寸)、dominant_hex(整帧主色调,不代表车身颜色) - 关联页面:
carimages_url(carimages.org 上的目录页,已解析许可、署名和摄影师信息)
数据来源与限制
- 数据于 2026-07-27 至 2026-08-02 从 Wikimedia Commons 抓取。
- 许可证解析为自动化处理,虽认为准确但不构成法律意见,
source_page_url为权威记录。 - 对于要求署名但未记录作者的文件已排除,因为此类文件无法合法复用。
- 数据集中摄影师贡献高度集中,使用者应予以考虑。
- 该数据集不是汽车摄影的中立样本,而是基于精选制造商类别列表抓取,并经过严格的许可证筛选。
许可声明
- 此元数据编译以 CC0 1.0(公有领域奉献)发布,同时放弃任何特殊数据库权利。
- 照片本身不受此奉献覆盖,每张照片仍需遵循其行中记录的许可证,以
license_url字段为准。 - Creative Commons 许可证仅涵盖摄影师的版权,不授予任何商标、商业外观或图像中人物/财产肖像权。
使用方式
可通过 Hugging Face datasets 库加载:
python from datasets import load_dataset ds = load_dataset("carimages/carimages-rights", split="train")
过滤出可商业使用且无 copyleft 义务的照片
permissive = ds.filter(lambda r: not r["share_alike"] and not r["no_derivatives"])
引用与版本
- 数据集可通过 Zenodo DOI 永久引用:https://doi.org/10.5281/zenodo.21683771
- 当前版本:
2026-08 - 此 Hugging Face 副本跟踪实时存档(carimages.org/data/),可能领先于 DOI 版本。引用时请使用 DOI 以获得可复现性。
- 文件包含:CSV、JSONL(相同记录)及
datapackage.json(Frictionless Data 描述符)。
相关资源