遇见数据集

metaeval/spartqa-yn

收藏
Hugging Face2023-03-13 更新2024-03-04 收录
官方服务:

资源简介:

--- license: apache-2.0 --- ``` @inproceedings{mirzaee-etal-2021-spartqa, title = "{SPARTQA}: A Textual Question Answering Benchmark for Spatial Reasoning", author = "Mirzaee, Roshanak and Rajaby Faghihi, Hossein and Ning, Qiang and Kordjamshidi, Parisa", booktitle = "Proceedings of the 2021 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies", month = jun, year = "2021", address = "Online", publisher = "Association for Computational Linguistics", url = "https://aclanthology.org/2021.naacl-main.364", doi = "10.18653/v1/2021.naacl-main.364", pages = "4582--4598", } ```

许可证:Apache-2.0 @inproceedings{mirzaee-etal-2021-spartqa, 标题 = "{SPARTQA}:面向空间推理(Spatial Reasoning)的文本问答(Textual Question Answering)基准数据集", 作者 = "罗沙纳克·米尔扎伊(Roshanak Mirzaee)、侯赛因·拉贾比·法吉希(Hossein Rajaby Faghihi)、宁强(Qiang Ning)、帕里萨·科德贾什迪(Parisa Kordjamshidi)", 会议论文集名称 = "《2021年计算语言学协会北美分会人类语言技术会议论文集》", 发表月份 = "6月", 发表年份 = "2021", 举办地点 = "线上", 出版机构 = "计算语言学协会", 资源链接 = "https://aclanthology.org/2021.naacl-main.364", 数字对象标识符(DOI) = "10.18653/v1/2021.naacl-main.364", 页码 = "4582-4598", }

提供机构:
metaeval
原始信息汇总

数据集概述

数据集名称

  • SPARTQA: A Textual Question Answering Benchmark for Spatial Reasoning

发布时间

  • June 2021

出版信息

  • Conference: 2021 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies
  • Publisher: Association for Computational Linguistics
  • URL: https://aclanthology.org/2021.naacl-main.364
  • DOI: 10.18653/v1/2021.naacl-main.364
  • Pages: 4582--4598

数据集许可

  • License: Apache-2.0
搜集汇总
数据集介绍
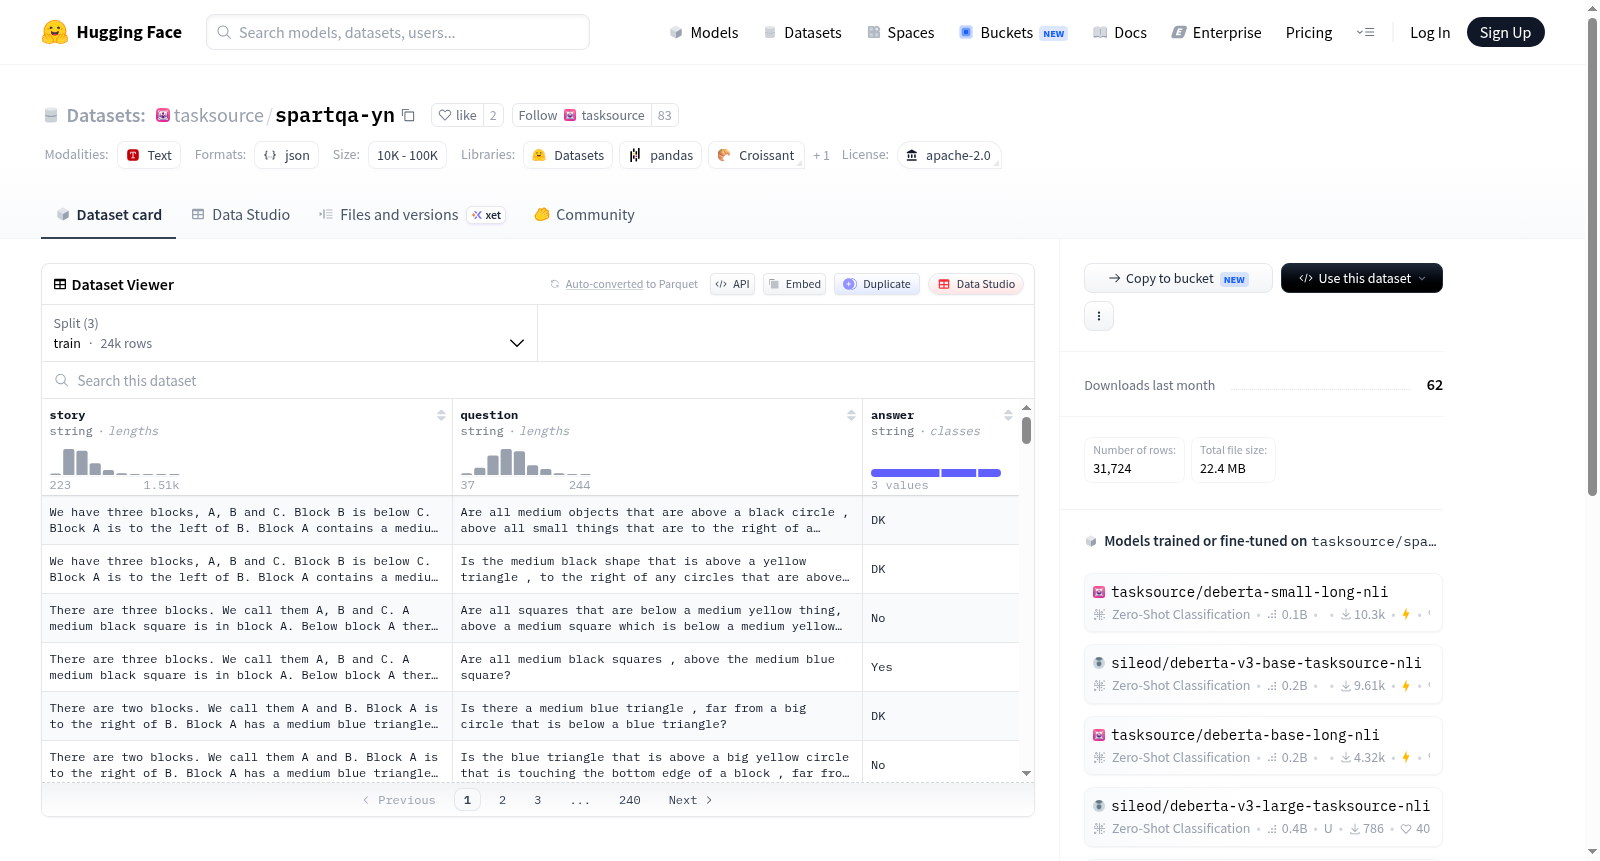
metaeval/spartqa-yn 数据集图片
构建方式
在自然语言处理领域,空间推理能力是衡量机器理解物理世界的关键维度。metaeval/spartqa-yn数据集源于SPARTOA基准,旨在评估模型对文本中空间关系的理解。该数据集通过将原始SPARTOA中的多项选择问题转化为二元是非问答形式构建而成,每个样本包含一个描述空间布局的文本段落和一个对应的是非问题,答案由人工标注确保准确性。这种转化简化了评估流程,聚焦于模型对空间前提的真假判别能力。
特点
该数据集的核心特点在于其专注的空间推理任务设计,所有问题均围绕物体间的相对位置、方向与包含关系展开,如“球是否在盒子左边”。数据集规模适中,涵盖多样化的空间场景,确保评估的全面性。此外,其二元问答格式降低了任务复杂度,使研究者能更直接地诊断模型在空间常识上的短板,成为检验语言模型几何理解力的重要试金石。
使用方法
使用metaeval/spartqa-yn数据集时,研究者可通过HuggingFace的datasets库轻松加载数据。典型流程包括将文本段落与问题拼接作为输入,利用预训练语言模型生成二分类预测(是/否),并与标准答案对比计算准确率。该数据集适用于微调或零样本评估,尤其适合分析模型在空间推理任务上的表现,为改进神经符号方法或增强语言模型的物理世界建模能力提供基准参考。
背景与挑战
背景概述
在自然语言处理领域,空间推理能力是衡量机器理解物理世界与语言描述之间映射关系的关键维度。由Roshanak Mirzaee、Hossein Rajaby Faghihi、Qiang Ning和Parisa Kordjamshidi等研究人员于2021年在NAACL会议上提出的SPARTQA数据集,旨在系统性地评估文本问答模型在空间关系理解上的表现。该数据集由密歇根州立大学等机构主导构建,核心研究问题聚焦于如何通过自然语言描述来检验模型对物体间方位、距离及拓扑关系的认知能力。SPARTQA的问世填补了当时缺乏大规模、高质量空间推理问答基准的空白,推动了对预训练语言模型在结构化空间知识建模方面的深入探究,成为后续空间语义理解研究的参照标杆。
当前挑战
SPARTQA数据集所解决的领域挑战在于,传统问答基准多侧重事实检索或常识推理,而对空间关系的精确表征与逻辑推演关注不足。模型需从文本中解析出物体间复杂的相对位置关系(如“在...左边”、“穿过”等),并应对三维空间到二维语言的映射歧义。在构建过程中,研究人员面临两大挑战:一是如何设计具有明确空间约束的问答模板,以避免语言先验导致的虚假关联;二是确保生成的样本具有高度多样性和空间一致性,需通过人工校验与自动化规则相结合的方式,平衡数据规模与标注精度。这些难题使得SPARTQA的构建成为对空间语义建模的一次严苛考验。
常用场景
经典使用场景
SPARTQA-yn 数据集是面向空间推理的文本问答基准,经典使用场景聚焦于评估语言模型在自然语言描述中理解空间关系的能力。该数据集基于合成故事构建,要求模型回答关于物体位置、方向及相对布局的是非型问题,例如判断“球是否在盒子的左边”。其设计剥离了视觉线索,纯粹依赖文本语义推理,从而成为测试神经符号系统、预训练语言模型(如BERT、RoBERTa)空间理解力的标杆任务。
解决学术问题
该数据集核心解决了自然语言处理中空间常识推理的评估缺失问题。传统问答基准多侧重事实检索或简单逻辑,而SPARTQA-yn 聚焦于空间语义的细粒度理解,揭示了现有模型在方位词(如“左/右”)、拓扑关系(如“在…之上”)及多步空间推断上的显著短板。其意义在于推动了语言模型从表面模式匹配向结构化空间认知的转型,为评估机器智能的具身推理能力提供了可量化的实验平台。
衍生相关工作
SPARTQA-yn 衍生了一系列经典工作,包括将其扩展为多选格式的SPARTQA-MC以增加推理复杂度,以及融合视觉与文本模态的CLEVR-Ref+等空间问答任务。研究者还基于该数据集开发了专门的空间关系图网络(Spatial Relation Graph Networks)和神经符号推理器,通过显式建模空间谓词逻辑来提升模型的可解释性。这些工作共同构筑了空间语言理解领域的研究脉络。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务