
mm-eval/EndoBench
收藏官方服务:
资源简介:
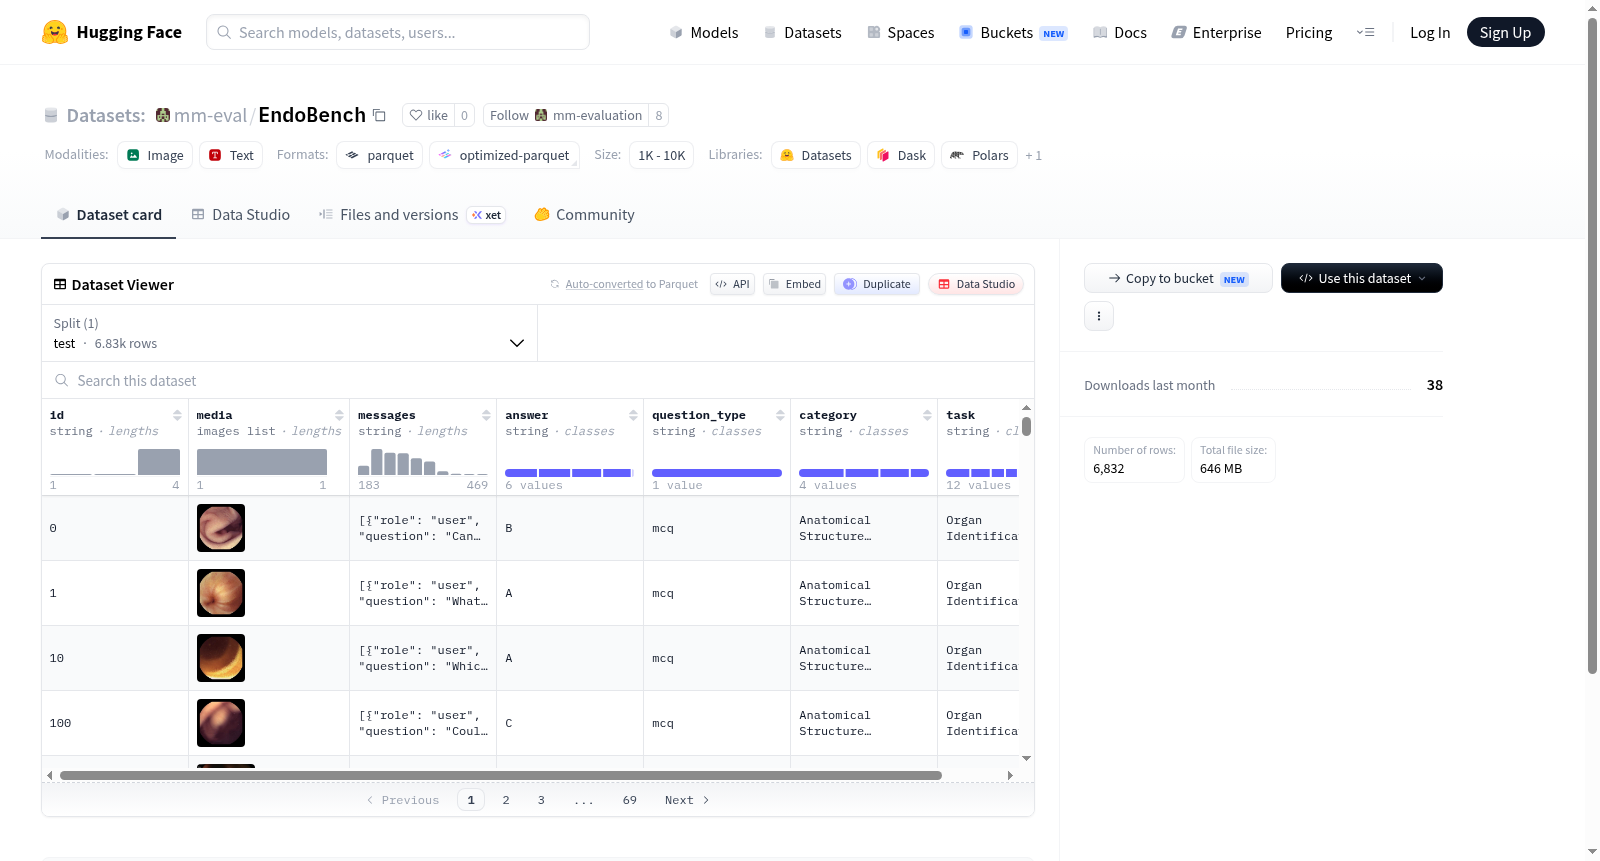
该数据集是一个多模态数据集,包含图像和文本消息。它主要由id、media(图像列表)和messages(字符串)三个特征组成,用于测试目的,目前仅提供测试分割,包含6832个示例,总大小约为647MB。数据集可能适用于图像-文本交互任务,但具体应用场景未在README中明确说明。
This dataset is a multimodal dataset comprising images and text messages. It consists of three main features: id, media (a list of images), and messages (strings), designed for testing purposes. Currently, it only includes a test split with 6,832 examples and a total size of approximately 647MB. The dataset may be suitable for image-text interaction tasks, though specific application scenarios are not explicitly mentioned in the README.
提供机构:
mm-eval搜集汇总
数据集介绍
构建方式
EndoBench数据集是基于内窥镜影像领域构建的高质量多模态问答基准,由6832个精心标注的样本组成,涵盖了内窥镜检查过程中可能出现的各类临床问题。每个样本均包含唯一的标识符、内窥镜图像、用户提出的自然语言问题、标准答案、问题类型、类别归属以及具体任务标签。数据集以JSON格式组织,采用图像和文本对齐的方式,确保视觉信息与语义信息的深度融合。所有样本统一划分为测试集,以支持对内窥镜视觉语言模型性能的标准化评估。
使用方法
使用EndoBench数据集时,研究者需加载包含图像和对应问题文本的样本,通过多模态模型对图像与问题联合编码后生成答案,并与数据集提供的标准答案进行对比以评估性能。数据集以HuggingFace Datasets库的格式分发,支持通过load_dataset函数直接加载default配置下的测试分片。由于数据集已预先划分为统一格式,用户无需额外清洗,即可快速开展内窥镜领域的视觉问答、图像描述或临床决策支持任务的模型评测实验。
背景与挑战
背景概述
内窥镜影像在临床诊断与微创手术中扮演着至关重要的角色,然而该领域长期面临标注数据匮乏、任务多样性不足等瓶颈。为应对这一挑战,EndoBench数据集应运而生,由国际医疗影像研究团队于近期构建并发布。该数据集聚焦于胃肠道内镜影像的多模态理解,涵盖6832个测试样本,每个样本包含图像、问题类型、任务类别与参考答案等结构化信息,旨在推动视觉语言模型在内镜下游任务(如病灶识别、手术指令理解)中的泛化能力。EndoBench的出现填补了内镜领域缺乏标准化多模态基准数据集的空白,为评估模型在真实临床场景下的表现提供了可靠平台,有望加速智能内镜辅助系统的研发进程。
当前挑战
当前内窥镜影像分析面临两大核心挑战。其一,临床场景中的病灶形态多变、光照不均、黏膜纹理复杂,致使图像分类与问答任务极易受到噪声干扰,现有模型在细粒度语义理解上仍存在显著精度瓶颈。其二,构建该数据集时需克服医学数据隐私保护与专家标注成本高昂的矛盾,团队不仅需确保6832例样本涵盖足够多样化的病变类型,还需统一不同内镜设备采集图像的色彩与尺度差异,并设计合理的问题类型分布以模拟真实医患对话逻辑,这些因素共同决定了数据集的构建难度与后续推广潜力。
常用场景
经典使用场景
在内窥镜影像分析这一前沿领域,EndoBench数据集以其精心设计的问答案例,成为评估和推动多模态大语言模型在医学图像理解中表现的核心基准。该数据集汇聚了涵盖不同解剖结构、病理特征及手术场景的内窥镜图像,并配以精准的语义描述和问答对,使得研究者能够系统地测试模型在细粒度视觉识别、医学知识推理及情境感知回应上的能力。其典型用法包括作为微调医学视觉语言模型的训练资源,或作为标准化评测平台,用以比较不同架构在消化内镜、腹腔镜等亚专科任务上的诊断与解说精准度。
解决学术问题
EndoBench直面内窥镜机器人领域中普遍存在的标注匮乏与评价标准不统一的学术困境。通过提供包含多种问题类型(如病理分类、手术阶段识别、器械定位)的结构化样本,它解决了先前数据集仅聚焦单一任务、难以支撑综合性能力评估的局限。该数据集的意义在于为多模态学习在微创手术辅助决策中的可靠性研究建立了可复现的标杆,推动了由纯视觉模型向语言-视觉融合范式的转变,进而促进了可解释人工智能在临床内窥镜分析中的理论发展。
实际应用
在临床实践层面,EndoBench所支撑的模型可直接嵌入消化内镜检查或腹腔镜手术的辅助系统中,用于实时标签病灶、自动生成手术报告,以及为年轻医师提供解剖结构识别训练。例如,基于该数据集训练的视觉语言模型能够根据实时内窥镜画面,以自然语言反馈息肉类型、炎症程度或手术器械位置,从而减少医生在操作中的认知负荷。此外,这类技术还被探索用于远程会诊场景,通过自动生成结构化病程摘要提升跨院区协作效率。
数据集最近研究
最新研究方向
EndoBench作为内窥镜影像领域的基准数据集,正推动着手术视觉理解与智能辅助诊断的前沿探索。当前研究聚焦于利用该数据集构建多模态大语言模型,通过解析内窥镜图像中的解剖结构与病理特征,实现术中实时问答与决策支持。其涵盖的多样化任务与精细标注体系,为评估模型在少样本学习、跨域泛化及不确定性校准等复杂场景下的表现提供了标准化测试平台。随着微创手术智能化需求的激增,该数据集在促进手术机器人自主感知、降低操作风险以及加速临床AI落地方面具有里程碑意义,尤其为应对手术视野有限、光照不均等泛化挑战开辟了新的优化路径。
以上内容由遇见数据集搜集并总结生成


