
sjleslie/random_cv_7_bins_long_52
收藏官方服务:
资源简介:
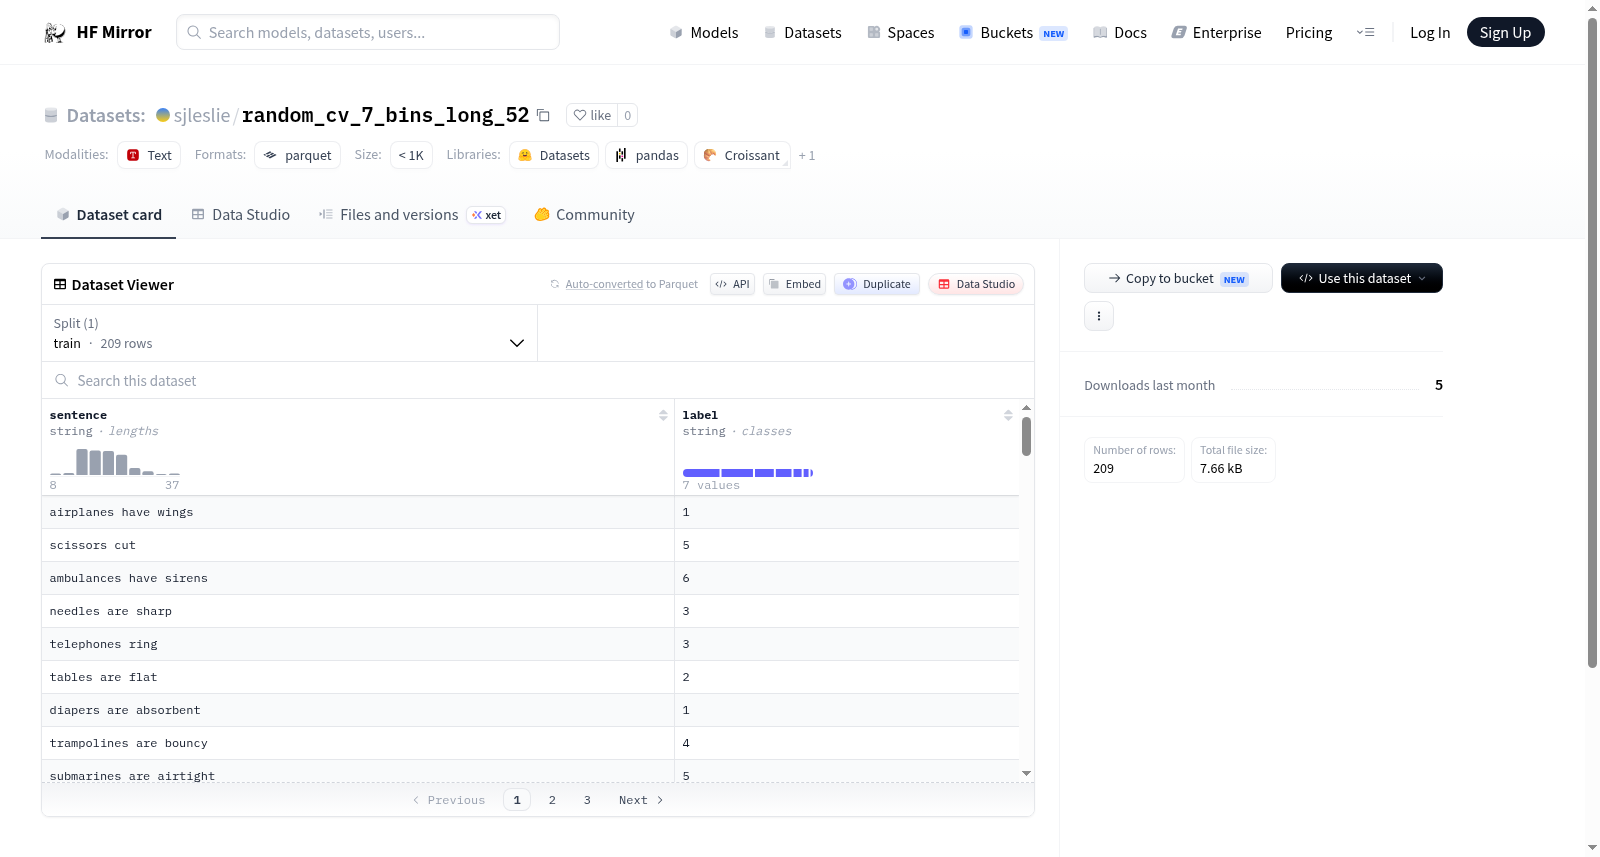
这是一个包含句子和标签的数据集,用于训练模型。数据集分为训练集,共有209个样本,文件大小为6084字节。
This is a dataset containing sentences and labels for training models. It is split into a training set with a total of 209 samples and a file size of 6084 bytes.
提供机构:
sjleslie搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集是一个小型文本分类数据集,包含209个短句文本,每个句子描述简单事实或属性,对应7个分类标签(1到7)。数据以parquet格式存储,适用于多分类任务,如自然语言处理中的句子分类。
以上内容由遇见数据集搜集并总结生成


