rradyu-tis-snat
收藏资源简介:
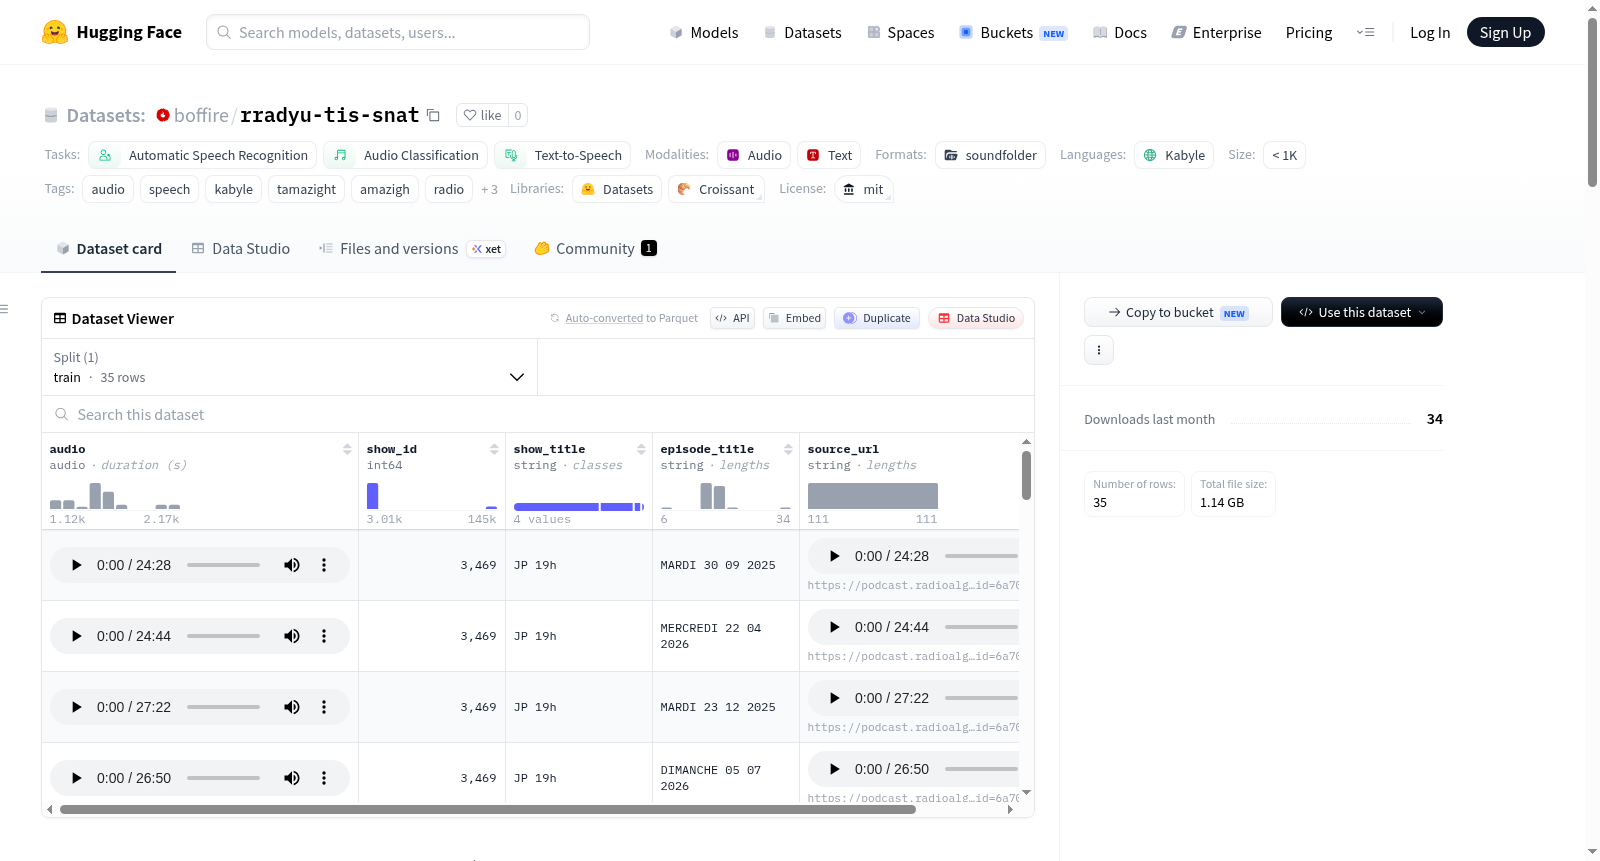
Rradyu Tis Snat 是一个卡拜尔语(Kabyle,属于塔马齐特语/柏柏尔语)播客音频数据集,收录自阿尔及利亚国家广播电台 Chaîne 2 的公开播客页面。该电台主要使用塔马齐特语(包括卡拜尔语)进行广播。数据集旨在支持低资源语言的自动语音识别(ASR)、音频分类(如语言识别、节目类型分类)以及文本转语音(TTS)等任务。数据仅包含音频(mp3格式),无对应转录文本。音频内容涵盖新闻简报、脱口秀、文化宗教节目和杂志类节目,每集时长通常为15-30分钟。数据集当前规模小于1K条记录,尚在扩充中。数据按节目(show)分组,每个节目下存放对应剧集的mp3文件,根目录下提供metadata.csv文件,遵循AudioFolder规范,可通过HuggingFace Datasets库直接加载。字段包括:file_name(音频文件相对路径)、show_id(节目在源站点的内部ID)、show_title(节目名称)、episode_title(剧集标题/日期)、source_url(原始mp3 URL)。数据收集采用启发式标题过滤,仅保留明确标记为卡拜尔语的节目,但可能混入少量其他语言或方言的片段。数据集目前未划分训练/验证/测试集,未提供时长、采样率等元数据,也未进行语音活动检测(VAD)分段。使用注意事项:版权/许可问题尚未明确,当前仅限研究用途,不可用于商业或公开分发;音频质量源自原始电台编码(mp3),未进行再编码以避免进一步损失;建议下游用户自行进行语音分割和转录。
Rradyu Tis Snat is a Kabyle (a dialect of Tamazight/Berber) podcast audio dataset collected from the public podcast page of Algerias national radio station Chaîne 2, which primarily broadcasts in Tamazight (including Kabyle). The dataset aims to support automatic speech recognition (ASR), audio classification (e.g., language identification, program type classification), and text-to-speech (TTS) for low-resource languages. The data consists only of audio (mp3 format) without corresponding transcriptions. Audio content includes news briefs, talk shows, cultural and religious programs, and magazine-style programs, with each episode typically lasting 15–30 minutes. The dataset currently contains fewer than 1K records and is still being expanded. Data is organized by show, with mp3 files for each episode stored under the corresponding show directory, and a metadata.csv file at the root directory following the AudioFolder specification, enabling direct loading via the HuggingFace Datasets library. Fields include: file_name (relative path of audio file), show_id (internal ID of the show on the source site), show_title (show name), episode_title (episode title/date), and source_url (original mp3 URL). Data collection used heuristic title filtering to retain only shows explicitly marked as Kabyle, but may include small amounts of other languages or dialects. The dataset is not currently split into train/validation/test sets, does not provide metadata such as duration or sample rate, and has not undergone voice activity detection (VAD) segmentation. Usage notes: copyright/license issues are not yet clarified; currently limited to research purposes only, not for commercial or public distribution; audio quality comes from the original station encoding (mp3) and has not been re-encoded to avoid further loss; downstream users are advised to perform their own speech segmentation and transcription.
数据集概述:Rradyu Tis Snat
Rradyu Tis Snat 是一个卡拜尔语(Taqbaylit)音频播客数据集,音频内容来源于阿尔及利亚公共广播电台 Radio Algérie Chaîne 2 的播客页面。该电台主要使用塔马齐特语(柏柏尔语变体)播出,其中卡拜尔语是主要语言。
基本信息
- 语言:卡拜尔语(
kab),属北部柏柏尔语(塔马齐特/阿马齐格语),主要在阿尔及利亚卡拜利地区使用。 - 领域:广播语音,涵盖新闻简报、脱口秀、文化及宗教节目、杂志类节目。
- 模态:仅音频(MP3 格式),当前不包含转写文本。
- 许可证:MIT
- 任务类别:自动语音识别、音频分类、文本转语音
数据集结构
音频文件按广播节目分组存放于 data/<show-slug>/ 目录下,仓库根目录包含一个 metadata.csv 文件,遵循 Hugging Face AudioFolder 约定,可直接通过 load_dataset("boffire/rradyu-tis-snat") 加载。
数据字段:
| 字段 | 类型 | 说明 |
|---|---|---|
file_name |
string | 音频文件的相对路径 |
show_id |
int | 节目在 radioalgerie.dz 上的内部 ID |
show_title |
string | 广播节目/栏目名称 |
episode_title |
string | 节目集标题或发布日期 |
source_url |
string | radioalgerie.dz 上的原始 MP3 链接 |
数据划分:目前无训练/验证/测试划分,为单一未分割集合。
数据收集过程
音频文件直接从 Radio Algérie Chaîne 2 的公开播客页面抓取。节目通过启发式规则过滤:排除明确标注为其他语言或柏柏尔语变体的节目(如莫扎比特语、沙维语、图阿雷格语、阿拉伯语、法语节目),其余节目假定为卡拜尔语。
注意:此过滤基于节目标题的启发式判断,并非逐集语言验证,可能存在少数分类错误的集数。
使用注意事项
许可与权利:音频来自阿尔及利亚国有公共广播电台,重分发条款尚未确认。在当前未明确之前,应将此仓库视为仅供私人/研究用途,不得假定为可自由复用。
已知限制:
- 节目级语言过滤可能包含少量非卡拜尔语集数
- 无转写文本、说话人标签或内容审核
- 集数通常为长格式(15–30分钟),大多数 ASR/微调流程需要进一步分段处理
- 音频质量为原始广播 MP3 编码,未进行重新编码以避免进一步有损降质
数据来源:Radio Algérie Chaîne 2 播客页面(podcast.radioalgerie.dz)
仓库地址:https://huggingface.co/datasets/boffire/rradyu-tis-snat
当前状态
该数据集为进行中项目,README 标注多处 TODO 待完善,包括:许可证确认、时长/采样率/声道等字段增加、数据划分定义、策展人信息、引用格式、变更日志等。