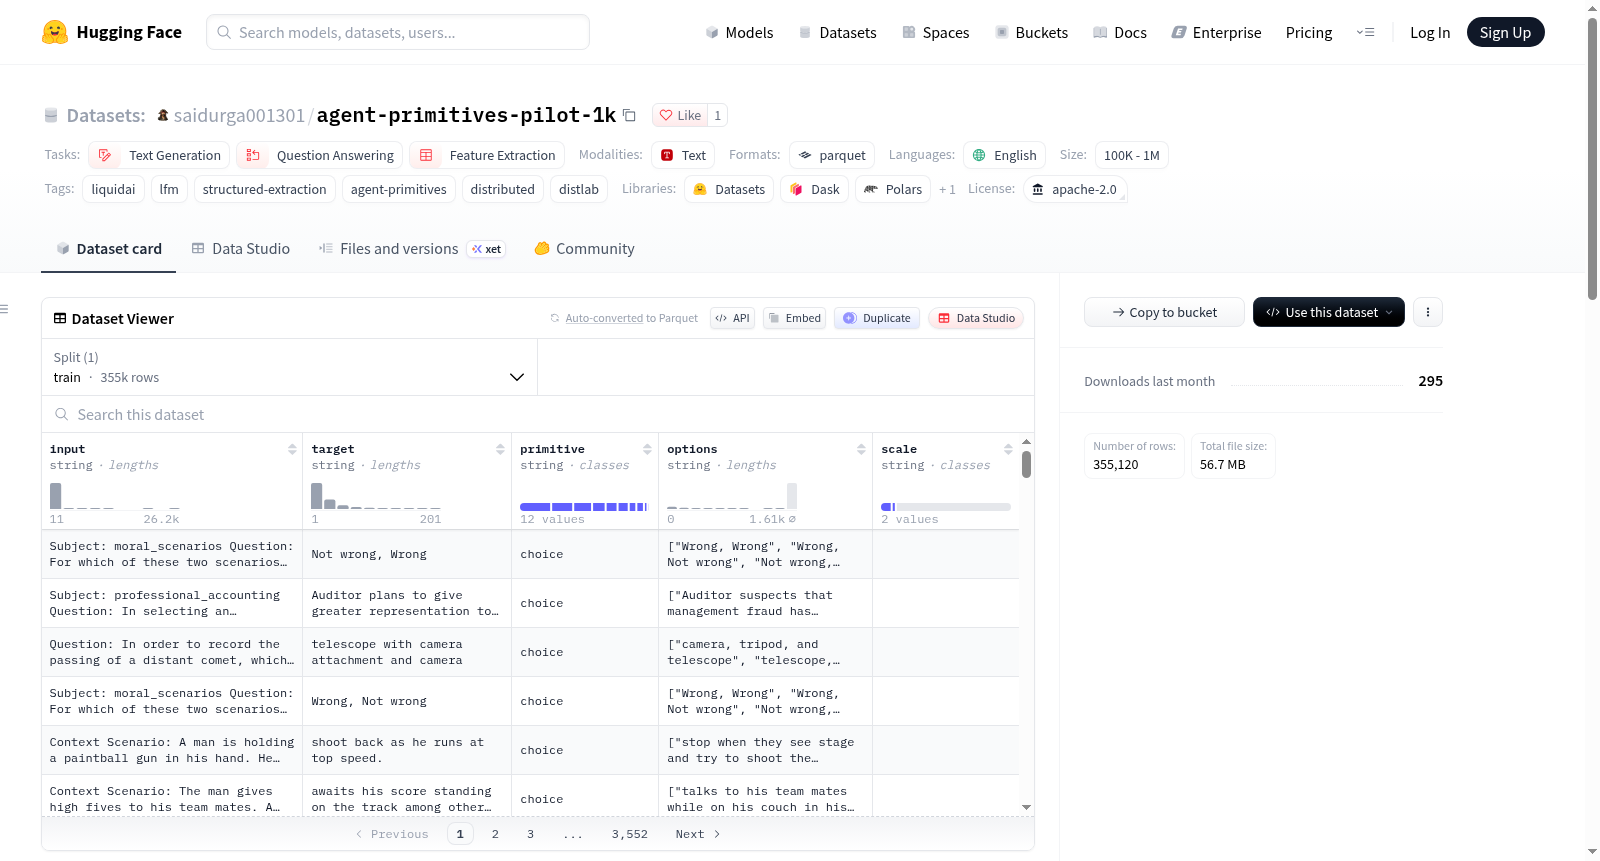
agent-primitives-pilot-1k
收藏资源简介:
Agent Primitives Pilot: High-Entropy Extraction Dataset 是一个高保真智能体抽取数据集,专门面向小型、超快速语言模型与混合模型进行整理和对齐,例如 Liquid AI LFM2-1.2B-Extract 和 LFM3-1.7B。其目标是促使模型执行简洁、无幻觉的原始抽取(primitive extraction)。数据集中所有合成退化循环、流式重复和填充伪影均已被永久剔除,并且每个目标都严格满足不超过 32 token 的长度上限,部分原语的上限更短。数据集共包含 305,063 条干净样本,规模类别为 100K<n<1M,语言为英语,许可协议为 apache-2.0;任务类别包括 text-generation、question-answering 和 feature-extraction;标签包括 liquidai、lfm、structured-extraction、agent-primitives、distributed 和 distlab。数据集由 8 类原语构成:INT 有 99,162 条,占 32.51%,来自 MetaMathQA,目标为确定性整数答案,上限为 ≤12 token;SPAN 有 86,580 条,占 28.38%,来自 SQuAD v2,目标为逐字事实性文档答案片段,上限为 ≤32 token;STRUCT 有 59,270 条,占 19.43%,来自 LiquidAI/structured-extraction,目标为紧凑 JSON 键值抽取,上限为 ≤32 token;CODE 有 28,769 条,占 9.43%,来自 Romit2004/LinuxCommands 和 Glaive,目标为 Linux 命令与工具调用参数,上限为 ≤32 token;STR 有 9,575 条,占 3.14%,来自 SciQ 和 IETF RFCs,目标为科学与技术字符串抽取,上限为 ≤20 token;NOUL 有 8,553 条,占 2.80%,涉及显式非幻觉弃答,包括 null、BoolQ 与缺失 schema 字段,上限为 1 token;CHOICE 有 7,214 条,占 2.36%,来自 Fastino fast-decisions,目标为快速决策路由和工具名称选择,上限为 ≤6 token;REPLAY 有 5,940 条,占 1.95%,来自 Databricks Dolly,目标为精确复现和逐字状态恢复,上限为 ≤32 token。该数据集通过 distlab 分布式集群引擎进行处理与验证,使用 32 个空闲计算节点(384 CPU 核);主节点为 10.5.16.86,负责编排、切片、parquet 编码与上传;32 个 worker 节点仅使用标准库,在 ~/.work/ 内运行,不触碰宿主目录;通过 distlab submit --batch 并发调度 32 个任务,Batch ID 为 b_1031_185710_e3da,4.8 秒完成,32/32 成功,0 失败;目标验证显示目标 token 违规为 0,即 >32 token 的占比为 0.00%。README 的 Quickstart 示例展示使用 datasets.load_dataset 加载 saidurga001301/agent-primitives-pilot-1k,设置 data_dir=data_compact、split=train,并查看总行数与样本。该数据集适用于面向智能体原语抽取的文本生成、问答、结构化抽取、工具调用与路由、弃答以及状态复现等任务。说明:上述信息表明该数据集强调干净、短输出、无幻觉、结构化与可验证的原语抽取,适合训练或评估轻量级抽取模型和智能体基础能力。
数据集概述
- 数据集页面:https://huggingface.co/datasets/saidurga001301/agent-primitives-pilot-1k
- 数据集名称:saidurga001301/agent-primitives-pilot-1k
- 标题:Agent Primitives Pilot: High-Entropy Extraction Dataset (305k Rows)
- 总行数:305,063 条干净行
- 定位:高保真智能体抽取数据集,面向小型、超快语言和混合模型,例如 Liquid AI LFM2-1.2B-Extract 和 LFM3-1.7B
- 特点:所有合成退化循环、流式重复和填充伪影已永久剪枝;每个目标严格满足 ≤32 token 上限,以迫使模型进行简洁、无幻觉的 primitive extraction
元信息
| 项目 | 内容 |
|---|---|
| 许可证 | apache-2.0 |
| 任务类别 | text-generation、question-answering、feature-extraction |
| 语言 | en |
| 标签 | liquidai、lfm、structured-extraction、agent-primitives、distributed、distlab |
| 规模类别 | 100K<n<1M |
组成汇总
总计:305,063 条干净行
| 原语 | 样本数 | 占比 | 描述与基准来源 | 目标上限 |
|---|---|---|---|---|
| INT | 99,162 | 32.51% | 确定性整数答案(MetaMathQA) | ≤12 tokens |
| SPAN | 86,580 | 28.38% | 逐字事实文档答案片段(SQuAD v2) | ≤32 tokens |
| STRUCT | 59,270 | 19.43% | 紧凑 JSON 键值提取(LiquidAI/structured-extraction) | ≤32 tokens |
| CODE | 28,769 | 9.43% | Linux 命令与工具调用参数(Romit2004/LinuxCommands、Glaive) | ≤32 tokens |
| STR | 9,575 | 3.14% | 科学与技术字符串提取(SciQ、IETF RFCs) | ≤20 tokens |
| NOUL | 8,553 | 2.80% | 显式非幻觉弃权("null"、BoolQ 与缺失 schema 字段) | 1 token |
| CHOICE | 7,214 | 2.36% | 快速决策路由与工具名选择(Fastino fast-decisions) | ≤6 tokens |
| REPLAY | 5,940 | 1.95% | 精确复现与逐字状态恢复(Databricks Dolly) | ≤32 tokens |
分布式集群执行(distlab 编排)
- 使用
distlab分布式集群引擎处理并验证数据集。 - 计算资源:32 个空闲计算节点,384 CPU 核心。
- 主节点:
10.5.16.86,负责编排、切片、parquet 编码和上传。 - 工作节点执行:32 个节点执行纯标准库 workers,严格在
~/.work/内运行,不触碰宿主目录。 - 批次派发:32 个作业通过
distlab submit --batch并发派发,Batch ID:b_1031_185710_e3da。 - 运行时间:在 32 个节点上 4.8 秒完成,32/32 成功,0 失败。
- 目标验证:0 个目标 token 违规,>32 tokens = 0.00%。
快速使用
python from datasets import load_dataset
Load compact high-entropy shards directly:
ds = load_dataset("saidurga001301/agent-primitives-pilot-1k", data_dir="data_compact", split="train")
print(f"Total Rows: {len(ds):,}") print("Sample:", ds[0])