
juppy44/treeoflife_unique_species_wikipedia
收藏官方服务:
资源简介:
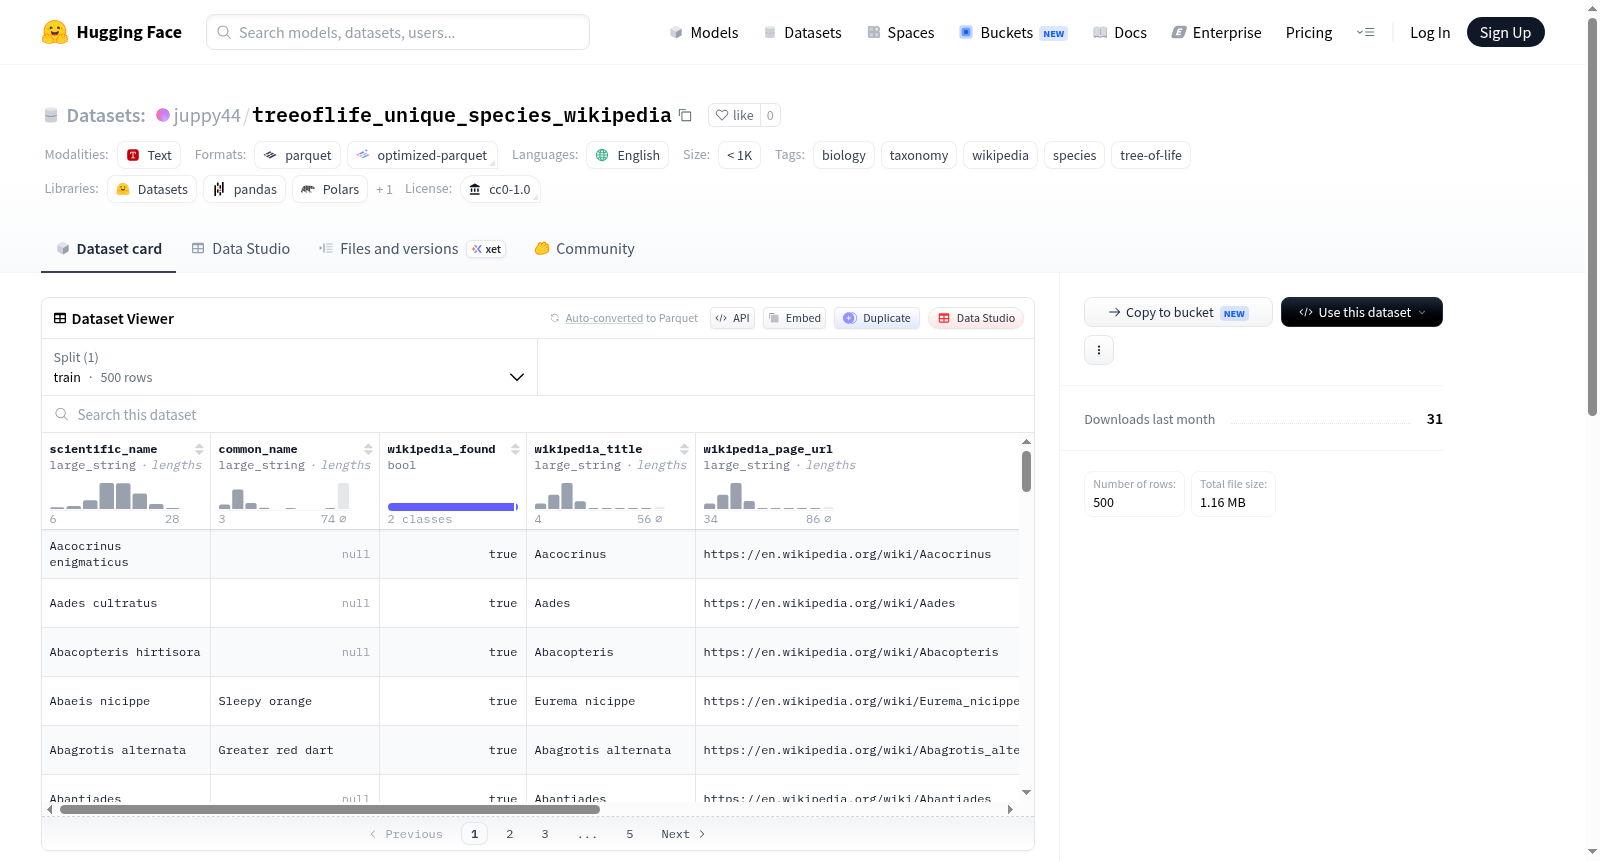
该数据集是从imageomics/TreeOfLife-200M中提取独特的科学名称和可选通用名称,然后为每个分类单元(taxon)用英文维基百科元数据进行丰富(enrichment)而生成的。它包含科学名称、通用名称、维基百科查找状态、标题、URL、描述、摘要、全文和错误信息等列,用于生物学和分类学领域,但维基百科覆盖不完整且匹配可能不完美,使用时需注意许可要求。
This dataset was generated from imageomics/TreeOfLife-200M by extracting unique scientific names and optional common names, then enriching each taxon with English Wikipedia metadata. It includes columns such as scientific name, common name, Wikipedia found status, title, URL, description, summary, full text, and error information, intended for biology and taxonomy applications, but Wikipedia coverage is incomplete and matches may be imperfect, with licensing considerations for Wikipedia text.
提供机构:
juppy44搜集汇总
数据集介绍
构建方式
该数据集源自`imageomics/TreeOfLife-200M`巨量物种图像语料库,通过系统性地抽取其中蕴含的独特学名及可选俗名,构建起初始的物种名录。进而,针对每一个分类单元,借助英语维基百科的元数据接口进行语义富集,将维基百科的标题、页面链接、描述、摘要乃至全文等结构化信息与物种名称精准关联,由此形成了兼具分类学主干与百科知识枝叶的复合型数据集。
特点
数据集的核心特色在于其横跨生物学分类体系与开放百科知识库的桥梁属性。每个物种条目不仅保留了科学命名的严谨性,还通过维基百科的文本语料获得了生态习性、地理分布等上下文描述。然而,维基百科在不同类群间的覆盖程度参差不齐,且匹配过程可能存在非精确对应,这要求使用者在关键应用场景中需进行人工核验,体现了数据集在广度与精度之间的审慎平衡。
使用方法
使用者可直接依据`scientific_name`或`common_name`字段进行物种检索,利用维基百科提供的摘要与全文信息开展文本挖掘、知识图谱构建或跨模态学习任务。对于需要高可靠性的下游应用,建议优先筛选`wikipedia_found`为真的条目,并留意`wikipedia_error`字段以排除匹配失败的记录。此外,需遵循维基百科的许可协议要求,在内容再分发或商业化使用时审慎处理文本版权问题。
背景与挑战
背景概述
该数据集源于生物分类学与自然语言处理的交叉领域,旨在弥合大规模物种图像数据与结构化文本知识之间的鸿沟。由Imageomics研究团队基于TreeOfLife-200M数据集构建,通过提取唯一科学名称及常见名称,并关联英文维基百科元数据,形成涵盖物种描述、分类层级与生态信息的富营养化资源。自发布以来,该数据集为进化生物学、生态信息学及计算机视觉中的细粒度物种识别提供了跨模态基准,尤其支撑了基于文本增强的物种表征学习研究,推动了从图像到知识图谱的语义对齐范式发展。
当前挑战
数据集面临的核心挑战在于维基百科覆盖度的不均衡性,不同类群的物种描述存在显著稀疏与缺失,导致模型训练面临长尾分布与知识真空问题。构建过程中,维基百科搜索匹配的误差率较高,同名异义或分类歧义记录可能引入噪声,需依赖人工校验高置信度样本。此外,维基百科文本的许可证兼容性要求严格限制数据再分发与商业应用,而原始TreeOfLife-200M的CC0-1.0许可与维基文本的许可冲突进一步增加了合规使用的复杂度,成为领域落地中的关键壁垒。
常用场景
经典使用场景
该数据集源自TreeOfLife-200M,通过提取独特物种的科学名称与俗名,并融入英文维基百科的元数据,构建了一个涵盖丰富生物分类信息的结构化语料库。其经典使用场景聚焦于生物信息学与自然语言处理的交叉领域,研究者可借助其中完整的维基百科文本(如摘要、全文及描述)训练物种识别模型、构建知识图谱,或作为物种间语义关联分析的基准资源。通过将分类学名称与百科文本对齐,该数据集为自动化生物分类推理、物种描述生成以及生态学文本挖掘提供了高质量的训练数据基础。
衍生相关工作
该数据集衍生出的相关工作主要包括将维基百科文本编码为特征向量以增强物种嵌入表示,从而改进跨物种相似性度量与系统发育关系推断;同时,基于其全文本语料训练的神经语言模型,可被微调用于生成标准化的物种描述,替代人工编写分类学文档的繁琐流程。此外,研究团队已利用其元数据构建了物种-属性关系抽取基准,并开发了维基百科搜索匹配的误差分析框架,为后续生物文献挖掘与知识图谱补全任务提供了方法论参照。
数据集最近研究
最新研究方向
当前,生命之树数据集的研究前沿聚焦于利用维基百科多元文本信息对生物分类进行语义增强与知识图谱构建。该数据集通过从TreeOfLife-200M中提取唯一科学名与俗名,并关联英文维基百科的元数据,为每个物种提供了丰富的描述性文本和摘要信息。这一资源极大地促进了进化生物学中跨物种比较分析、生物多样性模式挖掘以及基于自然语言的物种自动识别系统的研究。随着大语言模型与知识图谱的融合,该数据集有望成为支撑物种间关系推理、生态特征预测乃至生物信息学中文本驱动分类的重要基石,推动计算生物学与生物多样性信息学的交叉创新。
以上内容由遇见数据集搜集并总结生成


