
遇见数据集

中国法律法规与案例结构化语料库 (Chinese Law Corpus)

收藏
github2026-09-07 更新2026-09-08 收录
官方服务:

资源简介:

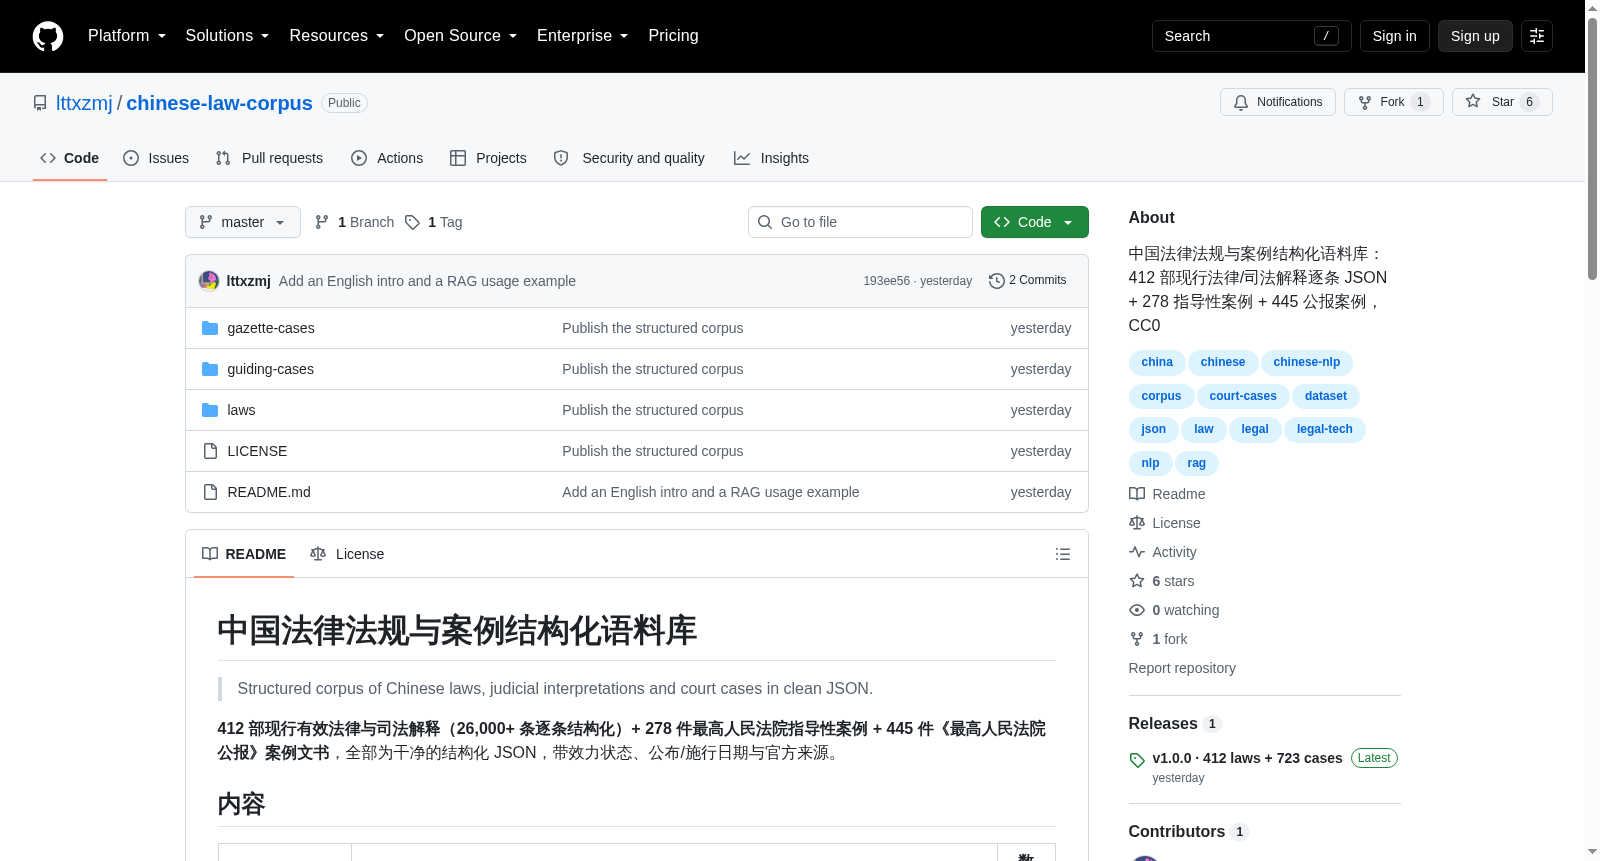
412部现行有效法律与司法解释(26,000+条逐条结构化)+ 278件最高人民法院指导性案例 + 445件《最高人民法院公报》案例文书,全部为干净的结构化JSON,带效力状态、公布/施行日期与官方来源。

This dataset includes 412 currently effective laws and judicial interpretations (over 26,000 articles fully structured on an article-by-article basis), 278 guiding cases issued by the Supreme People's Court, and 445 case documents from the Official Gazette of the Supreme People's Court. All the aforementioned materials are provided as clean, structured JSON files, with supporting metadata including validity status, promulgation/implementation dates and official sources.

创建时间:
2026-09-06
原始信息汇总

数据集概述

本数据集是一个中国法律法规与案例的结构化语料库,提供干净的 JSON 格式数据,主要面向法律研究和法律 AI 应用开发。

数据内容与规模

类别 内容 数量
法律与司法解释 现行有效国家法律 300 部 + 司法解释 112 件,逐条结构化(编、章、节、条层级) 412
指导性案例 最高人民法院指导性案例全量,含关键词、裁判要点、基本案情、裁判结果、裁判理由、关联法条 278
公报案例 《最高人民法院公报》裁判文书选登与案例,含判决文书正文与客观元数据 445

总计涵盖 26,000+ 条结构化法条。

数据质量与来源

  • 法律文本:取自国家法律法规数据库(https://flk.npc.gov.cn/)官方 docx,逐部人工核对名称与效力状态,不含失效法规。
  • 案例数据:取自最高人民法院官方站点,解析零缺段,已统一处理四代页面排版差异。
  • 条文 ID:使用稳定 ID(如 civil-code-0577 = 民法典第五百七十七条),跨版本可引用。
  • 更新频率:法律季度更新,案例随官方发布更新。

JSON 结构示例

以下为法律文件的结构示例:

jsonc { "id": "civil-code", "title": "中华人民共和国民法典", "issuingAuthority": "全国人民代表大会", "promulgationDate": "2020-05-28", "effectiveDate": "2021-01-01", "status": "现行有效", "articleCount": 1260, "articles": [{ "id": "civil-code-0001", "number": "第一条", "text": "…" }] }

查询示例(使用 jq):

bash jq .articles[] | select(.id=="civil-code-0577") laws/civil-code.json

数据应用

适合用于法律 RAG(检索增强生成)、检索基准测试和基于引用的生成任务。天然的法条 chunk 边界便于构建向量检索,示例 Python 代码可生成 26,000+ 文本块。

版权与许可

  • 法律、法规与司法文书依《中华人民共和国著作权法》第五条不适用著作权保护。
  • 本仓库对数据的整理与结构化部分以 CC0 1.0(https://creativecommons.org/publicdomain/zero/1.0/)释出,可自由使用(含商用),无需署名。
  • 《公报》案例仅收录司法文书内容与客观元数据,编辑加工的「裁判摘要」未收录。
  • 本仓库为非官方整理,正式引用请以国家法律法规数据库(https://flk.npc.gov.cn/)与最高人民法院官方发布为准。

维护方

由法脉 LawPulse(https://lttxzmj.github.io/lawpulse-site/)整理与维护,这是一款面向中国执业律师的本地优先桌面研究工具,该数据集为其内置法律库。
搜集汇总
数据集介绍
中国法律法规与案例结构化语料库 (Chinese Law Corpus) 数据集图片
构建方式
该语料库的构建依托官方权威信源,法律文本悉数采撷自国家法律法规数据库的官方docx文件,并经由人工逐部核验名称与效力状态,杜绝失效法规混入。案例部分则源自最高人民法院官方站点,通过统一处理历代页面排版差异,确保解析过程零缺段,完整保留文书原貌。条文采用稳定标识符体系,如以‘civil-code-0577’指代民法典第五百七十七条,实现跨版本的可引用性。语料库涵盖412部现行有效法律与司法解释、278件指导性案例以及445件公报案例,全部转化为层次分明的JSON结构,其中法律条文依编、章、节、条逐层拆解,案例则细分出关键词、裁判要点等核心字段,形成一部系统化、颗粒度精细的法律知识宝库。
特点
该数据集的核心特色在于其纯净度与结构化深度,堪称法律领域知识工程的典范。法律文本全部源自官方渠道,经过严格人工校对,确保效力状态准确无误;案例文书解析完整,无缺段遗漏,且随官方发布持续更新,保持数据的时效性。稳定的条文ID设计赋予每一法条唯一身份,为法律检索增强生成(RAG)系统提供了天然的切分边界,一条即为一则独立知识单元,极大便利了自动索引与精准引用。此外,数据以CC0协议释出,彻底消除版权壁垒,使得法律科技研究者与商业应用能够自由取用,无署名负担,有力推动法律人工智能的研发进程。
使用方法
数据集的调用简便灵活,既可直接通过文件系统访问,也可借助命令行工具高效操作。例如,研究人员可利用jq指令如jq '.articles[] | select(.id=="civil-code-0577")' laws/civil-code.json精准提取特定法条。在Python环境下,通过glob与json模块即可将全部法律条文加载为片段列表,形成逾两万六千个检索单元,适配下游的索引构建或模型训练。案例文件同样遵循清晰字段结构,便于进行裁判要点的语义分析或类案检索。用户仅需按目录组织(laws、guiding-cases、gazette-cases)即可无缝集成至自有数据处理管线,实现法律知识的高效利用与再创造。
背景与挑战
背景概述
中国法律法规与案例结构化语料库(Chinese Law Corpus)由法脉 LawPulse 团队于近年整理并持续维护,旨在为法律人工智能与法律科技研究提供高质量、结构化的中文法律数据基础。该语料库涵盖412部现行有效的国家法律与司法解释(26,000+条文)、278件最高人民法院指导性案例及445件《最高人民法院公报》案例文书,数据源自国家法律法规数据库等官方权威来源,经人工核对与结构化处理,具有条文级稳定标识,便于法律检索、裁判预测及基于引用的生成任务。其发布填补了中文法律领域缺乏公开、结构完整且持续更新的数据集的空白,对法律自然语言处理、法律知识图谱构建及智能法律助手研发具有重要推动作用,成为连接法律文本与计算方法的桥梁。
当前挑战
该数据集面临的挑战多维且复杂。在领域问题层面,中国法律文本具有层级嵌套(编、章、节、条)与效力动态变化(如修订、废止)的特性,要求精确建模条文间引用关系及效力状态,而现有通用文本处理技术难以直接应对。此外,案例文书体量庞大、叙述冗杂,裁判要点与案件事实的抽取需兼顾法律逻辑与语言变体,对语义理解提出高要求。在构建过程中,数据整合需处理不同来源(如法律数据库与法院官网)页面排版差异,确保解析零缺段;对已失效法规的剔除依赖人工逐部核对,耗时费力;同时,案例更新频率与法律修订速度不匹配,需要持续动态维护以保证数据集时效性。这些挑战共同构成了数据集持续优化的难点,也为其在真实法律场景中的可靠应用设置了门槛。
常用场景
经典使用场景
该数据集以其精细的结构化法律文本与案例文书,为法律人工智能研究提供了天然的语料基础。在经典使用场景中,研究者常将其用作法律检索增强生成(RAG)系统的评估基准,以条文为单位进行切割,形成多达两万六千余个语义完整的语块,进而检验模型在法条定位、关联推理与裁判文书摘要生成等任务上的性能。同时,稳定的法条ID设计便于跨版本追踪与引用,使得该数据集成为法律文本挖掘、知识图谱构建以及司法问答系统开发的理想资源,支撑了从数据预处理到模型微调的全流程研究范式。
实际应用
在实际应用中,该语料库成为法律科技产品研发的重要基石。它被整合进面向执业律师的智能研究工具,支持离线法律速查、法条笔记构建与合同审查的自动提示,显著提升了法律工作者的信息检索效率。同时,企业合规系统可借此构建法规知识图谱,以实现监管要求的动态跟踪与风险预警;公共法律服务机器人则基于条文与案例对进行咨询应答,增强了法律服务的可及性。其CC0授权模式免除了商用顾虑,为产业界快速部署法律AI方案提供了便利。
衍生相关工作
这一数据集的发布催生了若干方向性的衍生工作。一方面,它被用作微调中文法律大语言模型的高质量训练集,产生了专注于法条理解与案例推理的专用模型。另一方面,基于其条文与案例的结构化关联,研究者构建了法律引证网络与判决预测模型,探索了法条与案件事实之间的深层语义映射。此外,该数据集的稳定标识模式启发了跨语料库的链接机制设计,促进了不同法律数据源间的互补融合,为构建大规模、多层次的司法智能生态系统奠定了基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

