
遇见数据集

pymupdf-repro-fixtures

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

PyMuPDF Reproduction Fixtures 是一个专为 PyMuPDF 和 PyMuPDF4LLM 库的最小化复现设计的二进制测试夹具数据集。该数据集主要用作存储桶,包含用于不同复现场景的预生成二进制文件,以支持问题排查、功能验证或性能测试。数据集内容分为三个子目录:1) pymupdf-tgif-markdown-repro/,包含4个文件,总计649,854字节;2) pymupdf4llm-rss-repro/,包含13个文件,总计5,376,546字节;3) pymupdf4llm-thread-safety/,包含10个文件,总计896,477字节。这些夹具旨在与GitHub仓库 pymupdf/pymupdf-repros 中的代码和运行说明配合使用,适用于文档处理、LLM集成及线程安全测试等场景。

PyMuPDF Reproduction Fixtures is a binary test fixtures dataset designed for minimal reproductions of the PyMuPDF and PyMuPDF4LLM libraries. The dataset primarily serves as a storage bucket, containing pre-generated binary files for different reproduction scenarios to support issue troubleshooting, feature validation, or performance testing. The dataset content is divided into three subdirectories: 1) pymupdf-tgif-markdown-repro/, containing 4 files with a total of 649,854 bytes; 2) pymupdf4llm-rss-repro/, containing 13 files with a total of 5,376,546 bytes; 3) pymupdf4llm-thread-safety/, containing 10 files with a total of 896,477 bytes. These fixtures are intended to be used with the code and run instructions from the GitHub repository pymupdf/pymupdf-repros, and are applicable to scenarios such as document processing, LLM integration, and thread safety testing.

创建时间:
2026-06-20
搜集汇总
数据集介绍
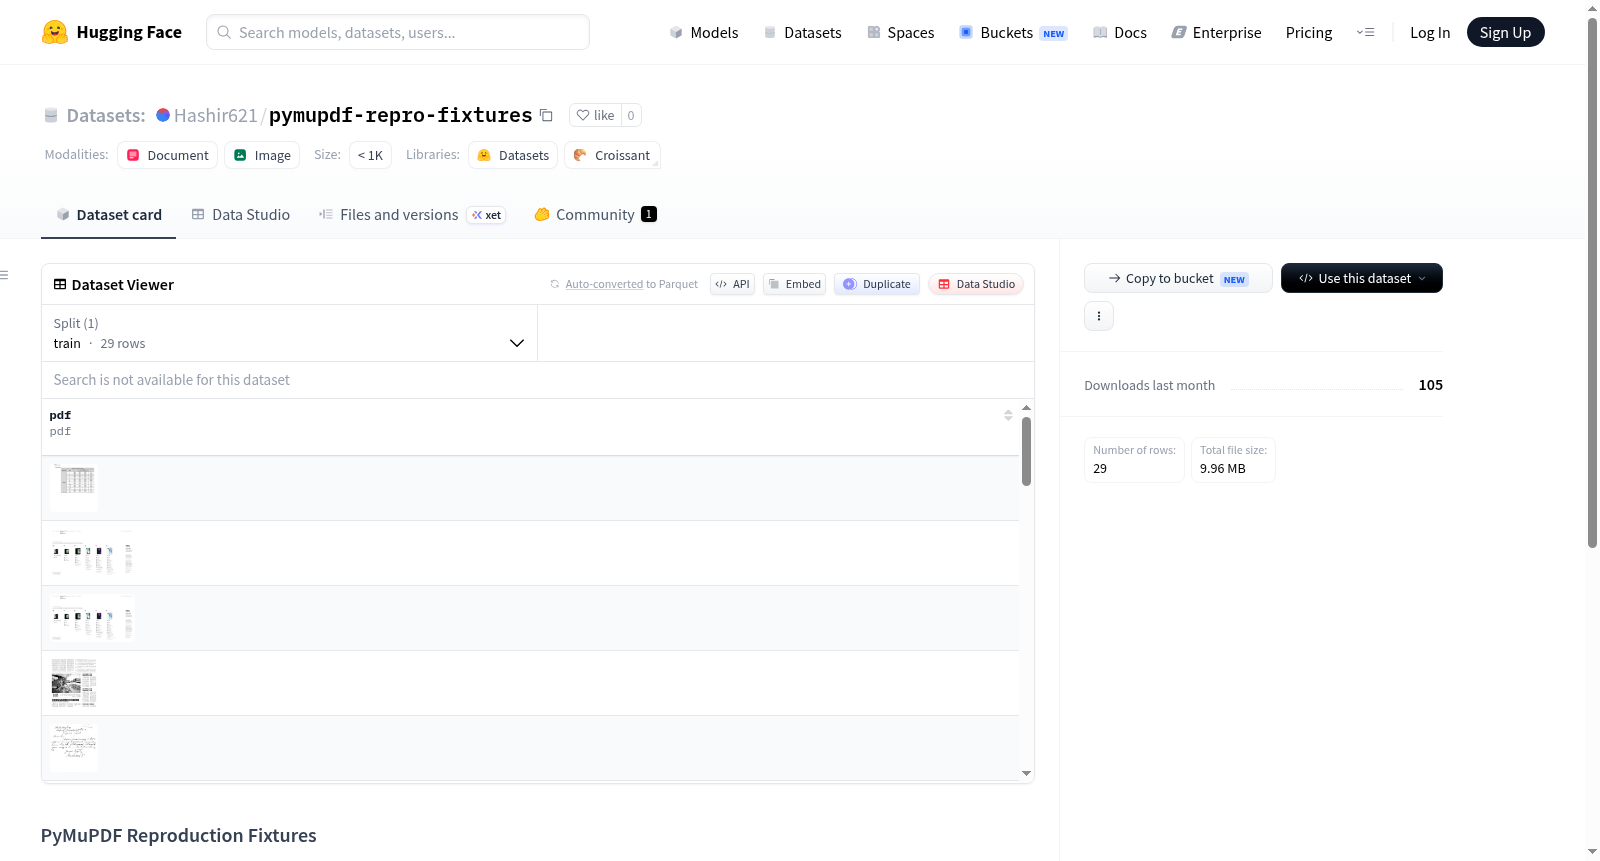
pymupdf-repro-fixtures 数据集图片
构建方式
该数据集作为二进制测试夹具(fixtures)的存储仓库,旨在为PyMuPDF和PyMuPDF4LLM库的最小化复现提供支撑材料。其构建方式并非通过主动采集或标注数据,而是将复现特定问题所需的二进制文件依功能场景分类整理,形成独立的子目录。目前收录了三个复现案例:面向PyMuPDF的TGIF格式转Markdown复现(含4个文件)、PyMuPDF4LLM的RSS订阅解析复现(含13个文件)以及PyMuPDF4LLM的线程安全性复现(含10个文件),文件总规模接近7兆字节。每个子目录内的文件均经过精心裁剪,确保仅包含触发对应行为的最小必要资源。
特点
该数据集最显著的特点在于其极简主义与高度专门化。它并非通用的训练或评估集合,而是为开发者复现和调试特定库行为而生的精准工具集。每个复现场景都被压缩至最低复杂度,文件数量少、体积紧凑,便于快速获取与集成。同时,作为与GitHub仓库`pymupdf/pymupdf-repros`配套的存储层,数据集承担了二进制分发的功能,将大体积或非文本的测试资源与实际代码逻辑解耦,使得复现指导文档保持轻量与可读性。
使用方法
数据集的使用需结合其对应的代码仓库`pymupdf/pymupdf-repros`。用户应首先克隆该GitHub仓库以获取复现代码与执行指令,随后依据具体复现场景,从本数据集的对应子目录中下载所需的二进制文件,并将其放置于代码仓库指定的路径下。完成资源配准后,即可运行仓库中提供的脚本以观察问题行为。因此,本数据集并非直接可调用的库或接口,而是作为离线资源包,为编程环境提供缺失的输入文件,支撑复现流程的完整性。
背景与挑战
背景概述
PyMuPDF Reproduction Fixtures 数据集由 PyMuPDF 团队创建,旨在为 PDF 解析与处理工具提供可复现的测试用例。该数据集收录了针对 PyMuPDF 及其衍生库 PyMuPDF4LLM 的二进制测试文件,涵盖 Markdown 生成、RSS 内容提取及线程安全等核心功能的复现场景。作为 PDF 处理领域的基础设施数据集,它填补了 PDF 解析库在稳定复现与回归测试方面的空白,显著提升了相关工具在复杂格式下的鲁棒性验证效率。
当前挑战
该数据集聚焦于解决 PDF 解析领域面临的复现性挑战,包括不同 PDF 版本和编码方式导致的解析不一致问题,以及多线程环境下内存安全与性能的平衡难题。构建过程中,团队需从海量真实 PDF 中筛选出能触发特定缺陷的最小用例,同时确保二进制文件的完整性且不包含敏感信息。此外,跨平台环境下 PDF 渲染引擎的差异为测试夹具的通用性带来额外困难。
常用场景
经典使用场景
在文档处理与解析的学术研究领域,PyMuPDF作为一款高效的PDF操作库,其稳定性和兼容性至关重要。PyMuPDF Reproduction Fixtures数据集为研究人员提供了精心构造的二进制测试样本,涵盖Markdown转换、RSS内容解析及线程安全等关键场景,能够用于验证PyMuPDF及PyMuPDF4LLM在复杂文档处理中的正确性与鲁棒性。这些固件如同精准的试金石,确保库在迭代升级中始终保持对多样格式的忠实呈现。
衍生相关工作
围绕该数据集,衍生出一系列聚焦文档解析鲁棒性的研究与实践。基于其所暴露的Markdown边界情况,研究者开发了自适应渲染算法以改进文本换行对齐;RSS固件催生了非规范XML解析的容错机制。更值得注意的是,线程安全测试用例启发了轻量级锁优化策略,被整合进主流PDF库的并发处理模块。这些工作不仅反哺了PyMuPDF生态,也为PDF4LLM等模型训练数据预处理工具提供了工程验证范本。
数据集最近研究
最新研究方向
随着文档处理与检索增强生成(RAG)技术的深度融合,PyMuPDF作为高质量PDF解析引擎的重要性日益凸显,尤其是其在多模态文档理解中的性能瓶颈与鲁棒性问题成为前沿焦点。该数据集汇集了针对PyMuPDF及其衍生库PyMuPDF4LLM的复现测试夹具,覆盖了Markdown格式转换、RSS订阅解析以及线程安全等关键场景,为验证大型语言模型在复杂PDF文档上的结构化信息提取能力提供了标准化的测试基准。通过系统性地暴露解析器在边缘案例中的失败模式,该资源推动了文档预处理的可靠性研究,进而影响基于PDF的知识库构建与问答系统的准确性,对提升AI系统在金融、法律、科研等领域的文档处理可信度具有重要支撑作用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

