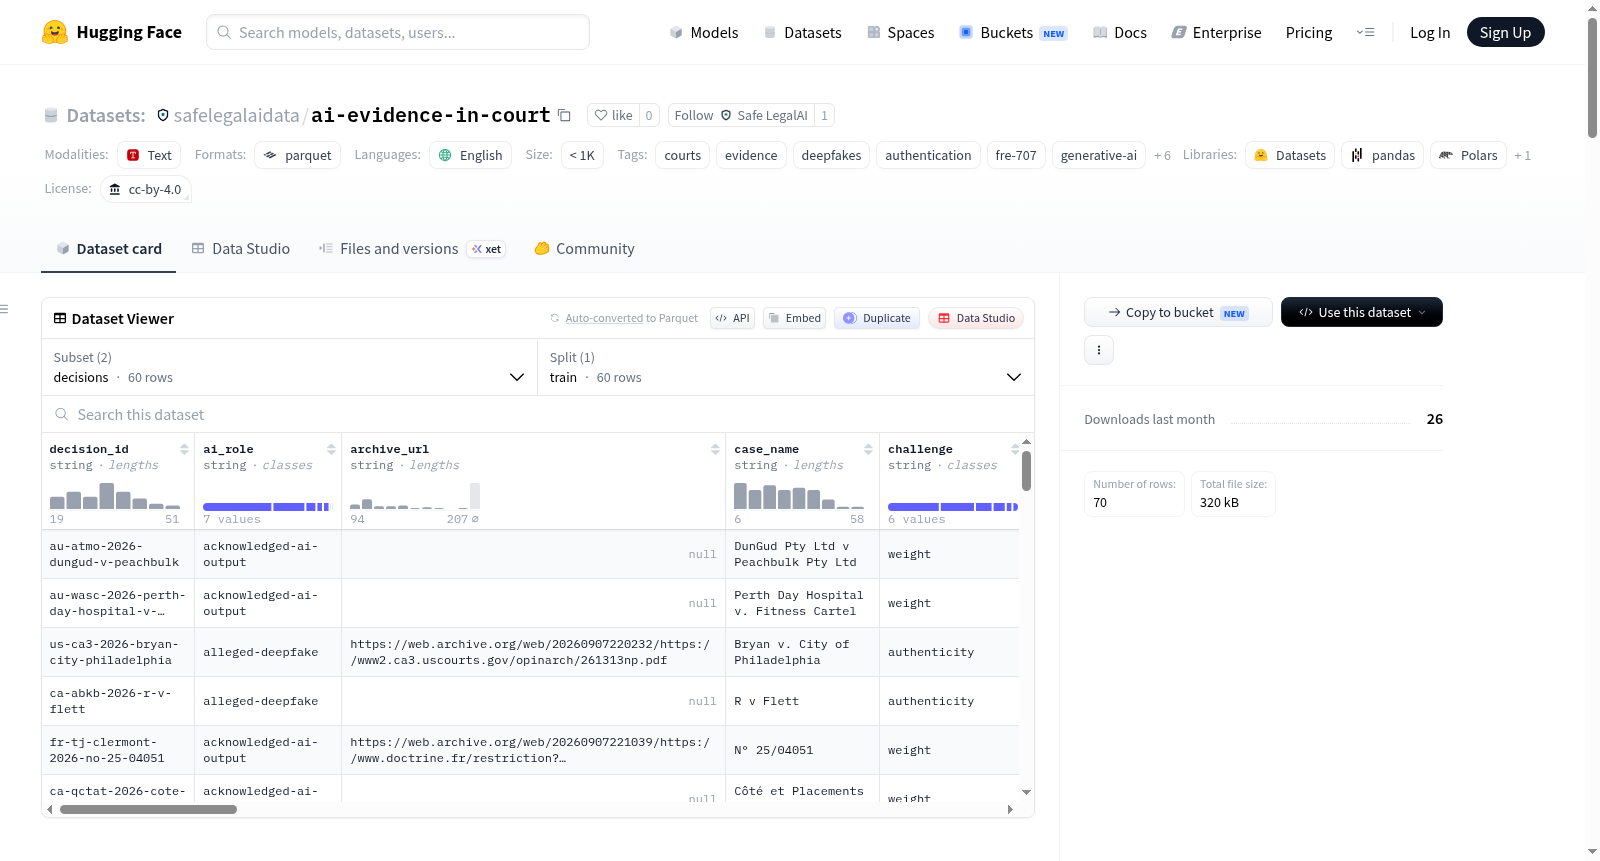
ai-evidence-in-court
收藏资源简介:
该数据集名为“法庭中的AI生成证据与深度伪造”(AI-generated evidence and deepfakes in court),由 SafeLegalAI(Cognesio LLP)于2026年9月8日构建,旨在系统记录全球法院对AI生成、AI篡改或AI“增强”证据以及深度伪造抗辩的裁定,并整理相关的规则、提案与指导文书。数据集包含两个子集:decisions(60条记录,每条代表一个关于AI生成/篡改证据或深度伪造挑战的法院裁定,字段包括证据类型、AI角色、提交方、挑战类型、裁定结果、引用规则、法院裁定引文、摘要等)和instruments(10条记录,每条代表一个关于AI生成证据的规则、提案、法规、法官指引或指导文书,字段包括状态、状态日期、状态引文、下一步事件、操作文本)。覆盖全球多个国家和地区(美国23例、加拿大14例、澳大利亚5例等)。所有记录均包含来源URL、抓取时间及互联网存档URL。数据集适用于按法院、司法管辖区等进行计数比较、构建监控列表、检索或摘要、教学和图书馆指南;不适用于对产品、人员或法院排名、推断流行程度、将编码列视为事实认定。许可:数据集采用CC BY 4.0,代码采用Apache-2.0。
This dataset, named AI-generated evidence and deepfakes in court, was constructed by SafeLegalAI (Cognesio LLP) on September 8, 2026, aiming to systematically record court rulings worldwide on AI-generated, AI-manipulated, or AI-enhanced evidence and deepfake defenses, as well as to organize relevant rules, proposals, and guidance documents. The dataset includes two subsets: decisions (60 records, each representing a court ruling on AI-generated/manipulated evidence or deepfake challenges, with fields such as evidence_type, ai_role, offered_by, challenge, ruling, rules_cited, court_finding_quote, summary, etc.) and instruments (10 records, each representing a rule, proposal, regulation, judicial guidance, or guidance document on AI-generated evidence, with fields including status, status_date, status_quote, next_event, operative_text). It covers multiple countries and regions globally (e.g., US 23, Canada 14, Australia 5, etc.). All records include source URLs, fetched timestamps, and Internet Archive URLs when available. The dataset is suitable for counting and comparing by court, jurisdiction, date, actor, outcome, status; building watchlists and alerts; retrieval or summarization; and teaching and library guides with dates and source lists. It is not suitable for ranking products, individuals, or courts; inferring prevalence beyond court or regulatory statements; or treating coded columns as factual or legal findings. Dataset licensed under CC BY 4.0, code under Apache-2.0.
数据集概述
该数据集由 SafeLegalAI(Cognesio LLP)于 2026-09-08 构建,系统收录了全球范围内关于 AI 生成证据与深度伪造(deepfake)在法庭中应用的司法裁判与规则文本。
数据内容
数据集包含两个核心数据表:
decisions(裁判表):包含 60 条全球法院关于 AI 生成、篡改或“增强”证据,以及深度伪造抗辩或 AI 输出作为证据提交的裁判记录。每条记录对应一个针对 AI 相关证据的裁定。instruments(规则表):包含 10 条关于 AI 生成证据的规则、提案、法规或指导意见,每条记录对应一个规范文本,并标注了其状态(含拟议的《联邦证据规则》第 707 条)。
关键维度与分布
**裁判记录(decisions)**按以下维度分类统计:
- 按国家/地区:美国(23 条)最多,其次为加拿大(14 条)、澳大利亚(5 条),另有荷兰、印度、法国、意大利、以色列、英国等国家。
- 按 AI 角色:已确认的 AI 输出(32 条)占主导,疑似深度伪造(15 条)、AI 生成后提交(5 条)等。
- 按裁判结果:“无证明力”(22 条)和“采纳”(16 条)为主要结果,另有排除、裁定需认证、要求专家意见、制裁等情形。
**规则文本(instruments)**按以下维度分类统计:
- 按状态:生效中(4 条)和已发布(4 条)为主,另有研究中(1 条)和未推进(1 条)。
- 按类型:规则(2 条)、拟议规则(2 条)、法官指引卡(2 条)、指导意见(2 条)、调查(1 条)和法规(1 条)。
- 按国家/地区:美国(7 条)居多,其余分布在加拿大、英国和印度。
数据字段与方法
每条裁判记录均标注证据类型、AI 角色、提出方、异议内容、裁判结果、援引规则、法院认定原文引用(不超过 25 词)、40–60 词摘要,以及敏感性和出版禁令检查标志。每条规则记录包含状态、状态日期、状态引用、后续事件及操作性文本。所有记录均提供来源网址、抓取时间和(如存档)归档链接。构建方法为人工阅读判决原文并编码,来源包括 Damien Charlotin 的数据库(CC BY 4.0)、联邦司法中心调查等,美国判决均取自法院官网或 RECAP 公共档案。
许可与用途
数据集采用 CC BY 4.0 许可,代码采用 Apache-2.0,构建与编码须标注 “SafeLegalAI (safelegalai.com), published by Cognesio LLP”。
该数据集适用于:按法院、司法辖区、日期、主体、结果或状态进行统计比较;基于来源链接构建监测列表和提醒;为检索或摘要提供引用原始文件的基础;以及需要带日期和来源清单的教学与图书馆指南。
不适用于:对产品、个人或法院进行排名;推断超出法院或监管机构自行声明的普遍性;或将编码列视为对事实或法律问题的认定。
引用信息
引用格式:SafeLegalAI (Cognesio LLP), "AI-generated evidence and deepfakes in court", v0.1.3, 2026-09-08. 规范页面:https://safelegalai.com/courts/evidence;镜像页面:https://huggingface.co/datasets/safelegalaidata/ai-evidence-in-court。