
mi-rei/CT_complete
收藏官方服务:
资源简介:
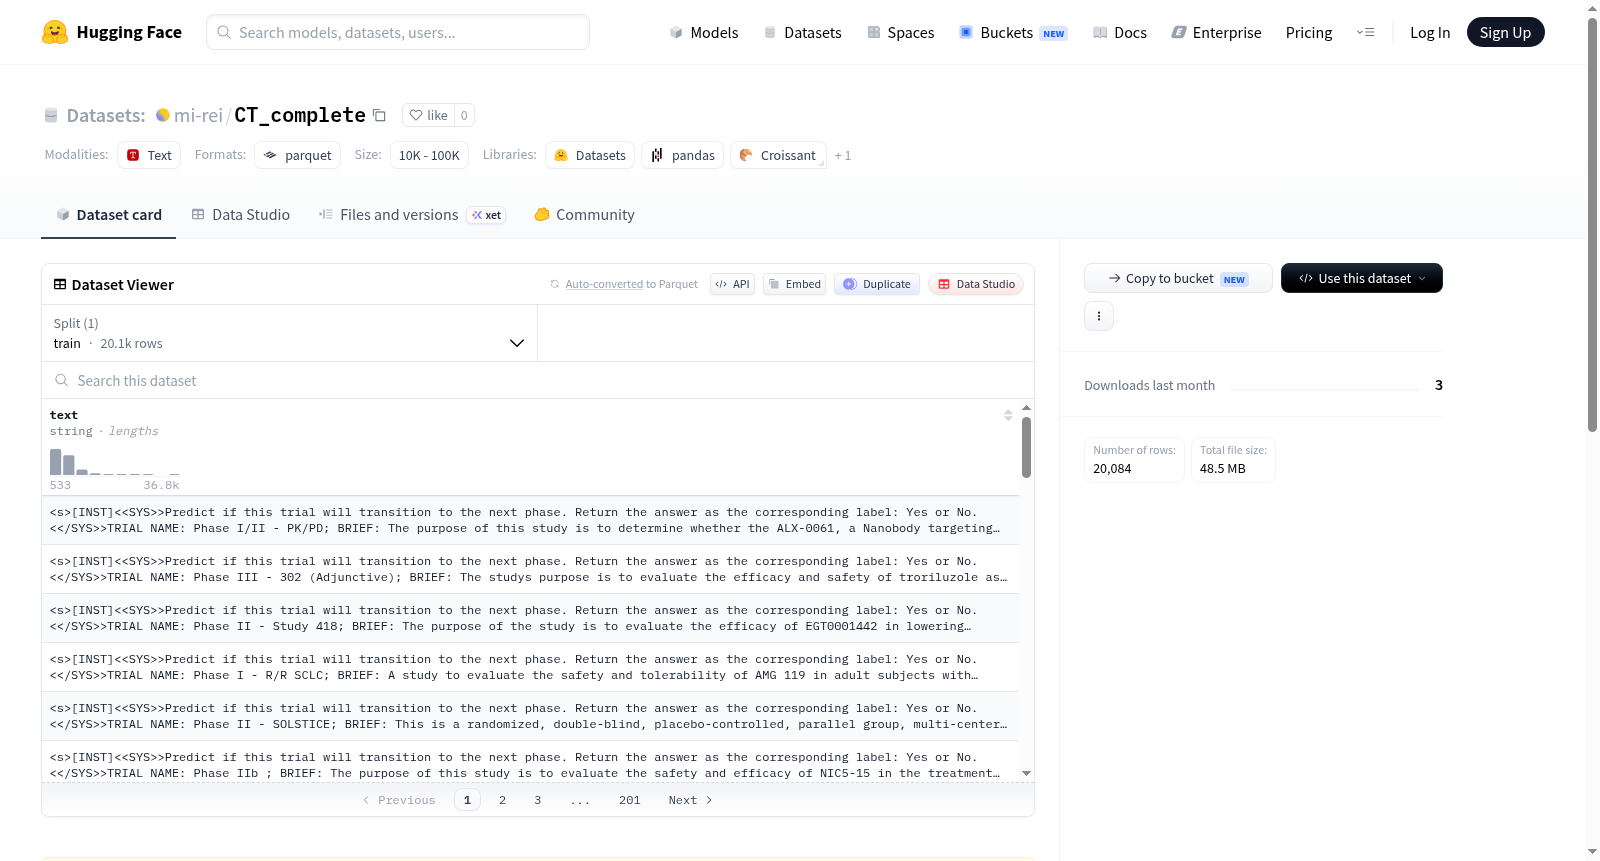
# Contains: - TRIAL NAME - BRIEF - DRUG USED - DRUG CLASS - INDICATION - TARGET - THERAPY - LEAD SPONSOR - CRITERIA - PRIMARY OUTCOME - SECONDARY OUTCOME 1 - SECONDARY OUTCOME 2 - DOSAGE DESCRIPTION - CONTROL DOSAGE DESCRIPTION - TRIAL DESCRIPTION
# 包含以下字段: - 试验名称(TRIAL NAME) - 简要概况(BRIEF) - 受试药物(DRUG USED) - 药物分类(DRUG CLASS) - 适应症(INDICATION) - 作用靶点(TARGET) - 治疗方案(THERAPY) - 牵头申办方(LEAD SPONSOR) - 入排标准(CRITERIA) - 主要终点(PRIMARY OUTCOME) - 次要终点1(SECONDARY OUTCOME 1) - 次要终点2(SECONDARY OUTCOME 2) - 给药方案说明(DOSAGE DESCRIPTION) - 对照给药方案说明(CONTROL DOSAGE DESCRIPTION) - 试验概况说明(TRIAL DESCRIPTION)
提供机构:
mi-rei原始信息汇总
数据集内容概述
数据集包含以下字段:
- TRIAL NAME: 试验名称
- BRIEF: 简述
- DRUG USED: 使用的药物
- DRUG CLASS: 药物类别
- INDICATION: 适应症
- TARGET: 目标
- THERAPY: 治疗
- LEAD SPONSOR: 主要赞助商
- CRITERIA: 标准
- PRIMARY OUTCOME: 主要结果
- SECONDARY OUTCOME 1: 次要结果1
- SECONDARY OUTCOME 2: 次要结果2
- DOSAGE DESCRIPTION: 剂量描述
- CONTROL DOSAGE DESCRIPTION: 对照剂量描述
- TRIAL DESCRIPTION: 试验描述
搜集汇总
数据集介绍
构建方式
在临床试验领域,结构化数据的稀缺性制约了自动化分析与知识挖掘。本数据集基于公开临床试验信息,系统性地提取并整合了涵盖试验名称、简要描述、用药方案、药物分类、适应症、作用靶点、治疗方式、主要赞助方、入选标准、主要终点、次要终点、剂量描述、对照剂量描述以及试验详细描述等关键字段。通过统一的数据清洗与规范化流程,将分散的文本信息转化为结构化表格,构建了一个多维度、高覆盖的临床试验知识库。
使用方法
研究人员可直接利用该数据集进行临床试验的统计分析,例如探究不同药物类别与适应症的关联模式。通过加载结构化字段,可便捷地筛选特定治疗领域的试验,或对入选标准、终点设置进行文本挖掘与分类。此外,剂量描述与对照信息可用于构建药物剂量-反应模型。数据以通用表格格式存储,兼容Python的pandas、R等主流数据科学工具,便于集成到自动化分析流程中。
背景与挑战
背景概述
在临床试验设计与药物开发领域,结构化数据集的构建对于提升研究效率与可重复性至关重要。mi-rei/CT_complete数据集由研究人员于近期创建,旨在系统整合临床试验的核心信息要素,涵盖试验名称、药物类别、适应症、靶点、治疗方案及主要赞助方等关键字段。该数据集聚焦于解决临床试验信息碎片化与标准化不足的问题,通过提供统一格式的试验描述、入选标准及结局指标,为药物研发人员、临床研究者及监管机构提供了高效的信息检索与分析平台。其影响力体现在促进跨试验比较、辅助新药靶点验证以及加速临床试验方案的优化设计,成为转化医学与精准医疗领域的重要数据资源。
当前挑战
CT_complete数据集面临的核心挑战在于多源异构数据的整合与质量控制。临床试验数据通常分散于不同数据库与文献中,格式差异显著,导致字段映射与语义对齐困难,尤其是治疗描述与剂量信息的标准化处理。构建过程中,研究者需克服术语不一致(如药物分类与靶点命名)、缺失值处理及历史试验数据回溯等障碍。此外,数据集的时效性维护亦构成挑战,需持续追踪新试验结果并更新结局指标。从领域问题看,该数据集旨在解决的临床试验信息检索与分析难题,仍需应对动态变化的监管要求与个性化治疗趋势带来的数据复杂性,确保其作为参考工具的可靠性与全面性。
常用场景
经典使用场景
在临床医学研究的浩瀚星空中,临床试验数据是推动循证医学发展的基石。CT_complete数据集以其结构化的信息框架,为研究者提供了一个标准化的临床试验信息聚合平台。该数据集最经典的使用场景在于构建临床试验智能检索与匹配系统,通过整合试验名称、药物信息、适应证及纳入标准等关键字段,使研究人员能够快速定位与特定疾病或治疗策略相关的临床试验,从而大幅提升文献综述与荟萃分析的效率。
解决学术问题
该数据集有效解决了临床试验信息碎片化与异构性带来的学术研究瓶颈。传统上,研究者需从多个分散的数据库中手动提取试验细节,耗时且易遗漏。CT_complete通过统一字段规范,如主要结局指标与次要结局指标的明确标注,使得大规模试验比较与结果异质性分析成为可能。其意义在于为药物疗效评估、治疗方案优化及证据等级划分提供了结构化数据支持,推动了临床研究从经验驱动向数据驱动的转型。
实际应用
在实际应用中,CT_complete数据集助力医药企业、监管机构与学术组织实现精准决策。例如,制药公司可基于该数据集的药物类别与剂量描述,分析同类竞品的临床试验设计趋势,从而优化自身新药研发方案。监管审查时,审评员能通过结构化信息快速核对试验方案与结果的一致性,加速审批流程。此外,该数据集还可用于开发临床决策支持系统,辅助医生根据患者特征匹配最适宜的临床试验入组机会。
数据集最近研究
最新研究方向
在临床试验数据标准化与结构化领域,mi-rei/CT_complete数据集的出现为药物研发与医学研究提供了关键支撑。该数据集整合了临床试验的核心要素,涵盖试验名称、用药方案、适应症、靶点及疗效终点等结构化信息,尤其在前沿研究方向中,其被广泛用于构建自动化临床试验匹配系统与智能药物重定位模型。结合当前精准医学与人工智能辅助临床试验设计的热点趋势,该数据集通过规范化治疗描述与纳入排除标准,显著提升了跨试验数据的可复用性,为真实世界证据生成与监管科学评估奠定了数据基础,推动了个性化治疗方案的循证决策进程。
以上内容由遇见数据集搜集并总结生成


