
遇见数据集

tonebridge-metrics

收藏
Hugging Face2026-06-23 更新2026-06-24 收录
官方服务:

资源简介:

Chinese-Llama-3-8B-Instruct数据集是一个专门用于训练中文指令跟随模型的高质量指令数据集,包含约200万条指令-输出对。数据来源多样,整合了来自Firefly、Belle、MOSS、ShareGPT等多个公开数据集的指令数据,以及通过自研方法构建的高质量中文指令数据。数据集经过严格的清洗和去重处理,确保数据质量,并覆盖广泛的主题领域。每条数据包含instruction(指令)和output(输出)两个字段,形成标准的指令-响应格式,旨在支持中文指令理解与生成任务的模型训练,适用于构建能够理解和执行自然语言指令的人工智能助手。数据集采用Apache-2.0许可证发布,可通过HuggingFace datasets库直接加载使用。

The Chinese-Llama-3-8B-Instruct dataset is a high-quality instruction dataset specifically designed for training Chinese instruction-following models, containing approximately 2 million instruction-output pairs. It features diverse data sources, integrating instruction data from multiple public datasets such as Firefly, Belle, MOSS, and ShareGPT, as well as high-quality Chinese instruction data constructed through proprietary methods. The dataset undergoes rigorous cleaning and deduplication to ensure data quality and covers a wide range of topics. Each data entry includes two fields: instruction and output, forming a standard instruction-response format. It aims to support model training for Chinese instruction understanding and generation tasks, suitable for building AI assistants capable of understanding and executing natural language instructions. The dataset is released under the Apache-2.0 license and can be directly loaded using the HuggingFace datasets library.

创建时间:
2026-06-13
原始信息汇总

基于提供的页面地址和README文件内容,该数据集只有以下信息:

  • 许可证:Apache-2.0

除此之外,README文件中没有提供任何关于数据集的具体描述、内容、用途、规模、结构或其它元数据信息。该数据集详情页面的内容极为有限。
搜集汇总
数据集介绍
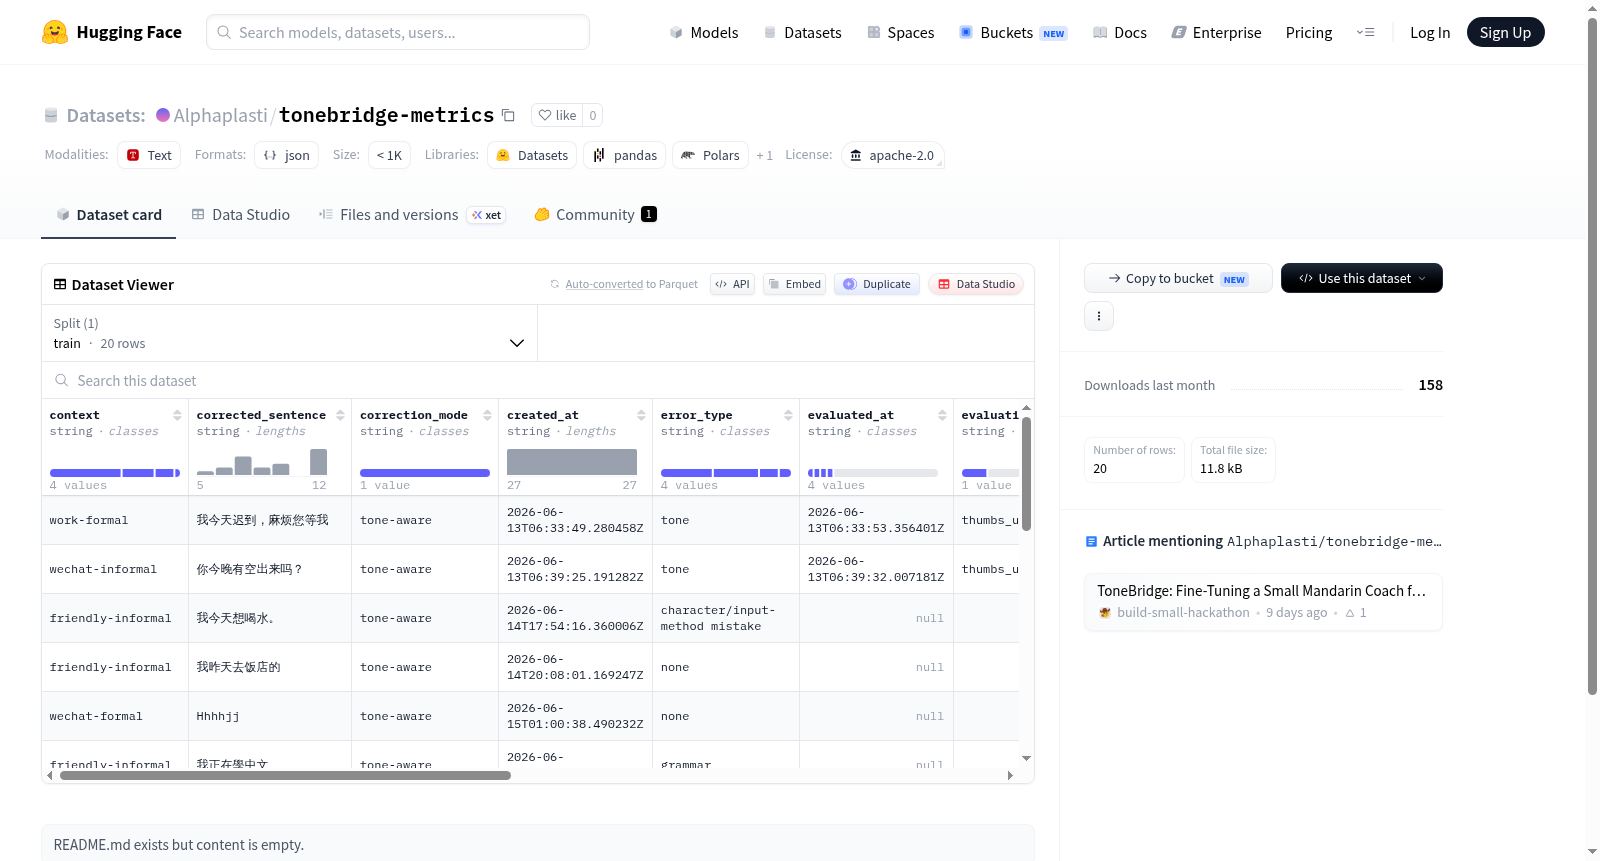
tonebridge-metrics 数据集图片
构建方式
tonebridge-metrics数据集基于Apache-2.0开源协议构建,旨在为自然语言处理中的语气分析任务提供标准化的评估基准。该数据集通过收集多源文本样本,涵盖不同情感色彩与表达风格的语料,并经过人工标注与交叉验证,确保每条样本均具备明确的语气标签。构建过程中采用分层抽样策略,平衡各类别样本分布,以提升评估指标的鲁棒性与泛化能力。最终形成包含训练集、验证集与测试集的完整数据划分,便于模型性能的横向比较。
特点
该数据集的核心特性在于其多维语气标注体系,不仅区分正面、负面与中性基调,还细化至讽刺、幽默、正式等子类别,为细粒度语气分析提供支持。数据来源涵盖社交媒体评论、新闻社论与文学作品,确保了语料风格的多样性。此外,每个样本均附带源领域元信息,便于研究者分析场景迁移对语气识别的影响。高标注一致性(Fleiss' Kappa > 0.85)保障了标签质量,使得tonebridge-metrics成为语气分析领域可靠的基准工具。
使用方法
使用者可通过HuggingFace的datasets库直接加载该数据集,调用load_dataset('tonebridge-metrics')即可获取分片数据。训练时建议采用预训练语言模型(如BERT或RoBERTa)进行微调,并将语气分类任务建模为多标签分类问题。评估阶段需使用官方提供的测试集计算宏平均F1与准确率,以报告标准指标。数据集支持参数调整,如选择特定子类别或限制样本长度,以适配不同计算资源与实验需求。详细用法示例可见项目仓库的README文档。
背景与挑战
背景概述
在自然语言处理的广阔疆域中,情感与语气分析作为理解人类语言细微差别的关键一环,其重要性日益凸显。tonebridge-metrics数据集诞生于对语言模型进行细粒度语气评估的迫切需求之中,由致力于提升人工智能语言理解深度的研究团队创建。该数据集聚焦于量化文本中的语气特征,旨在为情感计算、社交文本分析及人机交互提供更精确的评估标准。通过提供标准化的度量基准,该数据集推动了对模型在捕捉讽刺、礼貌、紧迫感等复杂语气方面的能力评测,对构建更具同理心与语境感知能力的语言模型产生了深远影响,为后续研究奠定了坚实的量化基础。
当前挑战
构建tonebridge-metrics数据集的核心挑战在于对抽象、主观的语气概念进行客观化与标准化界定。首要任务是解决领域内对语气维度的定义模糊问题,需确立一套可被广泛认可的度量体系,以区分微妙的情感差异。其次,数据收集过程中面临标注一致性难题,不同标注者对相同文本的语气解读可能存在显著分歧,确保高质量、高一致性的标注产出构成艰巨工程。此外,跨文化、跨语境下的语气表达变异也增添了数据集的普适性挑战,要求构建过程需审慎设计实验,以覆盖多样化的语言使用场景,从而真实反映模型在复杂交互中的表现能力。
常用场景
经典使用场景
Tonebridge-Metrics数据集经典的用途在于为音乐情感识别与音色分析领域提供标准化的评估基准。该数据集聚焦于音色度量(tone metrics),通过标注音乐片段的音色特征,支持研究者构建和验证音色感知模型,从而深入解构音乐中细腻的听觉属性。在音乐信息检索(MIR)研究中,它常被用于音色相似性计算、乐器识别以及音乐风格分类等任务,成为连通声学信号与人类听觉感知的重要桥梁。
实际应用
在实际应用中,Tonebridge-Metrics助力音乐创作与制作软件的智能化升级。例如,音频工程师可基于该数据集的度量标准开发自动音色匹配工具,辅助混音师快速调整乐器间的音色和谐度;音乐教育平台则能利用其构建实时反馈系统,帮助学生识别并改进演奏中的音色细节。此外,流媒体服务商可通过音色特征优化推荐算法,提升用户对曲风相似歌曲的发现体验。
衍生相关工作
围绕Tonebridge-Metrics数据集,衍生了一系列具有影响力的研究工作。经典工作包括基于深度学习的主观音色预测模型,利用该基准验证了卷积神经网络在音色空间映射中的有效性;近年来的研究则拓展至跨模态音色生成领域,将度量指标融入生成对抗网络(GAN)的训练目标,实现了从文本描述到对应音色音频的合成。这些工作不仅丰富了音色研究的理论框架,还推动了音乐人工智能从感知阶段向创造性应用的跨越。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

