遇见数据集

polinaeterna/test_meta_dump

收藏
Hugging Face2023-01-27 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: - config_name: single features: - name: x dtype: int64 - name: y dtype: string splits: - name: train num_bytes: 360 num_examples: 20 download_size: 0 dataset_size: 360 - config_name: v1 features: - name: x dtype: int64 - name: y dtype: string splits: - name: train num_bytes: 93 num_examples: 6 - name: test num_bytes: 28 num_examples: 2 download_size: 0 dataset_size: 121 - config_name: v2 features: - name: x dtype: int64 - name: y dtype: string splits: - name: train num_bytes: 56 num_examples: 4 - name: test num_bytes: 14 num_examples: 1 download_size: 1673 dataset_size: 70 configs_kwargs: - config_name: single data_dir: single - config_name: v1 data_dir: v1 - config_name: v2 data_dir: v2 --- # Dataset Card for "test_meta_dump" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

数据集信息: - 配置名称:single 特征: - 名称:x 数据类型:64位整型(int64) - 名称:y 数据类型:字符串(string) 拆分集: - 名称:训练集(train) 字节数:360 样本数:20 下载大小:0 数据集总大小:360 - 配置名称:v1 特征: - 名称:x 数据类型:64位整型(int64) - 名称:y 数据类型:字符串(string) 拆分集: - 名称:训练集(train) 字节数:93 样本数:6 - 名称:测试集(test) 字节数:28 样本数:2 下载大小:0 数据集总大小:121 - 配置名称:v2 特征: - 名称:x 数据类型:64位整型(int64) - 名称:y 数据类型:字符串(string) 拆分集: - 名称:训练集(train) 字节数:56 样本数:4 - 名称:测试集(test) 字节数:14 样本数:1 下载大小:1673 数据集总大小:70 配置关键字参数: - 配置名称:single 数据目录:single - 配置名称:v1 数据目录:v1 - 配置名称:v2 数据目录:v2 # "test_meta_dump"数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
polinaeterna
原始信息汇总

数据集概述

配置信息

  • 配置名称: single

    • 特征:
      • 名称: x
        • 数据类型: int64
      • 名称: y
        • 数据类型: string
    • 分割:
      • 名称: train
        • 字节数: 360
        • 样本数: 20
    • 下载大小: 0
    • 数据集大小: 360
  • 配置名称: v1

    • 特征:
      • 名称: x
        • 数据类型: int64
      • 名称: y
        • 数据类型: string
    • 分割:
      • 名称: train
        • 字节数: 93
        • 样本数: 6
      • 名称: test
        • 字节数: 28
        • 样本数: 2
    • 下载大小: 0
    • 数据集大小: 121
  • 配置名称: v2

    • 特征:
      • 名称: x
        • 数据类型: int64
      • 名称: y
        • 数据类型: string
    • 分割:
      • 名称: train
        • 字节数: 56
        • 样本数: 4
      • 名称: test
        • 字节数: 14
        • 样本数: 1
    • 下载大小: 1673
    • 数据集大小: 70
搜集汇总
数据集介绍
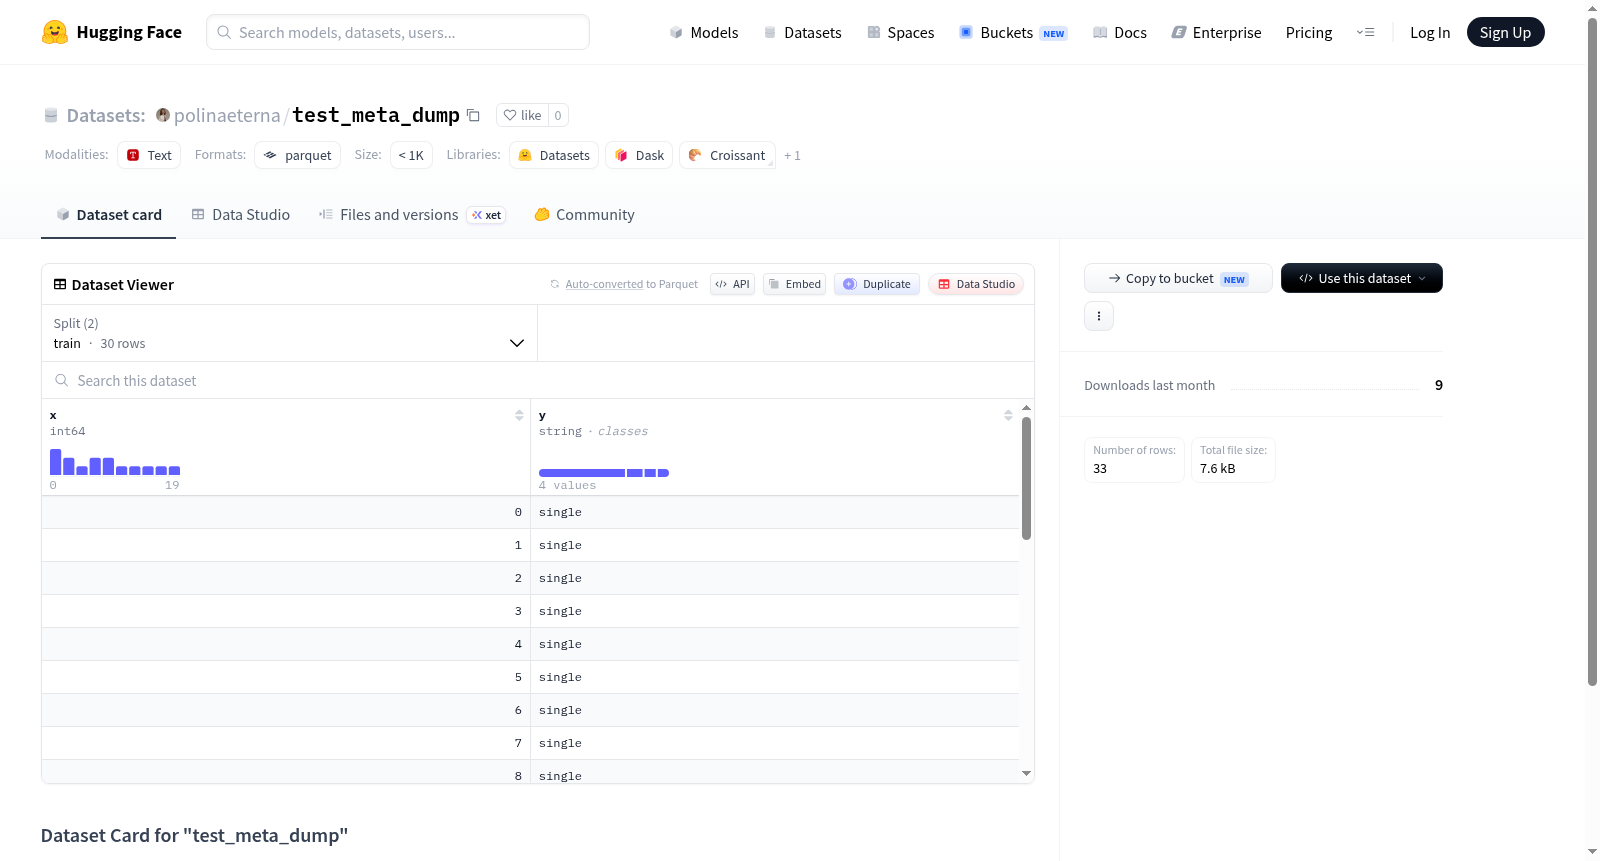
polinaeterna/test_meta_dump 数据集图片
构建方式
在自然语言处理与机器学习领域,数据集的结构化设计是模型训练与评估的基石。polinaeterna/test_meta_dump数据集以多配置形式构建,涵盖single、v1和v2三个独立子集,每个配置均包含整数类型特征x与字符串类型特征y。数据划分方面,single配置仅提供训练集,包含20个样本;v1配置则分为训练集(6个样本)与测试集(2个样本);v2配置同样设有训练集(4个样本)与测试集(1个样本)。各配置通过data_dir参数指定独立的数据目录,以支持灵活的数据加载与实验管理。
特点
该数据集的核心特点在于其多版本化与轻量级设计。不同配置下的样本规模从1至20不等,总数据量极小(最大仅360字节),适用于快速原型验证与教学演示。特征结构简洁统一,仅包含数值与文本两种基础类型,降低了预处理复杂度。值得注意的是,v2配置拥有独立的下载大小(1673字节),暗示其可能包含额外的元数据或外部引用,而其他配置则无下载需求,体现了数据集构建的多样性。这种分层配置策略为研究者提供了对比实验的天然框架。
使用方法
在使用该数据集时,可通过HuggingFace datasets库按配置名称加载特定版本,例如调用load_dataset('polinaeterna/test_meta_dump', 'v1')以获取v1配置的训练与测试划分。对于single配置,可直接加载训练集并用于简单的回归或分类任务模拟。鉴于数据集规模极小,建议将其作为单元测试、基线模型调试或数据管道验证的辅助资源。用户亦可结合datasets库的split参数灵活选择数据子集,或通过to_iterable_dataset方法实现流式处理以适配内存敏感场景。
背景与挑战
背景概述
在自然语言处理与结构化数据融合的研究领域,数据集的设计与构建是推动模型泛化能力提升的关键基石。polinaeterna/test_meta_dump数据集由HuggingFace社区的研究人员创建,旨在为元数据管理与多配置数据集成提供测试基准。该数据集包含三个配置(single、v1、v2),每个配置均以整数x与字符串y为特征,并划分为训练集与测试集,其中v2配置引入了额外的下载资源以模拟真实场景中的多源数据整合。尽管其规模较小(总计约551字节),但其设计初衷在于验证数据加载框架对异构配置的兼容性,并为后续大规模元数据系统的开发提供参考范例。该数据集的影响力主要体现在技术验证层面,为数据集的标准化描述与自动化处理流程提供了轻量级测试平台。
当前挑战
该数据集面临的挑战首先体现在领域问题的复杂性上:如何通过有限样本(如v2配置仅含4个训练样本)有效模拟真实世界中的元数据异构性,并避免过拟合于特定配置模式。其次,构建过程中需解决多配置数据的一致性与可扩展性难题,例如single配置与v1、v2之间的特征对齐需严格定义,而v2中1673字节的下载资源与仅70字节的数据集大小的矛盾,揭示了存储效率与元数据完整性的权衡困境。此外,缺乏详细的标注文档与领域背景,使得该数据集在迁移至新任务时可能遭遇解释性瓶颈,限制了其作为通用基准的潜力。
常用场景
经典使用场景
该数据集设计为多配置格式,涵盖单配置(single)及版本化配置(v1与v2),内含整数型特征x与字符串型特征y。在经典使用场景中,它常用于验证和测试数据集加载框架的鲁棒性与兼容性,例如检测不同配置下数据分片(train/test)的读取一致性。由于其规模极小(总计仅33条样本),它亦作为原型开发的快速调试工具,帮助研究人员在构建复杂流水线前验证数据预处理逻辑的正确性。
实际应用
实际应用中,该数据集常被用于自动化测试套件的一部分,确保数据加载库在迭代更新后仍能正确处理不同配置的数据集。它也可作为教学示例,帮助初学者理解数据集的多配置结构和分片机制。此外,在持续集成(CI)流程中,它被用来快速验证数据管道是否因代码变更而出现回归错误,从而保障数据科学项目的开发效率。
衍生相关工作
该数据集衍生了若干相关工作,包括对HuggingFace Datasets库中配置化数据加载功能的测试用例扩展,以及针对小样本数据集加载性能的优化研究。此外,基于其多配置特性,后续工作探索了数据集版本控制的最佳实践,并催生了用于自动生成数据集卡片模板的工具。这些工作共同推动了数据集工程化标准的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务