
colesimmons/SumTablets
收藏官方服务:
资源简介:
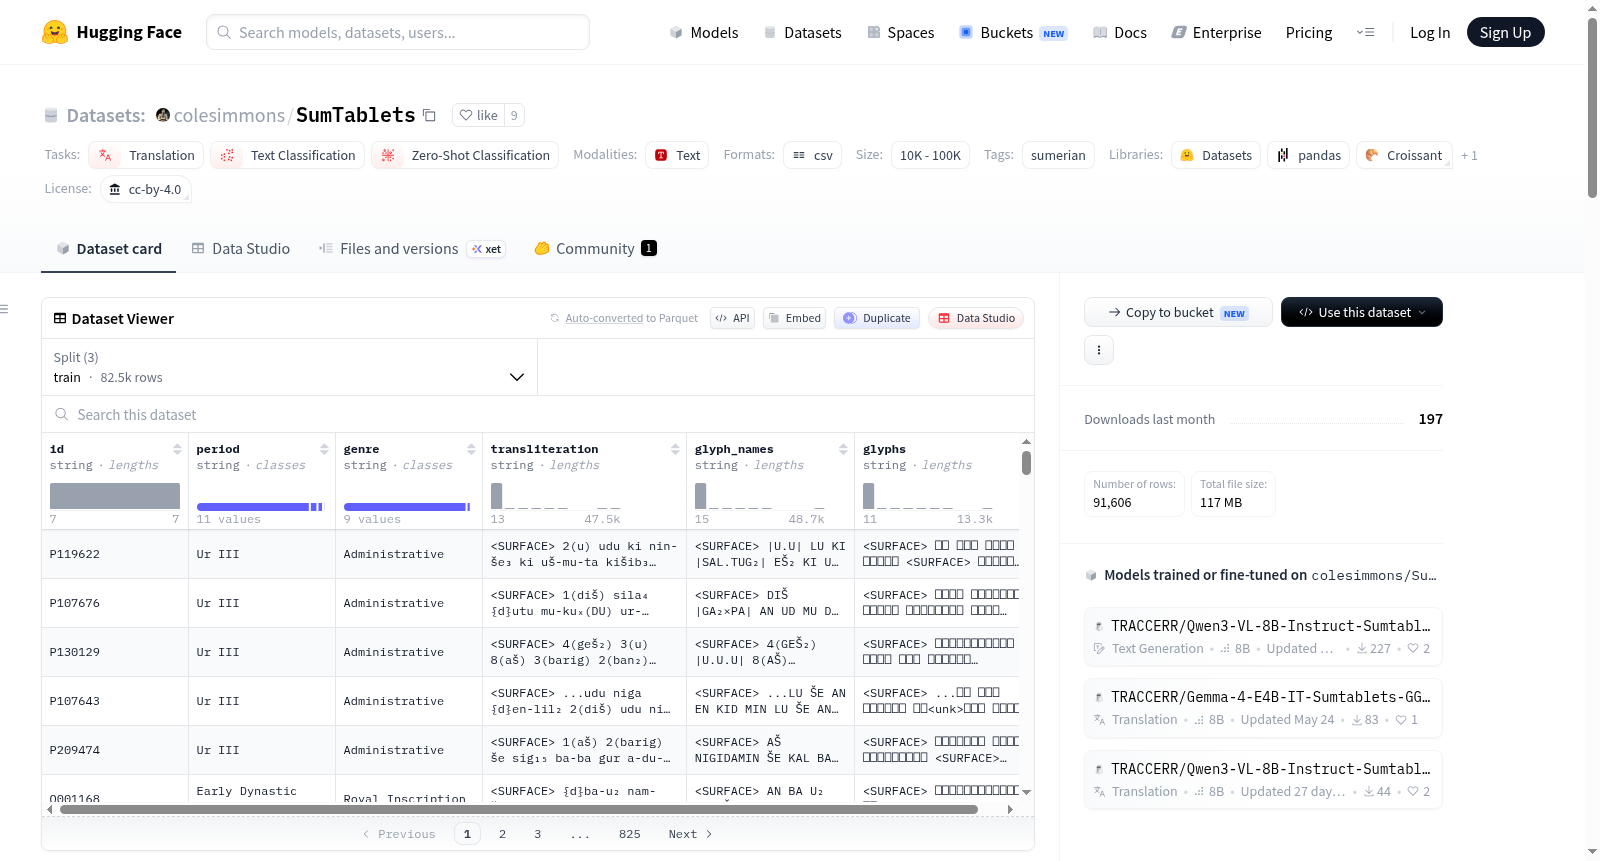
SumTablets数据集包含91,606个苏美尔楔形文字板的字形-转写对。数据集按时期和类型进行了分类,并提供了训练集、验证集和测试集的数量分布。数据集的任务类别包括翻译、文本分类和零样本分类,标签涉及苏美尔文化。
SumTablets is a dataset of 91,606 Sumerian cuneiform tablets, structured as glyph--transliteration pairs. The dataset is categorized by period and genre, with distributions provided for training, validation, and test sets. The task categories include translation, text-classification, and zero-shot classification, with tags related to Sumerian culture.
提供机构:
colesimmons原始信息汇总
SumTablets
SumTablets是一个包含91,606块苏美尔楔形文字泥板的语料库,结构为字形-音译对。
组成(时期)
| 时期 | 训练集 | 验证集 | 测试集 |
|---|---|---|---|
| Ur III | 71,116 | 3,951 | 3,951 |
| 古阿卡德 | 4,766 | 265 | 265 |
| 早王朝IIIb | 3,467 | 192 | 192 |
| 古巴比伦 | 1,374 | 73 | 73 |
| 拉加什II | 788 | 44 | 44 |
| 早王朝IIIa | 755 | 42 | 42 |
| 早王朝I-II | 77 | 4 | 4 |
| 未知 | 68 | 4 | 4 |
| 新亚述 | 20 | 1 | 1 |
| 新巴比伦 | 14 | 1 | 1 |
| 中巴比伦 | 7 | 0 | 0 |
| 总计 | 82,452 | 4,577 | 4,577 |
组成(体裁)
| 体裁 | 训练集 | 验证集 | 测试集 |
|---|---|---|---|
| 行政 | 77,193 | 4,259 | 4,291 |
| 皇家铭文 | 2,611 | 151 | 146 |
| 文学 | 1,000 | 63 | 62 |
| 信件 | 718 | 48 | 33 |
| 法律 | 544 | 35 | 36 |
| 未知 | 269 | 14 | 7 |
| 词典 | 69 | 0 | 0 |
| 礼仪 | 40 | 4 | 1 |
| 数学/科学 | 8 | 3 | 1 |
| 总计 | 82,452 | 4,577 | 4,577 |
搜集汇总
数据集介绍
构建方式
SumTablets数据集汇集了91,606对苏美尔楔形文字符号与转写文本的平行语料,其构建基于对现有数字人文项目中高度注释数据的系统性清理与结构化重组。研究团队从电子宾夕法尼亚苏美尔词典(ePSD2)等来源提取原始转写,剥离用于符号检索与分析的繁复标注,仅保留反映泥板实际内容的纯净转写。随后,借助词典将每个解读映射回对应的Unicode楔形文字符号,最终形成适用于序列到序列建模的平行示例集。数据按历史时期与文体类型划分训练、验证和测试集,其中乌尔第三王朝时期的行政文献占据主体。
特点
该数据集的核心特色在于其专为现代语言模型应用而设计的结构化转写范式。通过去除传统亚述学研究中用于检索与分析的复杂标注,数据集提供了仅反映泥板原始内容的纯净转写,极大降低了模型训练的数据噪声。同时,将转写文本与Unicode楔形文字符号精确对齐,构建了天然适合序列到序列学习的平行语料。数据集在Hugging Face平台发布,并采用版本控制机制,确保数据源与预处理步骤变更时的可追溯性与实验可复现性,为跨学科研究提供了便捷的接入点。
使用方法
SumTablets专为序列到序列的转写任务设计,可直接用于训练编码器-解码器架构的神经语言模型。用户可通过Hugging Face Datasets库加载预划分的训练、验证和测试集,以楔形文字符号为输入、拉丁字母转写为目标输出进行模型训练。数据集覆盖多个历史时期与文体类型,支持零样本分类与文本分类等迁移学习任务。预处理脚本在GitHub开源发布,便于研究者复现数据构建流程或根据特定需求调整预处理策略,进一步扩展数据集的应用场景。
背景与挑战
背景概述
苏美尔楔形文字作为人类最早的文字系统之一,承载着美索不达米亚文明数千年的历史记忆,其释读工作一直是亚述学研究的核心挑战。2024年,由Cole Simmons、Richard Diehl Martinez及Dan Jurafsky教授组成的跨学科团队发布了SumTablets数据集,旨在通过现代自然语言处理技术推动苏美尔楔形文字转写的自动化进程。该数据集整合了来自电子宾夕法尼亚苏美尔词典(ePSD2)等项目的逾九万条楔形文字-转写平行语料,覆盖从早王朝时期到新巴比伦时期的多个历史阶段,为序列到序列的转写任务提供了结构化、可复现的研究基础。这一工作不仅延续了亚述学界自1996年ETCSL项目以来的开放协作传统,更在ACL 2024首届机器学习与古代语言研讨会上首次亮相,标志着计算语言学与古代文字研究的深度融合。
当前挑战
SumTablets数据集所面临的挑战体现在两个维度。在领域问题层面,苏美尔楔形文字转写本质上是一个低资源、高歧义的序列转换任务:同一楔形符号在不同语境下可能对应多种读音,而现存语料存在严重的时间分布不均——乌尔第三王朝文献占比超过86%,导致模型在罕见时期的泛化能力受限。在数据构建过程中,团队需要从Oracc等项目中提取高度符号化的转写文本,并剥离为适应语言模型而优化的注释信息,这一过程需平衡原始数据的学术严谨性与机器学习任务的简洁性。此外,数据集版本管理需应对上游语料库持续更新的挑战,确保实验可复现性的同时,为后续研究者提供清晰的演化轨迹。
常用场景
经典使用场景
SumTablets数据集以苏美尔楔形文字泥板的转写为核心任务,将91,606条泥板记录构建为字形-转写平行语料对。该数据集剥离了传统转写中繁复的符号标注,专注于呈现泥板表面原始内容,为序列到序列的神经机器翻译模型提供了标准化的训练基准。研究者可借此探索低资源古代语言在编码器-解码器架构下的转写生成能力,尤其适用于评估Transformer模型在楔形文字与拉丁字母间跨模态映射的表现。
衍生相关工作
该数据集衍生了一系列开创性工作,包括基于预训练语言模型的苏美尔语转写微调框架、融合楔形文字图像与转写序列的多模态翻译系统,以及面向古代语言的低资源数据增强方法。ML4AL Workshop中基于SumTablets的基线模型验证了字符级注意力机制在楔形文字转写中的有效性,后续研究进一步将其扩展至阿卡德语、赫梯语等关联语种,推动了古代近东语言处理工具链的标准化进程。
数据集最近研究
最新研究方向
SumTablets数据集聚焦于苏美尔楔形文字泥板的转写任务,通过构建结构化的字形-转写对,推动古代文字数字化与自然语言处理的交叉研究。当前前沿方向包括利用序列到序列模型进行自动转写,结合多模态学习(如字形图像与文本对齐)提升解读准确性,以及探索零样本分类在未标注泥板上的应用。该数据集与数字人文领域的热点事件紧密相关,例如CDLI和Oracc等项目的开放数据运动,为AI驱动的文化遗产保护提供了关键资源。其影响在于降低了计算语言学门槛,促进跨学科合作,并为理解苏美尔文明的经济、法律与文学体系开辟了新路径,尤其在行政文献占主导的背景下,有助于量化分析古代社会运作模式。
以上内容由遇见数据集搜集并总结生成


