
遇见数据集

tahoebio/replogle-nadig-de-rhaister

收藏
Hugging Face2026-06-02 更新2026-06-14 收录
官方服务:

资源简介:

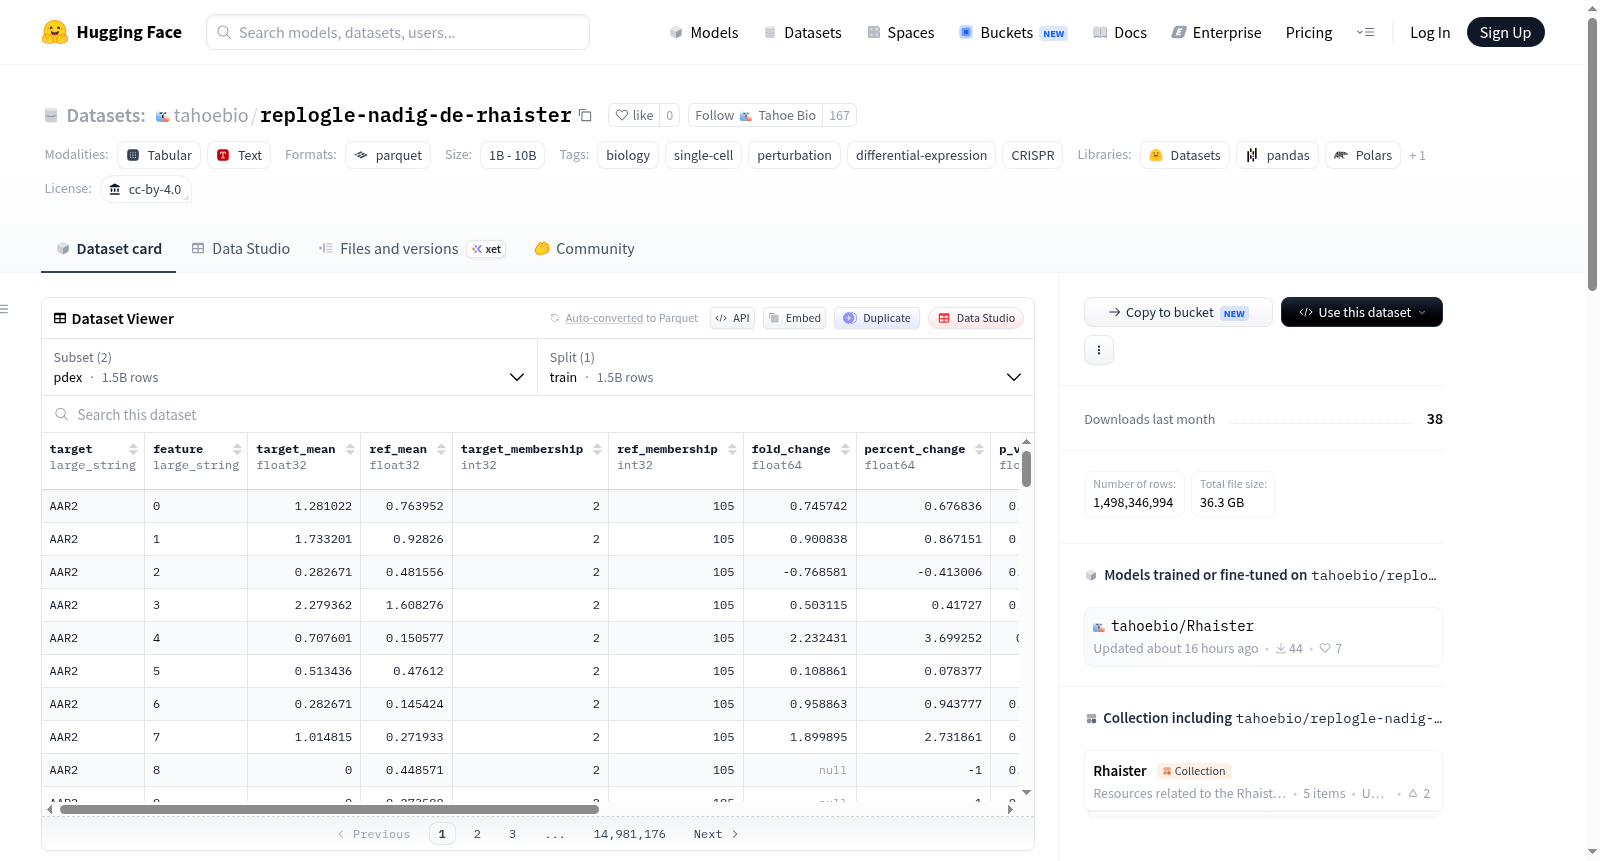
Replogle-Nadig CRISPR筛选差异表达汇总统计数据集,提供Replogle-Nadig基因组规模CRISPR筛选的差异表达汇总统计,涵盖4种细胞系(hepg2、jurkat、k562、rpe1)和约2000个基因敲降。数据包括每个基因的折叠变化、显著性及从原始单细胞汇总的伪批量差异,用于训练Rhaister模型。数据集包含两个表格:pdex(长格式,每行对应细胞系、测序批次、目标敲降基因和测量基因,约15亿行)和cell_eval(宽格式,每行对应细胞系、测序批次和目标基因,列包括约6546个测量基因的伪批量差异)。

Differential-expression summary statistics for the Replogle-Nadig genome-scale CRISPR screen, which includes 4 cell lines and ~2,000 gene knockdowns. Used to train Rhaister, the data are per-gene fold changes, significance, and pseudobulk deltas summarized from raw single cells. The four cell lines are hepg2, jurkat, k562, and rpe1 and the perturbation is a CRISPR knockdown of a target gene. The repository contains two tables: pdex (per-gene differential expression in long format) and cell_eval (pseudobulk expression deltas in wide format).
提供机构:
tahoebio
搜集汇总
数据集介绍
tahoebio/replogle-nadig-de-rhaister 数据集图片
构建方式
Replogle-Nadig CRISPR 筛选差异表达汇总统计数据集构建于大规模 CRISPR 干扰筛选实验之上,涵盖四种人类细胞系(HepG2、Jurkat、K562、RPE1)及约 2,000 个基因敲除扰动。原始单细胞数据经过伪批量聚合,计算每个基因在扰动组与对照组间的 log2 倍数变化、Mann–Whitney U 检验的 p 值及 Benjamini–Hochberg 校正后的 FDR 值。数据集以长格式存储于 `pdex` 表中,包含细胞系、测序批次、靶标基因与测定基因的多维交叉组合,总计约 15 亿行。另设 `cell_eval` 表以宽格式提供伪批量表达差异量,便于直接评估模型预测性能。数据分裂遵循组成式留出策略,确保测试集在细胞系与靶基因层面与训练集部分重叠但整体隔离。
特点
该数据集以高维稀疏性与多层级生物学信息为显著特征。每条记录同时标注细胞系来源、测序批次、CRISPR 靶标基因与测定基因,构成一个结构化的扰动-响应矩阵。差异表达指标涵盖效应量(倍数变化)、统计显著性(p 值与 FDR)及样本量(细胞数与分层计数),为深度生成模型提供了完整的监督信号。`pdex` 表的超大规模(超 15 亿行)与 `cell_eval` 表的紧凑宽格式形成互补,兼顾了细粒度差异分析与批量评估需求。数据预定义了 2,000 个高变基因作为分析焦点,并保留了整数索引到基因符号的映射文件,增强了兼容性与可重复性。
使用方法
用户可通过 HuggingFace `datasets` 库按配置名加载数据:使用 `load_dataset("tahoebio/replogle-nadig-de-rhaister", "pdex", streaming=True, split="train")` 获取长格式差异表达表,适用于逐基因差异分析或训练扰动预测模型;加载 `cell_eval` 配置则获得宽格式伪批量表达差异矩阵,适合直接对比或嵌入下游评估流程。数据集支持流式读取以处理超大规模数据。定义文件夹下的 `dataset.toml` 和分裂文件提供了数据的列语义与训练-测试分裂规则,用户还可利用 `hvg_2k_genes.json` 筛选高变基因,或通过 `feature_names.json` 将整数索引转换为基因符号,复现原始研究中的建模流程。
背景与挑战
背景概述
Replogle-Nadig CRISPR Screen Differential Expression Summary Statistics数据集由Tahoe Bio研究团队于近期构建,旨在系统性地解析CRISPR介导的基因敲除对转录组的影响。该数据集整合了四种人类细胞系(HepG2、Jurkat、K562和RPE1)中约2000个靶基因的敲除实验,通过单细胞测序技术获取了超过15亿条差异表达统计信息。其核心研究问题在于量化基因扰动后每个基因的表达变化,为功能基因组学、药物靶点发现及疾病机制研究提供高分辨率的数据基础。凭借其前所未有的规模和多细胞系覆盖,该数据集已成为单细胞扰动分析领域的重要基准,推动了Rhaister等预测模型的训练与验证。
当前挑战
该数据集主要面临的挑战包括:首先,在领域问题层面,如何从大规模单细胞CRISPR筛选中准确区分随机生物学变异与真实的扰动效应,尤其是面对极低表达基因或细胞数目稀少的条件时,Mann-Whitney U检验的统计效力可能不足。其次,构建过程中,跨56个测序批次的数据整合需要消除批次效应,同时保留生物学信号;此外,定义和筛选高变基因(约2000个)的过程需平衡计算效率与信息量,而组合式的留出分割策略虽缓解了数据泄露,却增加了验证复杂性和模型泛化评估的难度。
常用场景
经典使用场景
Replogle-Nadig CRISPR Screen Differential Expression Summary Statistics数据集,作为大规模单细胞CRISPR筛选差异表达统计数据的汇集,其最经典的使用场景在于评估基因敲低对多个细胞系中基因表达的量化影响。该数据集整合了HepG2、Jurkat、K562和RPE1四种细胞系中约2000个基因靶标的CRISPR敲低实验,提供了包括log2倍数变化、Mann-Whitney U检验p值及Benjamini-Hochberg校正后的FDR在内的详尽统计指标。研究人员可借此精准识别特定基因扰动下的差异表达基因,从而构建基因调控网络或探索细胞状态转变的分子机制。
实际应用
在实际应用中,该数据集常作为预训练数据用于开发机器学习模型,例如用于训练Rhaister模型以预测基因扰动后的表达变化。医药研发领域可从中提取关键基因靶点的作用模式,加速药物靶点发现与毒理学评估。此外,在精准医学中,它能够辅助构建细胞对特定扰动响应的预测模型,从而为个性化治疗策略提供数据基础。生物技术公司也可利用这份数据优化CRISPR文库设计,提升筛选实验的效费比。
衍生相关工作
基于该数据集,衍生出了一系列经典工作,涵盖差异表达分析方法的改进与单细胞扰动建模的突破。例如,研究者利用pdex表中的折叠变化与显著性指标开发了更稳健的扰动效应评估算法。同时,cell_eval宽表形式的设计启发了基于伪大量表达数据预测单细胞扰动响应的深度学习框架。这些工作不仅加深了对CRISPR筛选数据特征的理解,也为后续整合多模态单细胞数据、构建基因扰动图谱奠定了基础,推动了计算生物学在功能基因组学中的应用边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

