
遇见数据集

VladPyatov/CADFS

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

CADFS是一个用于参数化CAD模型生成的大规模数据集,支持从文本描述和多视图图像生成CAD模型。模型以FeatureScript程序表示,可直接导入Onshape环境。该数据集用于训练和评估CADFS-2B模型,这是一个基于Qwen2-VL-2B的多模态语言模型,适用于文本到CAD和图像到CAD的生成任务。数据集包含多个部分:处理后的数据(如全精度和简化精度的FeatureScript程序、文本注释、STEP文件)、原始数据(如未处理的FeatureScript程序、草图元数据、STEP和STL文件)、测试数据(包括CADFS、DeepCAD和CADParser基准测试)以及训练数据(分为两个阶段和两种输入模态)。数据集遵循ABC数据集结构,文件按模态、块ID和模型ID组织。

A large-scale dataset for parametric CAD model generation from text descriptions and multi-view images. Models are represented as FeatureScript programs, enabling direct import into Onshape environment. This dataset was used to train and evaluate CADFS-2B, a fine-tuned Qwen2-VL-2B multimodal language model for text-to-CAD and image-to-CAD generation. The dataset includes processed data (full-precision and reduced-precision FeatureScript programs, text annotations, STEP files), raw source data (unprocessed FeatureScript programs, sketch metadata, STEP and STL files), evaluation benchmarks (CADFS, DeepCAD, and CADParser subsets), and training splits (divided into two stages and two input modalities). Files are organized following the ABC dataset structure as {modality}/{chunk_id}/{model_id}.{ext}.

提供机构:
VladPyatov
原始信息汇总

数据集概述:CADFS

CADFS (CAD Program Dataset and Framework) 是一个用于参数化CAD模型生成的大规模数据集。其核心目的是支持通过文本描述和多视角图像生成CAD模型,模型表示为 FeatureScript 程序,可直接导入 Onshape 环境。

核心任务

  • Text-to-3D:根据文本描述生成3D CAD模型。
  • Image-to-3D:根据多视角图像生成3D CAD模型。

规模与语言

  • 数据集大小:100K < n < 1M
  • 语言:英语

许可与相关资源

  • 许可协议:Creative Commons Attribution 4.0 International (CC-BY-4.0)
  • 相关论文:arxiv: 2605.01925
  • 标签:CAD, code-generation

数据组成与结构

数据组织遵循ABC数据集结构:{modality}/{chunk_id}/{model_id}.{ext}。主要包含以下部分:

文件/目录 描述
dataset/featurescript_fp.zip 全精度处理的FeatureScript程序。
dataset/featurescript_rp.zip 精简精度变体(浮点数四舍五入至2位小数),用于模型训练和评估。此版本生成更紧凑的token表示,但可能导致部分模型不可编译。
dataset/text_annotations.zip 描述几何和拓扑的自然语言注释。
misc/ 辅助工具。
raw/ 原始数据源。
test_data/ 评估基准。
train_data/ 训练数据拆分。

数据预览

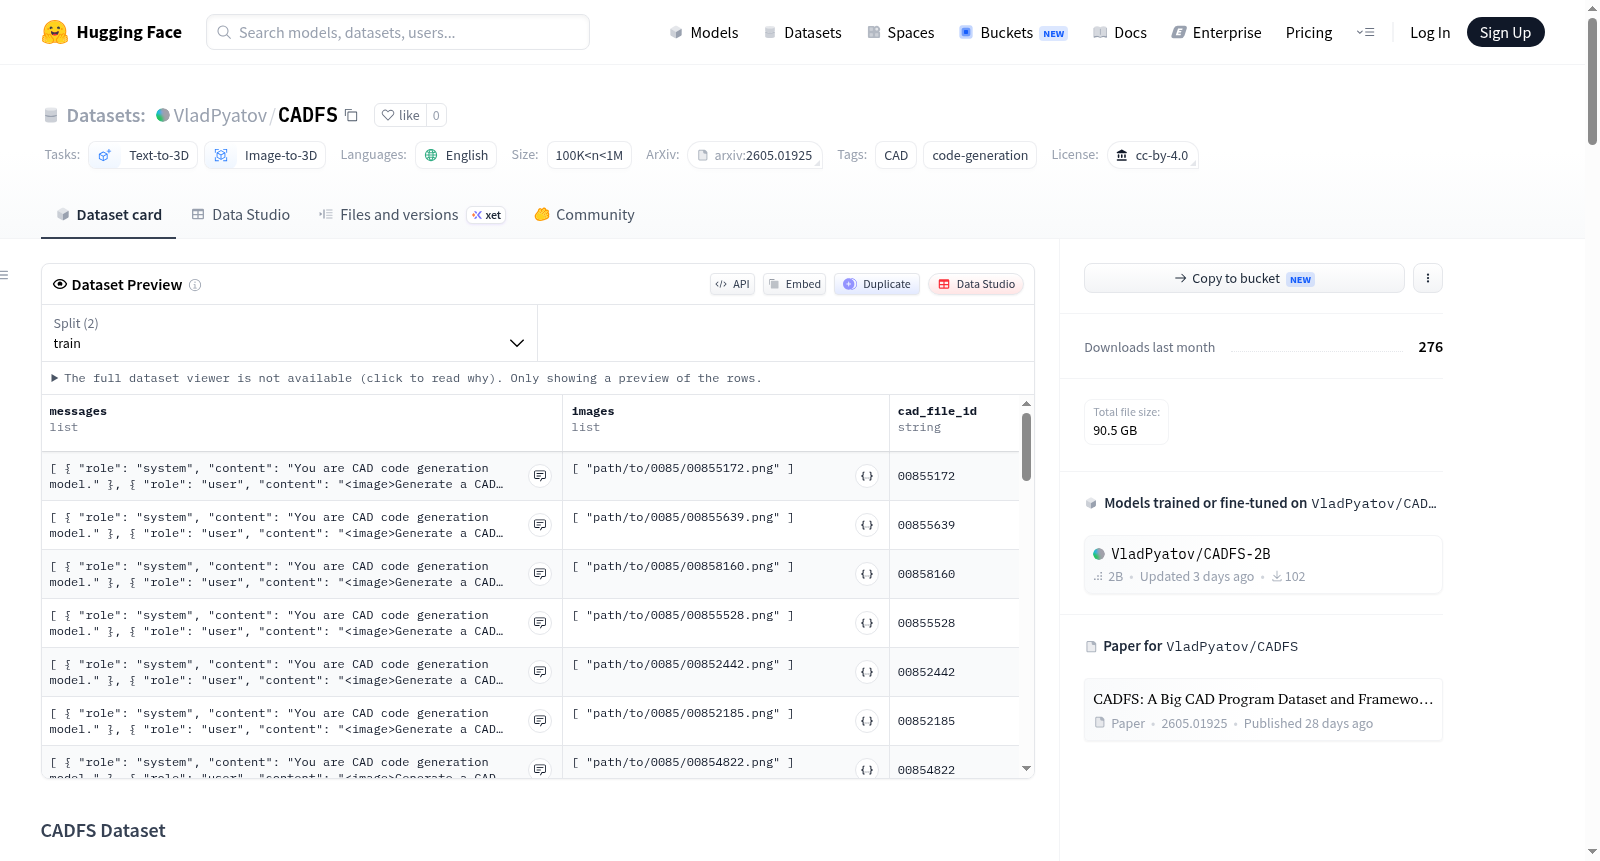
数据集包含default子集,分为traintest两个拆分。数据以对话形式组织,每条记录包含:

  • messages:一个对话列表,包含系统指令(设定为“你是一个CAD代码生成模型”)、用户提示(包含图像占位符和生成FeatureScript代码的指令)以及模型生成的FeatureScript代码回复。
  • images:与CAD模型关联的图像路径列表。
  • cad_file_id:CAD文件的唯一标识符。

使用情况

该数据集被用于训练和评估 CADFS-2B 模型,这是一个针对Text-to-CAD和Image-to-CAD任务微调的多模态语言模型(基于Qwen2-VL-2B)。
搜集汇总
数据集介绍
VladPyatov/CADFS 数据集图片
构建方式
在计算机辅助设计(CAD)领域,参数化模型的生成长期依赖手动操作,而CADFS数据集旨在通过大语言模型实现这一过程的自动化。该数据集以FeatureScript程序为核心,将CAD模型表示为代码,并严格按照ABC数据集结构进行组织。构建过程中,研究人员从原始FeatureScript程序中提取并处理了全精度与降精度(浮点数保留两位小数)两种版本的代码,同时利用GPT-OSS-120b为每个模型生成了描述几何、拓扑与设计意图的自然语言注释。此外,还提供了对应的STEP文件与多视角渲染图像,形成了完整的文本-代码-图像多模态数据体系。数据经由去重处理,最终筛选出约38万独特模型,并按照两阶段微调策略划分为训练、验证与测试子集。
使用方法
CADFS数据集的使用依托于其配套的GitHub仓库中的推理与处理流水线。用户可在HuggingFace平台直接获取约38万条训练样本,数据以jsonl格式存储,每条记录包含系统提示、用户输入(文本或图像路径)以及期望输出的FeatureScript代码。对于图像到CAD任务,用户需提供对应的多视角图像文件路径;文本到CAD任务则直接输入步骤化的建模描述。模型采用两阶段微调策略:第一阶段使用基础操作样本进行预训练,第二阶段使用高质量精选对进行精调,最终输出可直接导入Onshape环境的FeatureScript代码。建议在训练时控制上下文长度在8192个token以内,并优先使用降精度数据以获得更紧凑的表示。
背景与挑战
背景概述
CADFS(Computer-Aided Design FeatureScript)数据集由Vladislav Pyatov、Gleb Bobrovskikh等多位研究者于2026年构建,旨在推动大语言模型在参数化计算机辅助设计(CAD)领域的应用。该数据集包含超过十万个以FeatureScript程序表示的CAD模型,并配有自然语言描述和多视图图像,核心研究问题在于如何让多模态大语言模型理解并生成复杂的CAD几何逻辑。其发布显著提升了文本到CAD与图像到CAD生成任务的数据规模与质量,为工程设计与人工智能的交叉研究提供了宝贵资源,所训练的CADFS-2B模型在CVPR 2026上展示出强大性能,预示着智能制造与自动化设计的新方向。
当前挑战
CADFS数据集面临的核心挑战首先在于领域问题本身——CAD模型生成要求极高的几何精确性与代码可编译性,传统图像或文本生成任务中可接受的近似在CAD领域往往导致模型不可用。构建过程中,研究者需处理FeatureScript程序的全精度与降精度表示之间的权衡:降精度虽有利于语言模型训练,却可能破坏部分模型的编译性。此外,数据清洗与去重工作至关重要,需过滤几何或代码重复的模型以确保训练效果,同时要从ABC数据集等异构来源中提取、对齐多模态信息,这些步骤共同构成了数据构建的复杂挑战。
常用场景
经典使用场景
CADFS数据集在计算机辅助设计(CAD)与大型语言模型(LLM)交叉领域中扮演着基础性角色,其最经典的用途在于支持从自然语言描述或多视角图像到参数化CAD程序(FeatureScript代码)的端到端生成任务。研究者借助该数据集训练多模态语言模型,使其能够理解复杂的设计语义并自动生成可直接导入Onshape环境的结构化模型代码,这为智能三维建模开辟了全新的范式。
解决学术问题
该数据集有效回应了传统CAD建模中自动化程度低、设计复用困难等学术痛点。在此前的研究框架下,从文字或图像到实体CAD模型的转换缺乏大规模且结构化的标注数据支撑。CADFS通过提供超过38万条精简后的独特样本,并配以特征树元数据与自然语言注释,使得基于深度学习的程序合成与几何推理研究得以系统性展开,显著推动了三维形状理解与代码生成的理论进展。
实际应用
在实际工程与设计领域,CADFS催生了诸多颠覆性的应用场景。例如,工业设计师可通过输入简单的功能描述或参考照片,快速获得可编辑的参数化原形模型,大幅缩短产品迭代周期。在教育教学中,学生能够以自然语言示意设计意图,系统则自动生成对应的FeatureScript代码,降低了专业软件的学习门槛,提升了创意实现的效率。
数据集最近研究
最新研究方向
CADFS数据集聚焦于利用大规模语言模型与多模态视觉能力,推动计算机辅助设计领域从传统的几何建模向智能化、自动化方向演进。依托其包含数十万参数化CAD程序及其对应的文本描述与多视角图像,该数据集为文本到CAD与图像到CAD的生成任务提供了全新的训练与评估基准。当前前沿研究致力于通过两阶段微调策略,利用FeatureScript程序代码作为紧凑且可编译的表示形式,结合Qwen2-VL等视觉-语言模型,实现从自然语言或二维图像到三维实体模型的直接生成。这一方向不仅弥补了现有CAD数据集中高精度程序代码与自然语言注释之间的鸿沟,还显著降低设计门槛,为工业4.0场景下的快速原型设计与智能化制造铺平道路。CADFS的提出标志着生成式AI在工程设计与几何推理领域的深度融合,其影响力正向数字孪生、机器人自主操作及增强现实等热点应用辐射。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

