
遇见数据集

ai-models-2026

收藏
Hugging Face2026-09-04 更新2026-09-05 收录
官方服务:

资源简介:

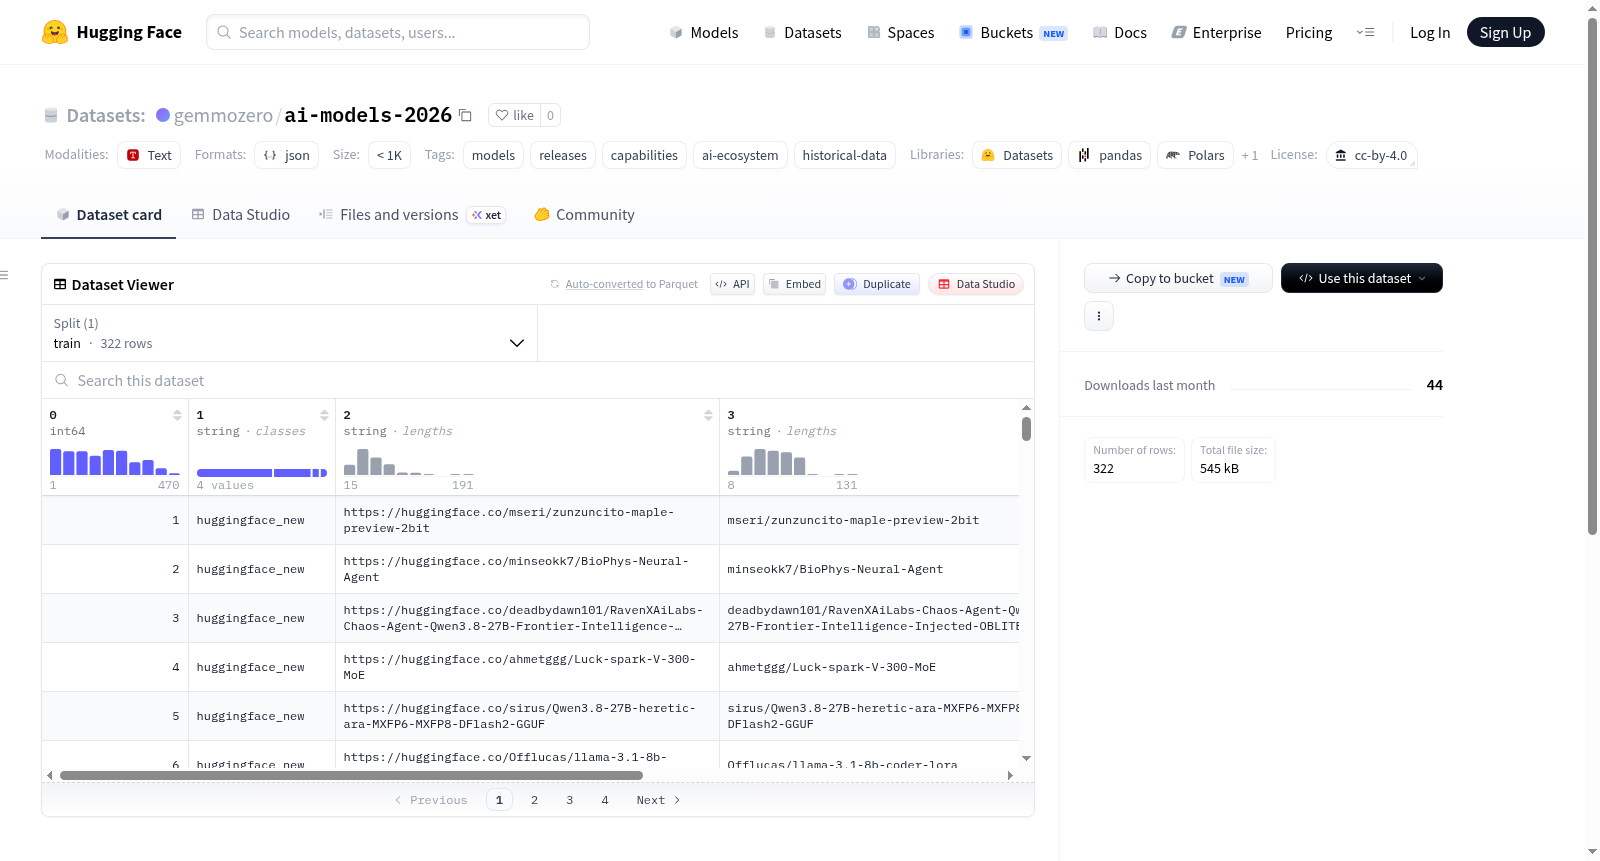
该数据集名为“AI Models & Releases 2026”,收录了2026年人工智能模型的发布信息、基准测试结果及能力指标。数据通过自动化采集管道从HackerNews、RSS订阅源和API等公共来源每日收集,并经过最小化处理以保持原始性。数据集规模小于1000个样本,属于Legion Data Factory项目的一部分,旨在记录和追踪AI生态系统的历史发展。该数据集适用于研究AI模型发布趋势、基准比较以及能力演进分析,尤其适合进行历史回顾和趋势挖掘。

The dataset named AI Models & Releases 2026 contains information on AI model releases, benchmark results, and capability metrics from 2026. Data is collected daily from public sources such as HackerNews, RSS feeds, and APIs through an automated pipeline, with minimal processing to preserve originality. The dataset comprises fewer than 1000 samples and is part of the Legion Data Factory project, aimed at documenting and tracking the historical evolution of the AI ecosystem. It is suitable for studying AI model release trends, benchmark comparisons, and capability evolution analysis, particularly for historical review and trend mining.

创建时间:
2026-08-23
原始信息汇总

数据集概述

  • 名称:AI Models & Releases 2026
  • 用途:收录2026年AI模型发布、基准测试及能力相关的信息
  • 更新频率:每日通过自动化采集流程更新

数据规模与类型

  • 数据量:少于1,000条记录(n<1K)
  • 数据类型:原始数据,包含模型发布动态、性能基准和模型能力描述

数据来源与方法

  • 采集来源:公开渠道(如HackerNews、RSS订阅、API接口)
  • 采集方式:通过每日定时任务(cron job)自动运行,仅经过最小化处理

许可证与归属

  • 许可证:CC BY 4.0(知识共享署名4.0国际版)
  • 所属项目:属于 Legion Data Factory 下2026年历史AI生态系统数据集系列之一

附加说明

  • 数据标签涵盖:模型(models)、版本发布(releases)、能力(capabilities)、AI生态系统(ai-ecosystem)、历史数据(historical-data)
搜集汇总
数据集介绍
ai-models-2026 数据集图片
构建方式
该数据集依托自动化采集管线,从HackerNews、RSS订阅源及各类公开API中系统性地收集全球AI模型发布、基准测试及能力演进的动态信息。每日通过定时任务(cron job)触发更新,确保数据的新鲜度与连续性。原始数据经过极简处理以保留其真实全貌,隶属于Legion Data Factory框架下的历史AI生态系统数据集系列,旨在构建一份覆盖2026年全年、可持续追溯的AI发展档案。
特点
作为一份面向未来的历史性数据集,其核心特色在于时间维度上的完整覆盖与动态更新机制,能够精准捕捉AI模型发布、性能基准变迁及能力图谱的瞬时状态。数据来源多元且经过规范化,适用于时间序列分析、技术趋势预测及生态演化研究。其原始数据属性赋予研究者极高的灵活度,便于进行个性化清洗与特征工程,以揭示模型迭代背后的深层规律与行业脉搏。
使用方法
研究者可直接利用该数据集进行AI生态的纵向对比分析,例如追踪特定模型架构的演进轨迹或横断面评测不同时期模型的综合表现。对于趋势预测,基于每日更新的时间戳可构建时序模型,识别技术突破与市场关注的周期性波动。数据集的CC BY 4.0许可授权允许在注明出处的前提下自由复用与再分发,便于集成至更庞大的研究管道或用于开发智能情报系统,以辅助决策与战略布局。
背景与挑战
背景概述
随着人工智能技术的迅猛发展,模型发布、基准测试与能力评估已成为衡量技术进步与生态演进的关键维度。在此背景下,由Legion Data Factory团队于2026年创建并维护的ai-models-2026数据集应运而生,致力于系统性地追踪AI模型发布动态及性能表现。该数据集通过自动化采集管线,每日从公开渠道(如HackerNews、RSS订阅及API接口)汇集全球范围内的模型发布信息、基准测试结果与能力变化,形成具有高时效性的历史数据集。其核心研究问题在于为AI生态提供结构化、可比对的演进记录,支撑技术趋势分析、性能对比及历史回溯研究。作为2026年AI生态历史数据系列的重要组成部分,该数据集凭借其持续更新机制与开源许可(CC BY 4.0),为研究人员、产业分析师及决策者提供了宝贵的参考资源,对理解AI领域的快速迭代与阶段性突破具有显著价值。
当前挑战
ai-models-2026数据集在构建与应用中面临多重挑战。就领域问题而言,AI模型发布信息分散于网络各处,来源异构且格式多样,自动采集需解决数据去重、信息完整性校验与实时性之间的平衡;同时,模型能力的量化与基准测试标准不断演变,如何确保历史数据的可比性并避免过时评价指标的误导性,是该数据集支持长期研究的关键难点。就构建过程而言,自动化采集管线依赖公共API与RSS源的稳定性,数据源波动或访问限制可能导致采集缺口,而最小化人工处理以确保原始性的原则,又对数据清洗流程的鲁棒性提出更高要求;此外,每日更新的高频次操作需兼顾资源消耗与数据质量的一致性。这些挑战要求数据集在动态更新中维持可靠性与溯源性,从而为AI生态的历史研究提供坚实的数据基石。
常用场景
经典使用场景
该数据集作为2026年人工智能模型发布与能力的全景式记录,在学术研究中常被用作时序分析的基准语料。研究者可基于其日级更新的特性,追踪模型发布频率、基准分数演变及能力维度迁移,从而构建AI技术发展轨迹的定量模型。其结构化字段为自然语言处理领域的模型对比研究提供了标准化样本,尤其适用于评测跨时间段的性能增益与饱和现象。此外,数据集的原始性与轻处理特性使其成为方法论验证的理想测试床,常用于检验自动化采集管道的有效性,以及在噪声数据下进行事件抽取与关系推断的算法设计。
解决学术问题
该数据集有效回应了人工智能领域长期存在的数据碎片化与回溯困难问题。此前,研究者难以获取统一、连续的模型发布记录,导致对技术演进规律的实证分析受阻。此数据集通过自动化管道,将分散于新闻源、API及社区讨论的信息加以整合,构筑了结实的时空连续性数据基础,从而支撑了关于AI进展节奏、技术突破点分布及领域间影响传递的量化研究。其存在显著推进了AI历史计量学与创新扩散理论在智能技术场景下的应用,为检验库恩式范式转换假说提供了难得的可计算证据。
衍生相关工作
基于此数据集,研究社区已衍生出多个方向的前沿工作。其一,利用时间序列预测模型对该数据进行外推,生成AI能力发展走势的预研报告;其二,结合自然语言处理技术,对模型发布告示进行细粒度特征提取,构建能力关键词的知识图谱;其三,运用网络分析方法,刻画不同AI实验室间引用与协作关系,揭示创新集群的演化。虽暂无特定引用此数据集的已发表论文,但其作为2026年全新资源,有望催生关于模型发布潮汐节律、对比基准漂移现象等新颖议题,并与上游的Legion Data Factory生态系统形成互补,推动AI元研究的系统化发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


