sample_sanskrit_pile
收藏资源简介:
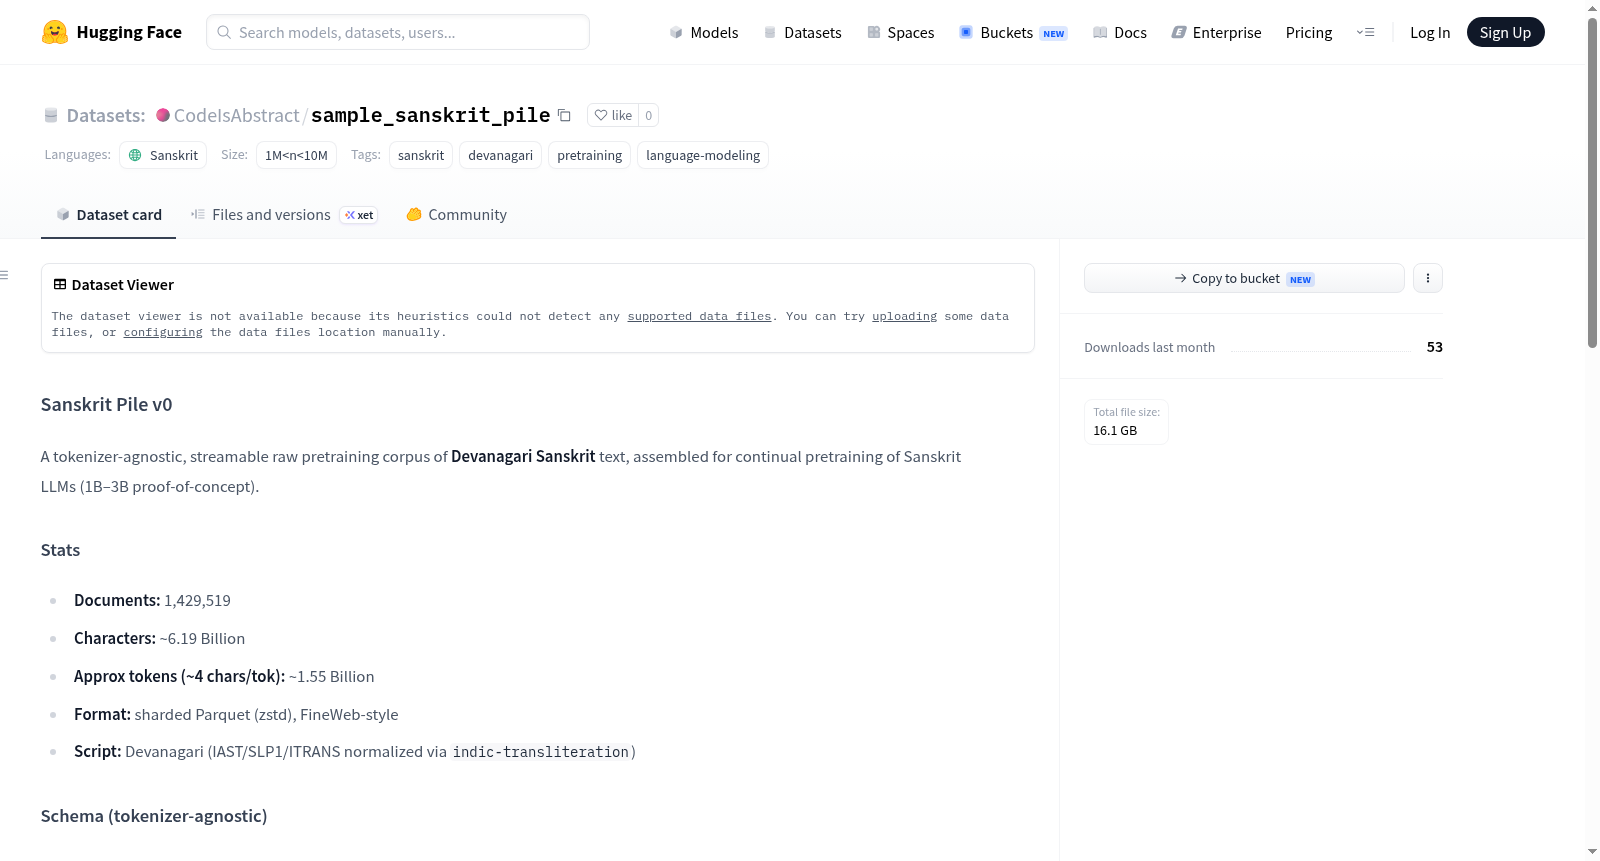
Sanskrit Pile v0 是一个面向梵语大语言模型(1B-3B规模概念验证)持续预训练的、分词器无关的可流式原始预训练语料库。该数据集包含约142.9万份文档,总计约61.9亿个字符,按平均每token约4字符估算,约合15.5亿token。数据以分片Parquet格式(zstd压缩)存储,采用类似FineWeb的风格。所有文本均使用天城文书写,并已通过`indic-transliteration`工具进行了IAST/SLP1/ITRANS标准化转写。数据集包含六个字段:唯一文档标识符(id)、未经任何分词处理的原始梵文文本(text)、数据来源标识(source)、原始URL(url)、文本字符长度(char_length)以及标准化前的原始文字脚本(raw_script)。数据主要来源于GRETIL、Sanskrit etexts、Digital Corpus of Sanskrit、Sanskrit Wikisource以及AI4Bharat Sangraha的已验证/未验证/合成梵语子集。其核心设计理念遵循The Pile/FineWeb方法:保持分词器无关性,支持任意BPE/WordPiece/词法分词器在此数据上进行训练;采用无损优先原则,当文字转换失败时保留原始文本;作为原始转储版本,有意保留了部分英文噪声和重复内容,精细清洗工作将留待v1版本在首个可读模型产出后进行。数据集许可证取决于各原始来源,此处仅为研究目的汇总。
Sanskrit Pile v0 is a tokenizer-agnostic, streamable raw pre-training corpus for continuous pre-training of Sanskrit large language models (proof-of-concept at 1B-3B scale). The dataset contains approximately 1.429 million documents, totaling about 6.19 billion characters, estimated at about 1.55 billion tokens based on an average of 4 characters per token. Data is stored in sharded Parquet format (zstd compressed), following a style similar to FineWeb. All text is written in Devanagari script and has been standardized through the `indic-transliteration` tool into IAST/SLP1/ITRANS transliterations. The dataset includes six fields: unique document identifier (id), raw Sanskrit text without any tokenization (text), data source identifier (source), original URL (url), text character length (char_length), and raw script before standardization (raw_script). Data is primarily sourced from GRETIL, Sanskrit etexts, Digital Corpus of Sanskrit, Sanskrit Wikisource, and the verified/unverified/synthetic Sanskrit subsets of AI4Bharat Sangraha. Its core design philosophy follows The Pile/FineWeb approach: maintaining tokenizer-agnosticism to support training with arbitrary BPE/WordPiece/lexical tokenizers; adhering to a lossless-first principle by retaining original text when conversion fails; and as a raw dump version, intentionally preserving some English noise and duplicates, with fine cleaning deferred to v1 after the first readable model is produced. Dataset licensing depends on the original sources, aggregated here for research purposes only.
数据集概述:Sanskrit Pile v0
这是一个专为梵语大型语言模型(1B–3B概念验证)持续预训练而设计的原始预训练语料库,包含天城体梵文文本,支持流式读取且与分词器无关。
数据规模
- 文档数量:1,429,519 篇
- 字符数:约 61.9 亿字符
- 预估词元数:约 15.5 亿词元(按每4字符1词元估算)
- 数据格式:分片 Parquet(zstd 压缩),采用 FineWeb 风格
数据内容与结构
- 脚本:天城体(已通过
indic-transliteration进行 IAST/SLP1/ITRANS 归一化) - 数据字段:
字段 类型 描述 id 字符串 文档唯一标识 text 字符串 天城体文本(未应用分词) source 字符串 来源名称(如 gretil, sawikisource, sangraha/verified 等) url 字符串 源 URL char_length 整数 文本的字符/字节长度 raw_script 字符串 归一化前的原始脚本
数据来源
- GRETIL(INDOLOGY/GRETIL-mirror)
- Sanskrit etexts(sanskrit/raw_etexts)
- Digital Corpus of Sanskrit(OliverHellwig/sanskrit)
- Sanskrit Wikisource(sawikisource 转储)
- AI4Bharat Sangraha — 包含 verified/san、unverified/san、synthetic/san_Deva
设计理念
- 无分词器介入:可直接用于训练任意 BPE、WordPiece 或形态分词器。
- 无损优先:脚本转换失败时,保留原始文本不丢弃。
- 原始转储:有意保留英语噪声和部分重叠内容,精细清理将在 v1 版本中进行。
使用示例
python from datasets import load_dataset ds = load_dataset("CodeIsAbstract/test_sanskrit_pile", split="train", streaming=True) for ex in ds: text = ex["text"] # 天城体文本,与分词器无关
许可协议
许可协议因来源而异,具体请参阅原始仓库条款。本数据集仅为研究目的聚合。