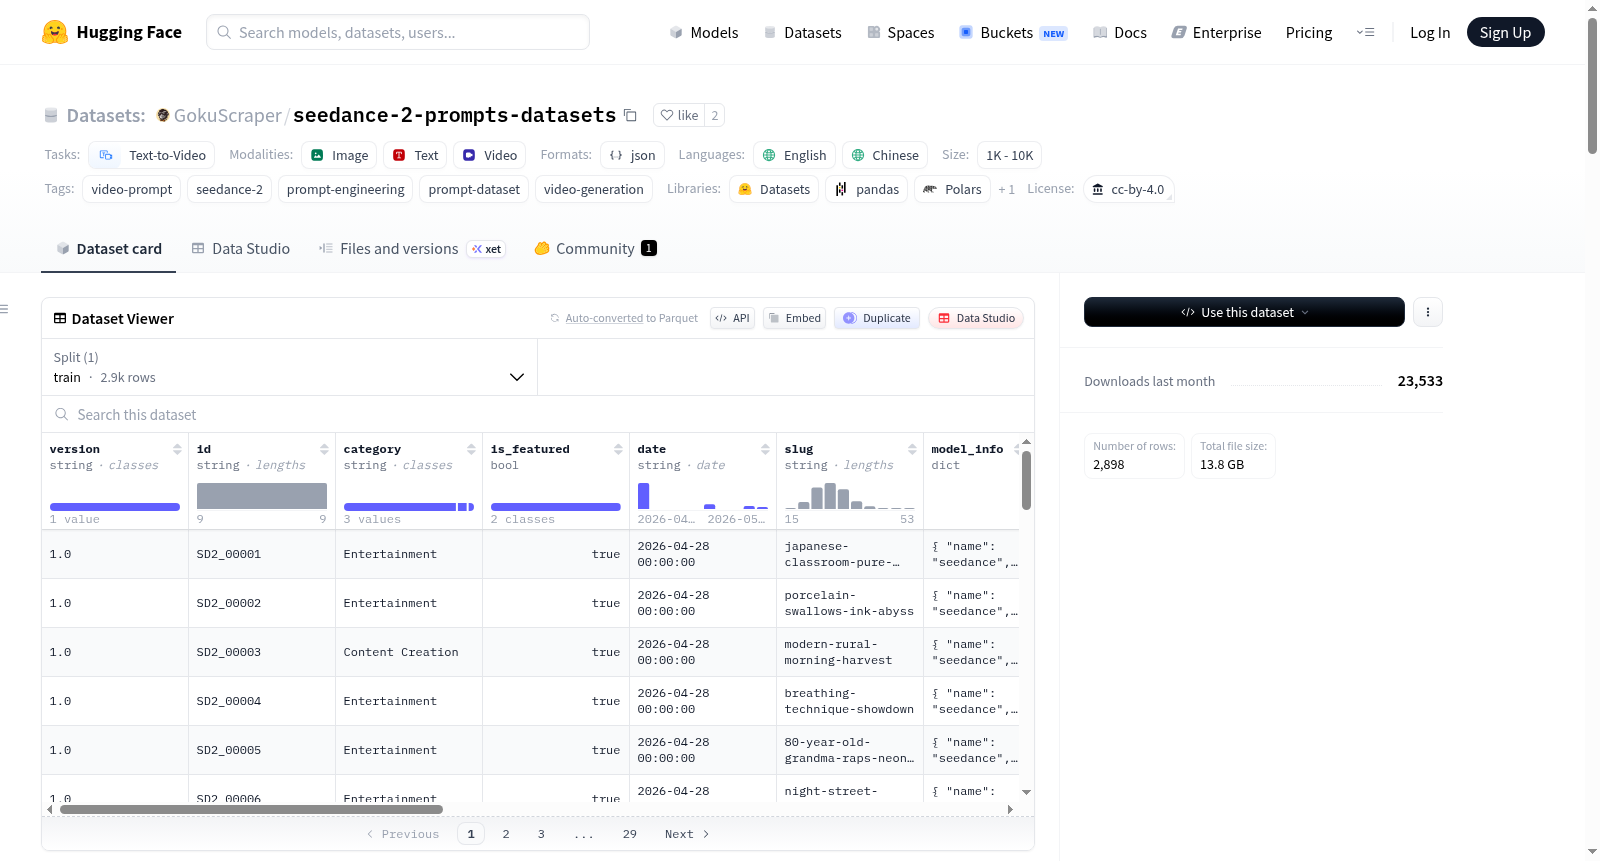
seedance-2-prompts-datasets
收藏资源简介:
Goku Seedance 2 视频提示词数据集是一个大规模、结构化的文本到视频生成提示词集合,专为开发者和研究人员设计。它旨在解决AI生态中提示词数据碎片化、缺乏标准、难以复用的问题,将网络上的提示词转化为可计算、可重新分发的数据资产。数据集核心包含超过2110个用于字节跳动Seedance 2.0等视频生成模型的提示词,以及对应的生成视频(.mp4)和封面图(.jpg)。所有数据通过一个高度结构化的JSONL文件(`metadata.jsonl`)进行组织和管理,该文件为每个样本提供完整的元数据,包括唯一标识符、类别、日期、原始提示词、模型信息、媒体文件路径、视频规格(如时长、分辨率、安全评级)以及支持中英文的双语标题、提示词和标签。数据集总大小超过12GB,适用于文本到视频生成任务的研究与开发,特别是提示工程、模型微调、生成内容分析以及构建AI视频创作工具链。数据采用CC BY 4.0许可证,允许商业使用和修改,但需署名。数据集完全开放,无需登录即可从Hugging Face平台直接下载或通过在线查看器浏览。
数据集概述
数据集名称:Goku Seedance 2 Video Prompts Dataset
数据集地址:https://huggingface.co/datasets/GokuScraper/seedance-2-prompts-datasets
许可证:CC BY 4.0(允许商业使用、修改、再分发,需注明原始来源)
语言:英语、中文
任务类别:文本到视频生成(text-to-video)
标签:视频提示词、提示词工程、提示词数据集、视频生成
数据集规模与构成
- 提示词总数:超过2110个
- 数据格式:JSONL(结构化元数据文件),附带MP4视频和JPG封面图片
- 数据集大小:12GB以上
- 数据分割:单个训练集(train),对应文件为
metadata.jsonl
数据结构与特征
每条记录包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
| version | string | 数据版本 |
| id | string | 唯一标识符 |
| category | string | 类别(如娱乐等) |
| is_featured | bool | 是否为精选 |
| date | string | 日期 |
| slug | string | 简短标识 |
| model_info | struct | 模型信息(名称、版本) |
| raw_p | string | 原始提示词 |
| media | struct | 媒体文件路径(视频、封面) |
| spec | struct | 规格(时长、宽高、比例、安全评级) |
| i18n | struct | 多语言支持(英文/中文,含标题、描述、标签) |
| platform | string | 来源平台 |
| sourceLink | string | 来源链接 |
| file_name | string | 文件名 |
数据集特点
- 100%开放:无需登录、无广告、无重定向,可直接下载或在线浏览。
- 结构化存储:使用JSONL格式,便于程序解析和导入数据库(如SQLite、Supabase)。
- 开发者友好:支持一行Python代码加载为Pandas DataFrame。
- 多语言支持:每条数据包含中英文双语版本,便于多语种研究与应用。
- 持续更新:自动同步,保持数据新鲜度。
数据用途
- 视频生成模型的提示词工程研究
- 文本到视频模型的训练与评估
- 多语言提示词数据分析与处理
- 提示词结构化存储与检索系统建设
免责声明
本数据集中的提示词和元数据来源于公开互联网社区,仅供学习、研究和数据结构化使用。原始生成内容的版权归原作者所有,本项目仅提供数据整理、结构化处理、分类和索引服务,不主张对原始内容的版权。