
遇见数据集

gratex/GNOTHEIA-synthetic-insurance-dataset

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

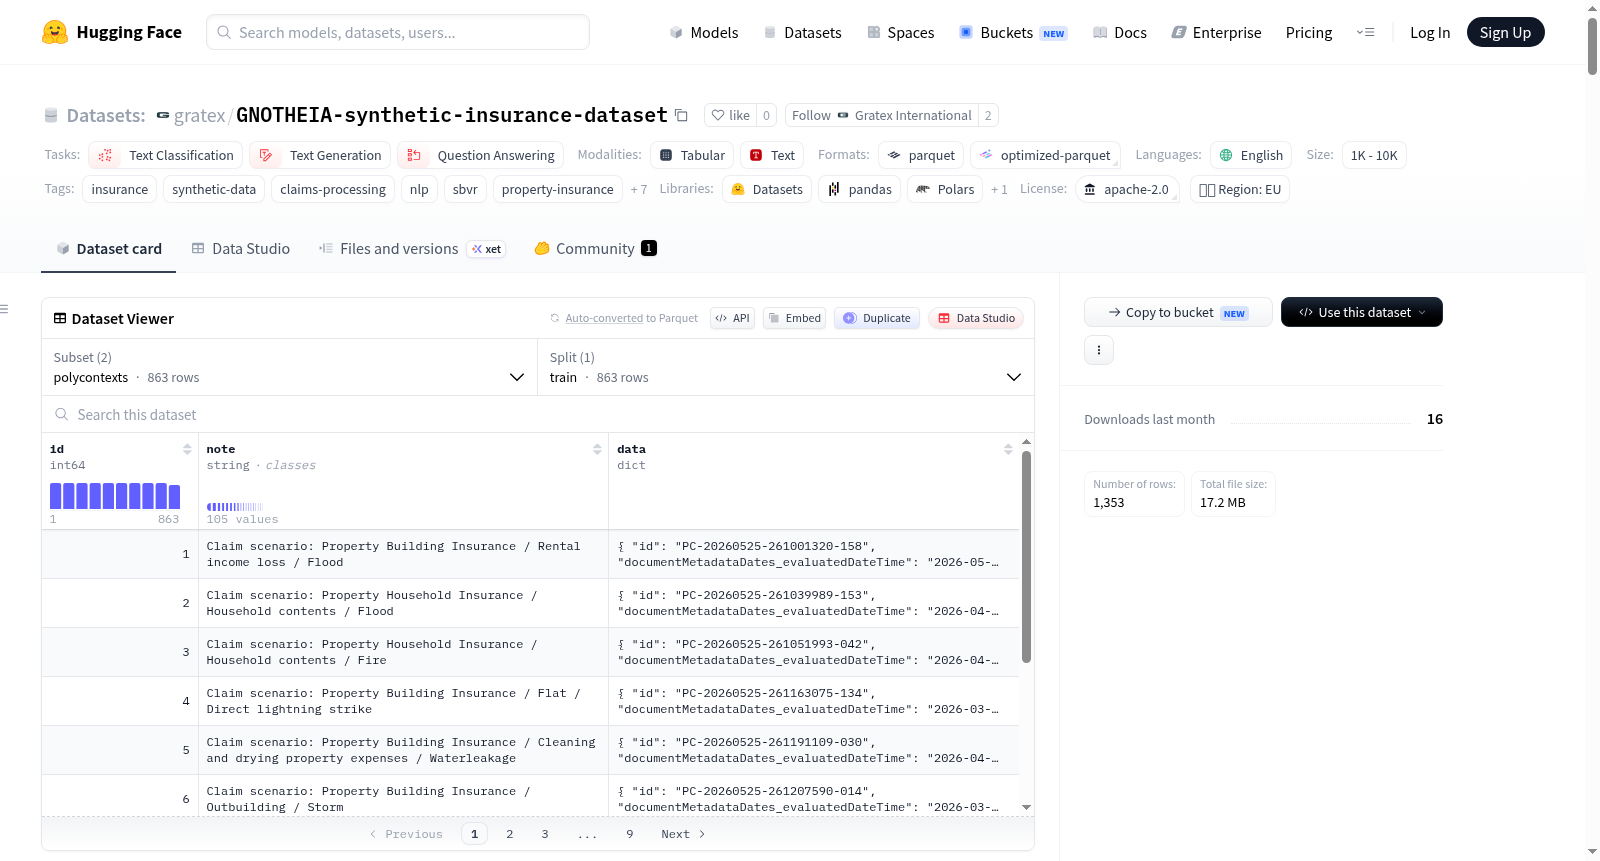
GNOTHEIA合成保险数据集是一个专门为AI系统设计的合成保险理赔数据集,用于通过OMG SBVR业务规则、结构化理赔多上下文和合成理赔相关文档来评估保险理赔。该数据集的主要目标是支持:LLM微调流程、SBVR推理基准和保险理赔AI评估。数据集完全由GNOTHEIA AI生态系统内的SyDaFa(合成数据工厂)引擎生成,包含863个多上下文记录和490条SBVR规则。多上下文数据集整合了结构化理赔数据、保单数据和理赔文档,而SBVR规则数据集则提供了财产和建筑保险领域的业务规则。数据集覆盖了家庭财产保险(PHI)和建筑保险(PBI)两种产品类型,以及火灾、水损、盗窃等多种风险。所有数据均为合成,不包含真实客户数据或个人可识别信息,适用于AI训练、评估和研究。

The GNOTHEIA Synthetic Insurance Dataset is a synthetic insurance claims dataset designed for AI systems that evaluate insurance claims using OMG SBVR business rules, structured claim polycontexts, and synthetic claim-related documents. The main goals of the dataset are to support: LLM fine-tuning pipeline, SBVR reasoning benchmarks, and insurance claim AI evaluation. The dataset is generated entirely synthetically using the SyDaFa (Synthetic Data Factory) engine within the GNOTHEIA AI ecosystem, containing 863 polycontext records and 490 SBVR rules. The polycontext dataset integrates structured claim data, policy data, and claim documents, while the SBVR rules dataset provides business rules in the field of property and building insurance. The dataset covers two product types: Property Household Insurance (PHI) and Property Building Insurance (PBI), along with various perils such as fire, water damage, and theft. All data is synthetic, with no real customer data or personally identifiable information, making it suitable for AI training, evaluation, and research.

提供机构:
gratex
搜集汇总
数据集介绍
gratex/GNOTHEIA-synthetic-insurance-dataset 数据集图片
构建方式
该数据集由Gratex International a.s.在InnovAIte项目框架下开发,依托GNOTHEIA人工智能生态中的SyDaFa引擎完全合成生成。其构建方式采用了OMG SBVR规则优先策略,即从预设的损失事件场景出发,以确定性的方式选取相关规则集,随后生成包含索赔元数据、保单信息及支持性文档在内的完整索赔多上下文结构,最终以JSON格式封装。这一逆向于传统文档扫描的流水线,确保了规则与上下文的高度一致性,并为后续LLM的微调与推理提供了结构化基础。
特点
数据集兼具结构复杂性与领域特异性,核心创新在于将OMG SBVR形式的业务规则与保险索赔多上下文对象深度融合。它提供863个多上下文记录和490条SBVR规则,覆盖房屋与建筑保险两大产品线、五大文档类型及十二类损失事件。每条例均带有产品、风险组等标签,便于按需过滤与评估。所有数据均为合成生成,不含真实个人信息,确保了隐私合规性与研究使用的安全性,同时严格通过JSON模式验证,质量可控。
使用方法
该数据集支持通过Hugging Face的datasets库或pandas直接加载Parquet格式文件。研究人员可针对多上下文数据集(polycontexts)进行LLM微调,训练模型理解保险文档、政策信息与结构化上下文之间的语义关联;亦可利用独立的SBVR规则数据集(rules-dataset)进行规则推理与基准测试。每个多上下文对象中的规则字段的status与statusReasoning字段被有意留空,专用于模型基于文档和保单信息进行自主评估与填充,从而模拟真实的智能理赔评价流程。
背景与挑战
背景概述
GNOTHEIA-synthetic-insurance-dataset 是由斯洛伐克软件企业 Gratex International a.s. 于 2026 年 5 月发布,隶属于该国国家级人工智能战略项目 InnovAIte。该数据集专为财产保险(家庭与建筑险)理赔的智能评估设计,其核心创新在于将 OMG SBVR(业务词汇与业务规则语义)标准与大语言模型(LLM)相结合。通过名为 SyDaFa 的合成数据引擎,数据集生成了 863 个结构化的理赔“多上下文”以及 490 条 SBVR 规则,旨在弥合传统规则引擎(依赖规范化事实)与 LLM 对非结构化文档自主推理之间的鸿沟。该工作为保险行业构建可解释、符合欧盟 AI 法案的高风险 AI 系统提供了关键基准资源,推动了 AI 在业务规则推理领域的标准化进程。
当前挑战
该数据集所应对的领域核心挑战在于,保险理赔评估需融合多源异构信息(如保单条款、警方报告、发票等自然语言文档)与形式化业务规则进行逻辑推理,传统方法难以在自动化与可解释性间取得平衡。在构建过程中,首要挑战是如何在杜绝真实个人身份信息(PII)的前提下,生成具备真实世界统计分布特征的理赔场景,这要求 SyDaFa 采用“规则优先”的逆向生成策略,从损失事件出发构建完整上下文。其次,确保 SBVR 规则与文档内容间的因果一致性、控制规则标签(如适用险种、赔付主体)的精确映射,以及跨产品类型(PHI 与 PBI)的覆盖广度,均对合成流程的严谨性提出了极高要求。
常用场景
经典使用场景
GNOTHEIA-synthetic-insurance-dataset作为以SBVR规则为核心的合成保险理赔数据集,其经典使用场景聚焦于大语言模型(LLM)的保险领域微调与评估。研究者可利用该数据集中的结构化理赔上下文(polycontext)与SBVR业务规则,训练模型在财产险场景下执行文档理解、规则推理与决策支持任务。具体而言,模型需从包含首次损失通知、照片证据、发票、警方确认书及在线提交表单等五类文档的合成理赔档案中提取关键信息,并依据OMG SBVR标准形式化的业务规则(如义务、禁止、许可等道义模态)对理赔案例进行合规性判定与状态预测,形成从非结构化文本到结构化逻辑输出的端到端处理能力。
实际应用
在实际产业应用中,该数据集支撑了保险公司理赔评估的自动化与智能辅助决策流程。通过对LLM进行微调,模型能够基于SBVR规则自动解析首次损失通知、比对保单条款与受损物项清单,并在评估门控(如CLAIM_REGISTRATION、CLAIM_ASSESSMENT)中输出推荐状态(如支付、拒绝或待定)。这显著缩短了人工审核周期,降低了因信息遗漏或规则误判导致的合规风险。此外,数据集支持多产品线(家庭财产险PHI、建筑险PBI)与12+种风险事件(火灾、水损、盗窃等)的模拟,使保险公司能在安全沙盒中测试AI系统对复杂或边缘案例的响应能力,为实际部署提供高置信度参考。
衍生相关工作
该数据集催生了多项蕴含深远影响的相关研究工作。基于SyDaFa引擎的生成范式,衍生出面向保险文档的多模态规则学习框架,推动了SBVR形式化逻辑在LLM微调管道中的深度集成。研究团队进一步拓展了理赔场景复杂度,如纳入责任险与附加服务条款,并引入真实理赔分布统计以增强数据多样性。同时,该数据集作为Benchmark激励学术界探索规则驱动的少样本推理与模型置信度校准方法,其开源特性(Apache 2.0)使得EU AI Act中高风险系统的可审计性要求得以通过合成数据提前验证,从而为保险科技行业的负责任AI部署提供了可复现的基线范例。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

