
遇见数据集

dev-ahmedhany/everyayah-wav

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

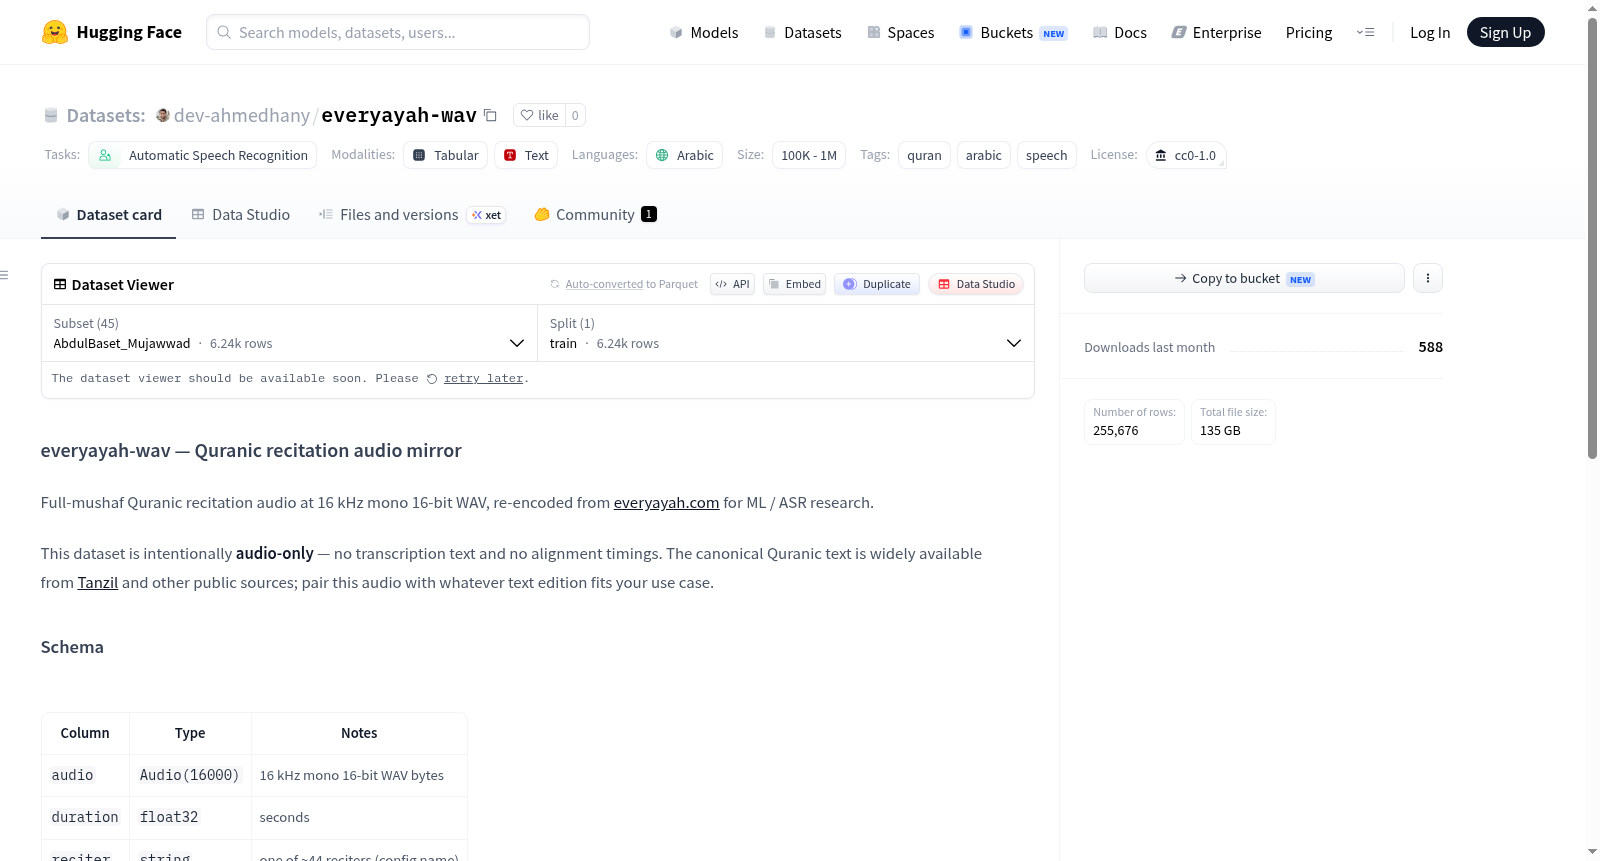
everyayah-wav是一个古兰经朗诵音频数据集,作为古兰经朗诵音频的镜像资源。它包含完整的古兰经朗诵音频,以16 kHz单声道16位WAV格式重新编码,源自everyayah.com,专为机器学习和自动语音识别研究设计。该数据集仅包含音频数据,无转录文本或对齐时间戳,用户可结合广泛可用的古兰经文本(如Tanzil)使用。数据集包含约44位不同朗诵者(如AbdulBaset_Murattal、Alafasy等)的录音,每个音频文件附带持续时间(秒)、朗诵者名称、苏拉(章节,编号1-114)和阿亚(经文,在苏拉内从1开始索引)信息。音频数据以parquet文件格式存储,适用于ASR任务。

everyayah-wav is a Quranic recitation audio dataset, serving as a mirror of Quranic recitation audio. It contains full-mushaf Quranic recitation audio re-encoded at 16 kHz mono 16-bit WAV from everyayah.com for ML / ASR research. The dataset is intentionally audio-only, with no transcription text or alignment timings; users can pair it with widely available Quranic text editions (e.g., from Tanzil). It includes recordings from approximately 44 reciters (e.g., AbdulBaset_Murattal, Alafasy), with each audio file accompanied by duration (seconds), reciter name, surah (chapter, numbered 1-114), and ayah (verse, 1-indexed within surah) information. The audio data is stored in parquet files and is suitable for automatic speech recognition tasks.
提供机构:
dev-ahmedhany
搜集汇总
数据集介绍
dev-ahmedhany/everyayah-wav 数据集图片
构建方式
该数据集源自everyayah.com上公开的古兰经吟诵音频,经过重编码处理,统一转换为16千赫兹单声道16位WAV格式,旨在为机器学习与自动语音识别研究提供高质量的语音资源。数据集保留了音频文件及其对应的元数据,包括诵读者身份、章节编号以及经文序号,但刻意摒弃了转录文本与时间对齐信息,以保持数据的中立性与灵活性。所有音频均来源于公共领域的MP3文件,并遵循CC0 1.0协议开放使用,确保了数据集的自由获取与再分发。
特点
数据集汇聚了约44位不同诵读者的音频片段,覆盖了古兰经的全部114个章节,每位诵读者的录音被独立配置为子数据集,便于研究者针对特定诵读者或风格进行聚焦分析。音频时长以秒为单位精确记录,且每个样本均包含完整的诵读者、章节与经文索引,为多维度检索与跨诵读者比较提供了坚实的数据基础。这种结构化的设计使得数据集在细粒度语音识别、声纹分析与阿拉伯语音学研究中具有显著优势。
使用方法
用户可通过HuggingFace datasets库直接加载该数据集,例如使用`load_dataset('dev-ahmedhany/everyayah-wav', name='Maher_AlMuaiqly', split='train')`即可获取指定诵读者的训练集。加载后的数据包含音频字节流、时长、诵读者、章节及经文编号等字段,可借助soundfile等库将音频字节流解码为数值数组进行后续处理。由于数据集不提供预设的训练/验证/测试划分,用户可根据研究需求自行分割,或与来自Tanzil等公开资源的古兰经文本进行灵活配对,以构建完整的语音识别管线。
背景与挑战
背景概述
在自动语音识别(ASR)领域,尤其是针对宗教典籍的语音数据资源极为稀缺,而《古兰经》的吟诵语音因其独特的韵律和语言学价值成为一项极具挑战的研究对象。everyayah-wav数据集由研究人员基于everyayah.com公开的MP3音频重新编码而成,以16kHz单声道16位WAV格式提供完整的《古兰经》吟诵语音,收录了包括AbdulBaset、Alafasy、Sudais在内的约44位著名吟诵者的录音。该数据集的核心设计理念在于提供纯净的音频素材,刻意不包含转录文本和时间对齐信息,旨在鼓励研究者灵活搭配Tanzil等公开的经文文本,推动多语种、多风格的《古兰经》语音识别研究,为伊斯兰语音技术和文化遗产数字化提供了重要基础资源。
当前挑战
该数据集所解决的领域问题在于填补《古兰经》吟诵语音识别的空白,特别是应对阿拉伯语方言多样性、吟诵风格差异(如Murattal与Mujawwad两种风格)以及长音频序列的音素对齐难题。构建过程中面临的挑战包括:从非标准压缩格式(MP3)中提取并转换为高质量的线性PCM音频,确保44位吟诵者的录音一致采样为16kHz并保持原始韵律特征;由于每段录音对应特定经文节,需严格验证surah(章)与ayah(节)的索引准确性,避免因人工标注错误导致数据污染;此外,不同吟诵者的发音速度、停顿习惯和情感表达差异显著,增加了模型对声学特征泛化能力的训练难度。
常用场景
经典使用场景
在自动语音识别(ASR)研究领域,everyayah-wav数据集凭借其独特的高质量《古兰经》诵读音频资源,成为训练和评估阿拉伯语语音识别系统的瑰宝。该数据集涵盖了约44位著名诵经家的诵读风格,每位诵经家的音频均以16kHz单声道16位WAV格式精心编码,为学术界提供了一个兼具多样性与纯净度的语音语料库。研究者可基于此数据集构建端到端的语音识别模型,探索阿拉伯语语音在韵律、语调及发音细节上的复杂模式,尤其适合那些致力于提升低资源语言或宗教典籍语音识别性能的前沿课题。
解决学术问题
该数据集的核心学术贡献在于它填补了高质量、多风格阿拉伯语诵读语音资源的空白,有效解决了传统ASR研究中因语料单一而导致模型泛化能力不足的困境。通过提供同一文本(《古兰经》)下不同诵经家的多种演绎方式,它使得研究者能够系统探究说话人变异对语音识别精度的影响,从而推动声学建模中的说话人归一化与自适应技术发展。此外,数据集的CC0公共领域许可协议也打破了版权壁垒,极大促进了阿拉伯语音学、比较语音学以及计算语言学的跨学科融合研究。
衍生相关工作
围绕everyayah-wav数据集已衍生出多项富有影响力的研究工作,其中最典型的包括基于注意力机制的端到端《古兰经》章节分割与标注系统,以及利用迁移学习技术将通用阿拉伯语ASR模型适配至宗教诵读场景的工作。部分学者还以此为基础,开发了融合音高与能量特征的诵读风格分类器,用于自动辨识不同诵经家的独特旋律模式。在无监督学习领域,该数据集也被用于验证对比预测编码(CPC)和wav2vec 2.0等自监督方法在语音表征学习中的有效性,探索了无需转录文本即可捕获语音单元边界的技术路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

