americasnlp_2025_guarani_analysis
收藏资源简介:
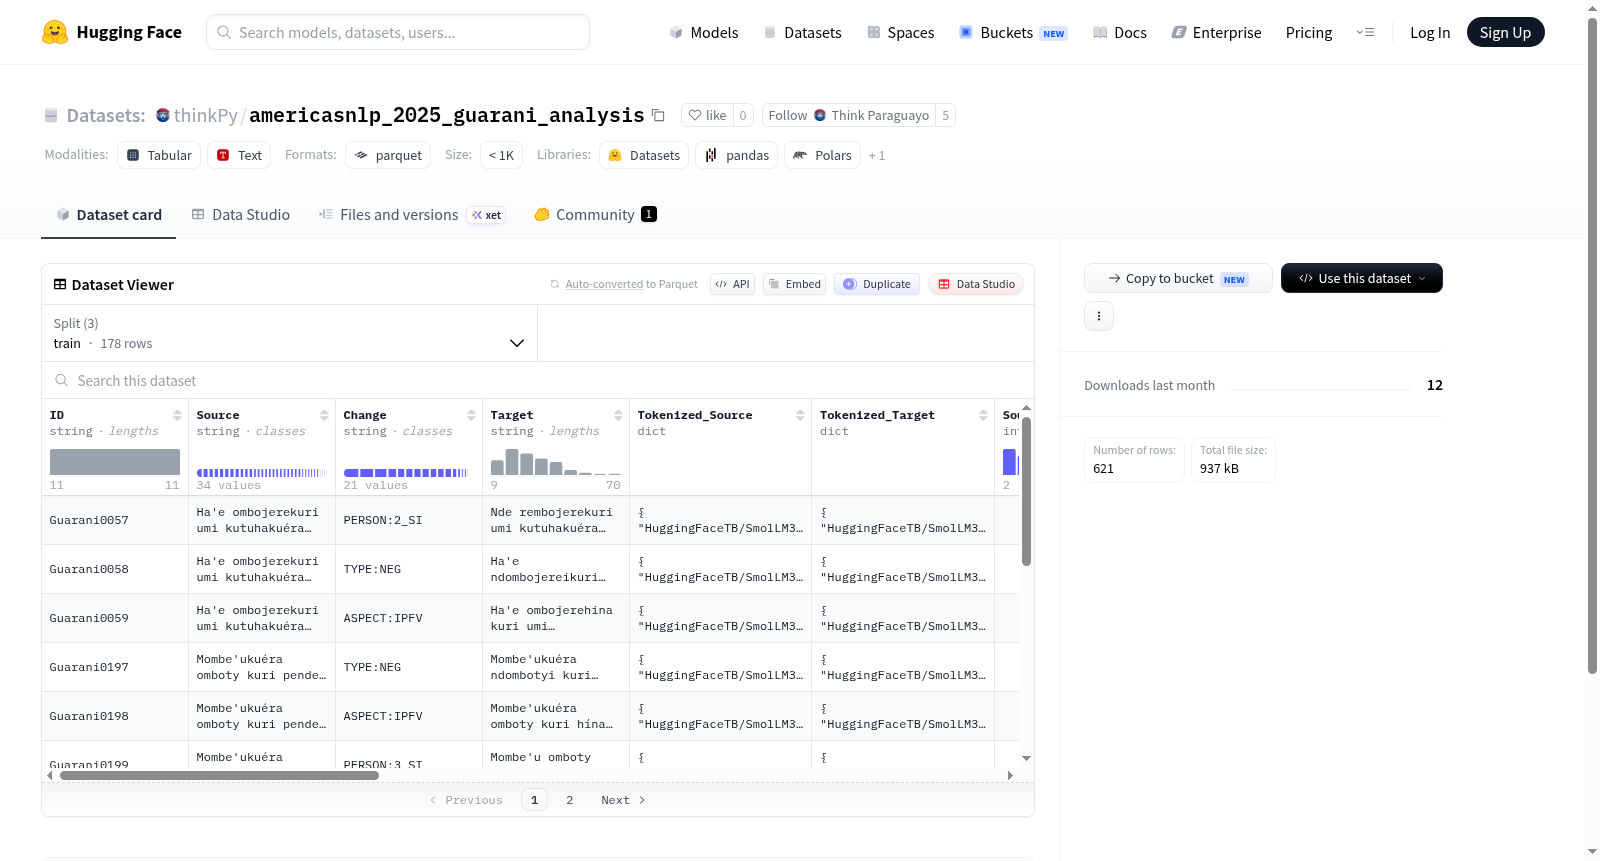
该数据集是一个用于文本转换与改写研究的语料库,核心包含源文本(Source)、目标文本(Target)以及描述两者间修改意图的变化描述(Change)。每个样本均具有唯一标识符(ID)。数据集的突出特点是其深度整合了针对多个主流大语言模型的分词分析数据。具体而言,它为源文本和目标文本分别预计算了超过20种不同大语言模型(包括Llama、Qwen、Gemma、DeepSeek、Mistral、GLM等系列模型)的分词结果(Tokenized_Source, Tokenized_Target)、对应的token数量(Source_Token_Count, Target_Token_Count)以及一个称为“繁殖力指标”(Fertility_Metric)的度量。此外,还提供了词数统计(Word_Count)和用于衡量源目标文本在分词层面差异的Token距离及其归一化值(Token_Distance, Token_Distance_Normalized),以及形态学分词信息(Morphological_Tokens)。数据集划分为训练集(178个样本)、开发集(79个样本)和测试集(364个样本)。该数据集适用于文本改写、风格迁移、机器翻译后编辑等任务的研究,尤其便于进行跨不同大语言模型分词器的对比分析、文本压缩效率评估、以及构建与具体模型分词器无关的文本转换基准测试。
This dataset is a corpus for text transformation and rewriting research, core components including source text (Source), target text (Target), and a change description (Change) that describes the modification intent between them. Each sample has a unique identifier (ID). The datasets standout feature is its deep integration of tokenization analysis data for multiple mainstream large language models. Specifically, it precomputes for both source and target texts the tokenization results (Tokenized_Source, Tokenized_Target), corresponding token counts (Source_Token_Count, Target_Token_Count), and a measure called the Fertility Metric for over 20 different large language models (including series such as Llama, Qwen, Gemma, DeepSeek, Mistral, GLM). Additionally, it provides word count statistics (Word_Count), token distance and its normalized value (Token_Distance, Token_Distance_Normalized) to measure differences at the tokenization level between source and target texts, as well as morphological token information (Morphological_Tokens). The dataset is divided into training set (178 samples), development set (79 samples), and test set (364 samples). It is suitable for research in text rewriting, style transfer, machine translation post-editing, and other tasks, particularly facilitating cross-model tokenizer comparative analysis, text compression efficiency evaluation, and the construction of model-agnostic text transformation benchmarks.
数据集概述
数据集名称: americasnlp_2025_guarani_analysis
数据集地址: https://huggingface.co/datasets/thinkPy/americasnlp_2025_guarani_analysis
数据规模:
- 总大小: 3,167,788 字节
- 下载大小: 920,044 字节
- 包含 621 个样本,分为三个子集:
- 训练集 (train): 178 个样本,1,212,059 字节
- 开发集 (dev): 79 个样本,483,815 字节
- 测试集 (test): 364 个样本,1,471,914 字节
数据特征: 数据集包含以下字段:
ID(string): 样本唯一标识符Source(string): 源文本Change(string): 变更记录Target(string): 目标文本Tokenized_Source(struct): 29 个不同模型对源文本的分词结果Tokenized_Target(struct): 29 个不同模型对目标文本的分词结果Source_Word_Count(int64): 源文本词数Target_Word_Count(int64): 目标文本词数Source_Token_Count(struct): 29 个模型对源文本的分词数量Target_Token_Count(struct): 29 个模型对目标文本的分词数量Source_Fertility_Metric(struct): 29 个模型在源文本上的词汇丰富度指标Target_Fertility_Metric(struct): 29 个模型在目标文本上的词汇丰富度指标Token_Distance(struct): 29 个模型的词元距离Token_Distance_Normalized(struct): 29 个模型的归一化词元距离Morphological_Tokens_Source(list of string): 源文本形态学词元Morphological_Tokens_Target(list of string): 目标文本形态学词元
涉及的模型(共 29 个):
- HuggingFaceTB/SmolLM3-3B
- LiquidAI/LFM2.5-350M
- LiquidAI/LFM2.5-8B-A1B
- MiniMaxAI/MiniMax-M2.7
- Qwen/Qwen2.5-7B-Instruct
- Qwen/Qwen3-0.6B
- Qwen/Qwen3.5-397B-A17B
- Qwen/Qwen3.5-4B
- XiaomiMiMo/MiMo-V2.5-Pro
- deepseek-ai/DeepSeek-V3.2
- deepseek-ai/DeepSeek-V4-Flash
- google/gemma-2-2b-it
- google/gemma-3-1b-it
- google/gemma-3-27b-it
- google/gemma-4-31B-it
- meta-llama/Llama-3.1-8B-Instruct
- meta-llama/Llama-3.2-3B-Instruct
- meta-llama/Llama-3.3-70B-Instruct
- microsoft/Phi-3-mini-4k-instruct
- microsoft/Phi-4-mini-instruct
- mistralai/Mistral-7B-Instruct-v0.3
- mistralai/Mistral-Medium-3.5-128B
- moonshotai/Kimi-K2.5
- moonshotai/Kimi-K2.6
- openai/gpt-oss-120b
- openai/gpt-oss-20b
- openbmb/MiniCPM5-1B
- zai-org/GLM-4.6
- zai-org/GLM-5.1
数据文件配置:
- 默认配置名:
default - 数据文件路径:
- 训练集:
data/train-* - 开发集:
data/dev-* - 测试集:
data/test-*
- 训练集: