FinSearchComp
收藏资源简介:
FinSearchComp是一个开源的端到端代理基准,用于评估开放域的金融搜索和推理能力。数据集包括三个任务:时效性数据获取、简单历史查询和复杂历史调查,共635个问题,覆盖全球和中国市场。数据集由70名专业金融专家进行标注,并通过多阶段的质量保证流程确保难度和可靠性。
FinSearchComp is an open-source end-to-end agent benchmark designed to evaluate open-domain financial search and reasoning capabilities. The dataset consists of three tasks: timely data acquisition, simple historical queries, and complex historical investigations, with a total of 635 questions covering both global and Chinese markets. It was annotated by 70 professional financial experts, and a multi-stage quality assurance process was adopted to ensure the difficulty and reliability of the dataset.
FinSearchComp 数据集概述
数据集简介
FinSearchComp 是首个专为开放域金融搜索设计的开源基准测试,旨在评估金融数据检索与分析的核心技能,包括查找正确信号、核对和协调来源,以及在时间压力下形成有根据的判断。
数据集规模与结构
- 问题数量:635 个专家精心设计的问题,确保真实世界的相关性和准确性。
- 子任务类型:包含 3 个子任务(时间敏感数据获取、简单历史查询、复杂历史调查),覆盖全球和大中华区两个子集。
子任务详情
T1: 时间敏感数据获取
测试检索时间敏感、频繁更新的数据的能力。
- 示例:IBM 最新收盘价。
- 答案特性:动态变化,通过实时 API 查询获取。
T2: 简单历史查询
测试检索特定的、非时间敏感的历史事实的能力。
- 示例:截至 2020 年 9 月 27 日,星巴克的总资产是多少?
- 答案特性:允许四舍五入误差。
T3: 复杂历史调查
测试执行多步推理、聚合和计算的能力。
- 示例:从 2010 年 1 月到 2025 年 4 月,标普 500 指数在哪个月份出现了最大的单月涨幅?
- 答案特性:允许误差范围。
数据构建与来源
时间敏感数据获取
- 构建策略:金融专家设计实时数据问题,通过 API 调用代码获取实时数据点,并根据实际市场数据验证结果。
- 数据来源:证券交易所、外汇市场、商品交易平台,以及 Bloomberg、Reuters 和 Yahoo Finance 等金融数据提供商。
简单历史查询
- 构建策略:覆盖历史市场数据、公司财务和宏观统计数据,直接从官方来源和专业金融数据库收集。
- 数据来源:公司文件(10-K、10-Q、8-K 报告)、监管网站(SEC、FINRA、交易所网站)、专业金融数据库(Bloomberg Terminal、Refinitiv)和央行出版物。
复杂历史调查
- 构建策略:涉及需要从多个历史数据点进行计算和推理的金融数据,通过专家设计的真实场景和已验证的数据库表创建问题。
- 数据来源:多数据源交叉验证,确保准确性和教育价值。
答案验证机制
采用盲审模块进行答案验证。金融专家独立解决问题,如有分歧由高级专家仲裁,确保问题或答案的修改或废弃。
关键发现
- 顶级模型表现挣扎:在时间敏感数据获取和简单历史查询任务中,顶级模型的平均准确率分别低于 60% 和 40%,在复杂历史调查任务中准确率暴跌至 20% 以下。
- 实时网络搜索必不可少:没有搜索工具的模型在时间敏感任务上得分为零,在历史数据搜索任务上得分极低。
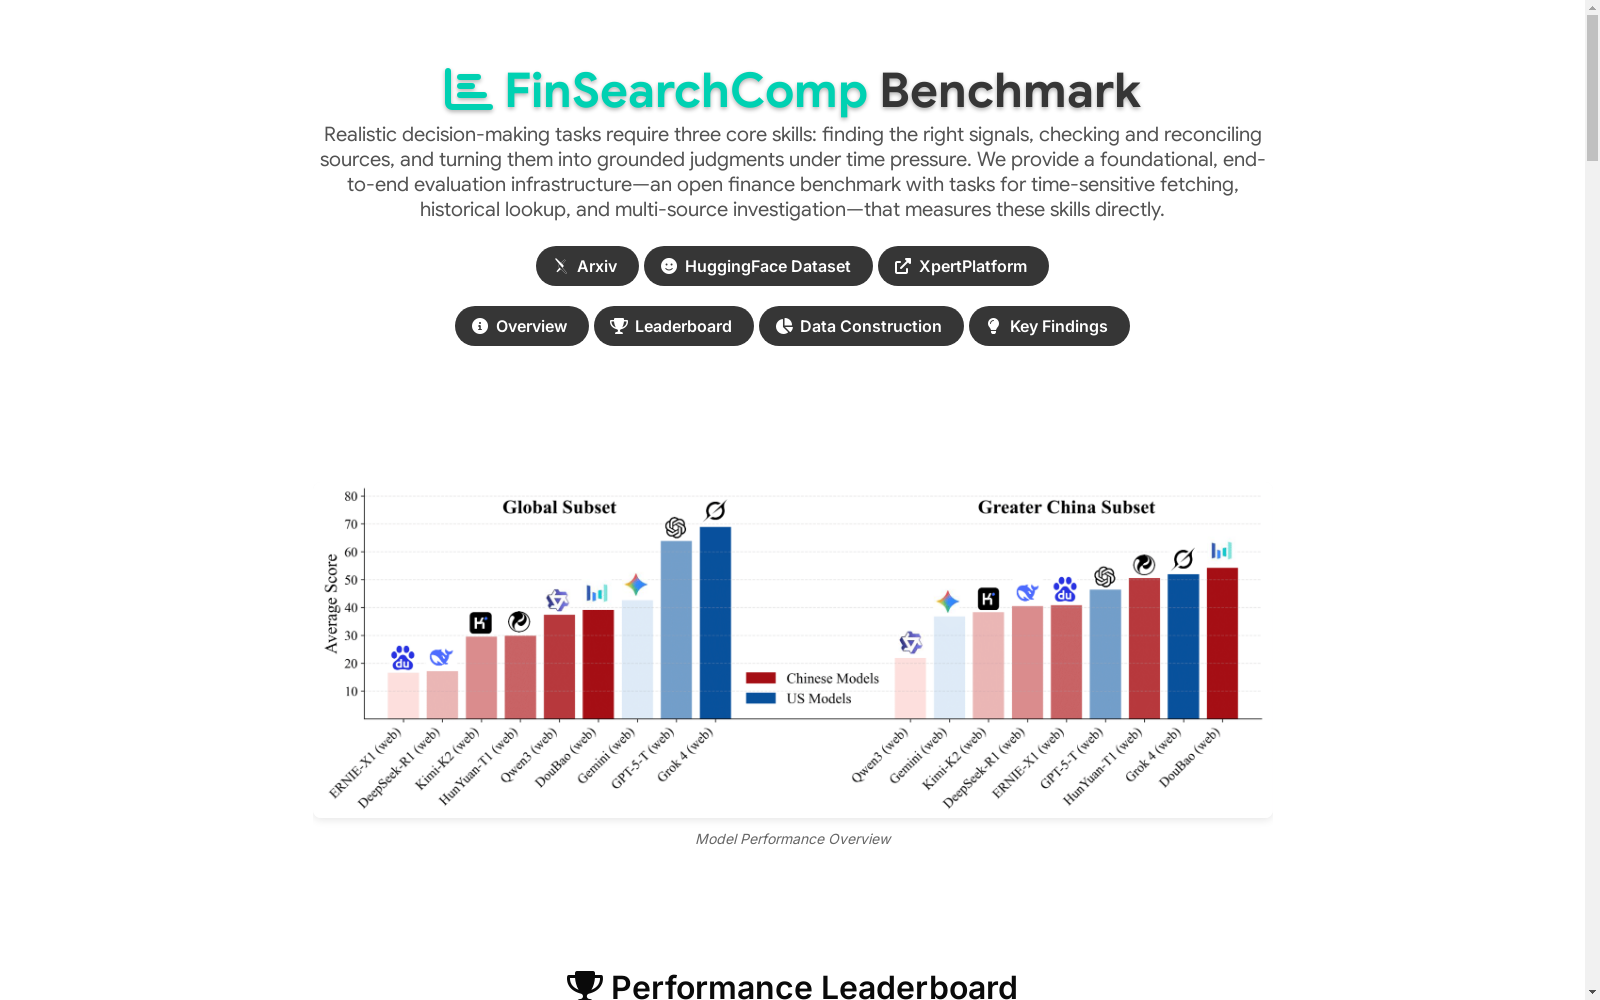
- 强烈的区域偏见影响性能:中国模型在大中华区市场查询上表现出色,但在全球市场问题上落后于国际同行。
数据集可用性
整个数据集和评估套件公开可用。