
opendatalab/MolRecBench-Wild
收藏官方服务:
资源简介:
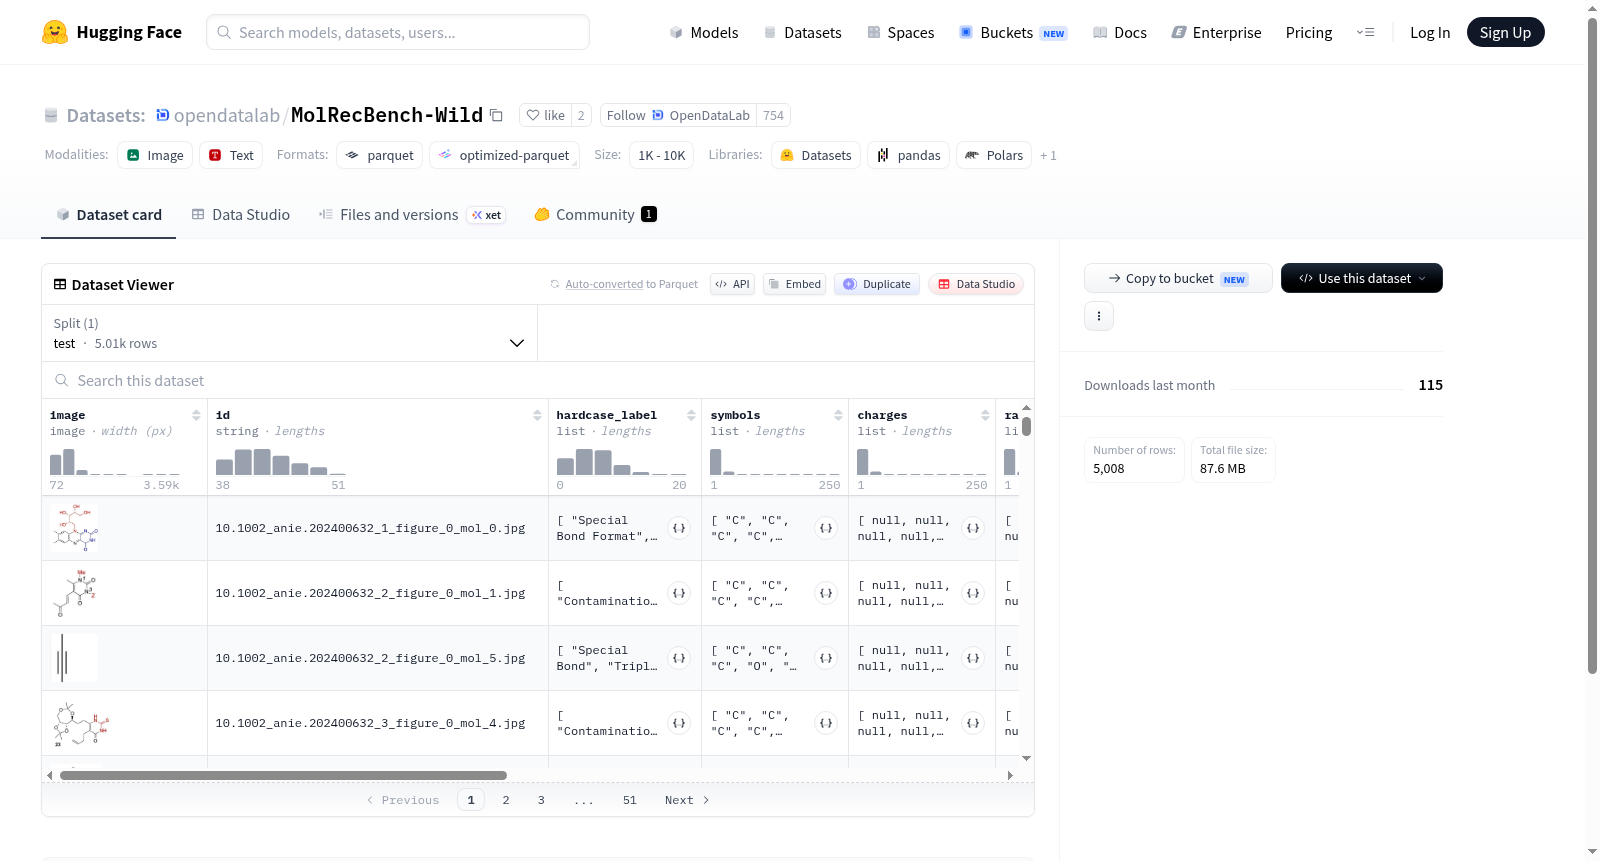
该数据集是一个化学分子结构数据集,包含图像和多种化学标注信息,适用于分子识别或化学信息学任务。数据特征包括分子图像、唯一标识符、硬壳标签、化学符号列表、电荷列表、自由基列表、化合价列表、同位素列表、连接点列表、原子坐标列表、化学键列表以及括号信息(包括别名、原子索引和显示矩形)。数据集仅包含测试集,共有5008个样本,文件大小约为86.8 MB。
This dataset is a chemical molecular structure dataset containing images and various chemical annotations, suitable for tasks such as molecular recognition or cheminformatics. Features include molecular images, unique identifiers, hardcase labels, lists of chemical symbols, charges, radicals, valences, isotopes, attachment points, atomic coordinates, chemical bonds, and bracket information (including aliases, atom indices, and display rectangles). The dataset only includes a test split with 5,008 samples and a file size of approximately 86.8 MB.
提供机构:
opendatalab搜集汇总
数据集介绍
构建方式
MolRecBench-Wild数据集精心构建于分子结构识别领域,旨在评估模型在真实世界复杂场景下的鲁棒性。该数据集整合了5008个测试样本,每个样本包含分子图像及丰富的结构化标注信息,涵盖符号、电荷、自由基、价态、同位素、连接点、原子坐标、化学键以及括号分组等关键属性。通过将分子结构拆解为多层次、多维度的细粒度标签,该数据集为模型性能评测提供了严密且全面的基准框架。
特点
该数据集的核心特点在于其高度复杂的标注体系与真实世界的噪声挑战。每个分子图像均附带丰富的结构化标签,包括原子坐标、键合关系以及括号组表示,极大增强了评测的细节粒度。尤为突出的是,数据集中专门引入了hardcase_label字段,用以标记高难度样本,这为研究者识别模型在复杂分子结构上的失败模式提供了宝贵线索,从而推动分子光学识别技术的边界突破。
使用方法
使用MolRecBench-Wild数据集时,研究者可直接通过HuggingFace接口加载测试集,加载后的数据包含高分辨率分子图像及对应的JSON格式标签信息。模型需从图像中预测符号、电荷、化合价等结构化分子属性,并通过与真实标注的比对来评估识别精度。建议研究者重点关注hardcase_label标识的疑难样本,以系统性地诊断模型在复杂分子结构识别中的薄弱环节,进而迭代优化识别算法。
背景与挑战
背景概述
MolRecBench-Wild是一个专注于分子结构识别领域的数据集,创建于近年,由相关研究人员或机构推出,旨在解决从化学图像中自动解析分子结构这一核心研究问题。该数据集包含5008个测试样本,每个样本涵盖图像、分子符号、电荷、自由基、化合价、同位素、附着点、坐标、化学键及括号信息。其构建背景源于化学信息学与计算机视觉的交叉领域,致力于推动光学分子结构识别(OMSR)技术的发展。MolRecBench-Wild的影响力在于为评估分子识别算法在真实世界复杂场景下的鲁棒性提供了标准化基准,促进了化学文档数字化和药物研发等领域的自动处理能力。
当前挑战
该数据集所解决的领域问题挑战在于分子结构图像的高变异性,包括手写、印刷、不同字体、噪声及部分遮挡等,导致传统光学字符识别方法难以准确解析。具体挑战包括:1) 处理复杂分子式中的嵌套括号、同位素标记及多中心连接点;2) 在图像质量参差时精准提取原子坐标与化学键拓扑关系;3) 区分结构异构体与相似官能团,避免符号误读。构建过程中的挑战涉及:1) 收集多样化来源(如论文、专利、笔记)的分子图像并保证标注一致性;2) 平衡硬例样本分布,涵盖稀有元素与复杂环系结构;3) 设计兼容多种分子表示格式(如SMILES与InChI)的标注体系,以支持评估标准的统一。
常用场景
经典使用场景
MolRecBench-Wild数据集专为化学分子结构识别任务而设计,其核心应用场景是评估和训练深度学习模型对化学结构式图像的解析能力。该数据集包含了5008个精心标注的样本,每个样本不仅提供分子结构图像,还涵盖了分子符号、电荷数、基团信息、化合价、同位素标记、连接点坐标、化学键类型及括号结构等丰富标注。这些多维度的标注信息使得该数据集成为检验模型在复杂化学结构理解与重建方面的理想基准,尤其适合用于端到端的分子识别系统开发与性能评测。
解决学术问题
该数据集有效解决了化学信息学中一个关键学术难题——从二维化学结构图像中自动、准确地提取结构化分子信息。传统的光学字符识别(OCR)方法在处理化学结构式时,常因符号重叠、复杂键型、立体化学构型等挑战而表现不佳。MolRecBench-Wild通过提供包含多种硬例(hardcase_label)的高质量标注数据,为研究者提供了系统评估模型在分子符号识别、结构拓扑重建、原子空间定位等方面的性能指标,推动了化学文献数字化、化学数据库自动构建等基础研究问题的进展。
衍生相关工作
基于MolRecBench-Wild数据集,学术界已衍生出多项经典研究工作。其中包括针对分子结构图像的端到端识别模型,如结合图神经网络与Transformer架构的分子解析器;面向硬例样本的鲁棒性提升方法,通过对抗训练或注意力机制增强识别效果;以及融合多模态信息的分子结构理解框架,将图像特征与文本描述相结合。这些工作不仅提升了分子识别的准确率,还拓展了数据集在化学结构搜索、分子属性预测等下游任务中的应用边界,形成了从识别到理解的完整研究脉络。
以上内容由遇见数据集搜集并总结生成


