
遇见数据集

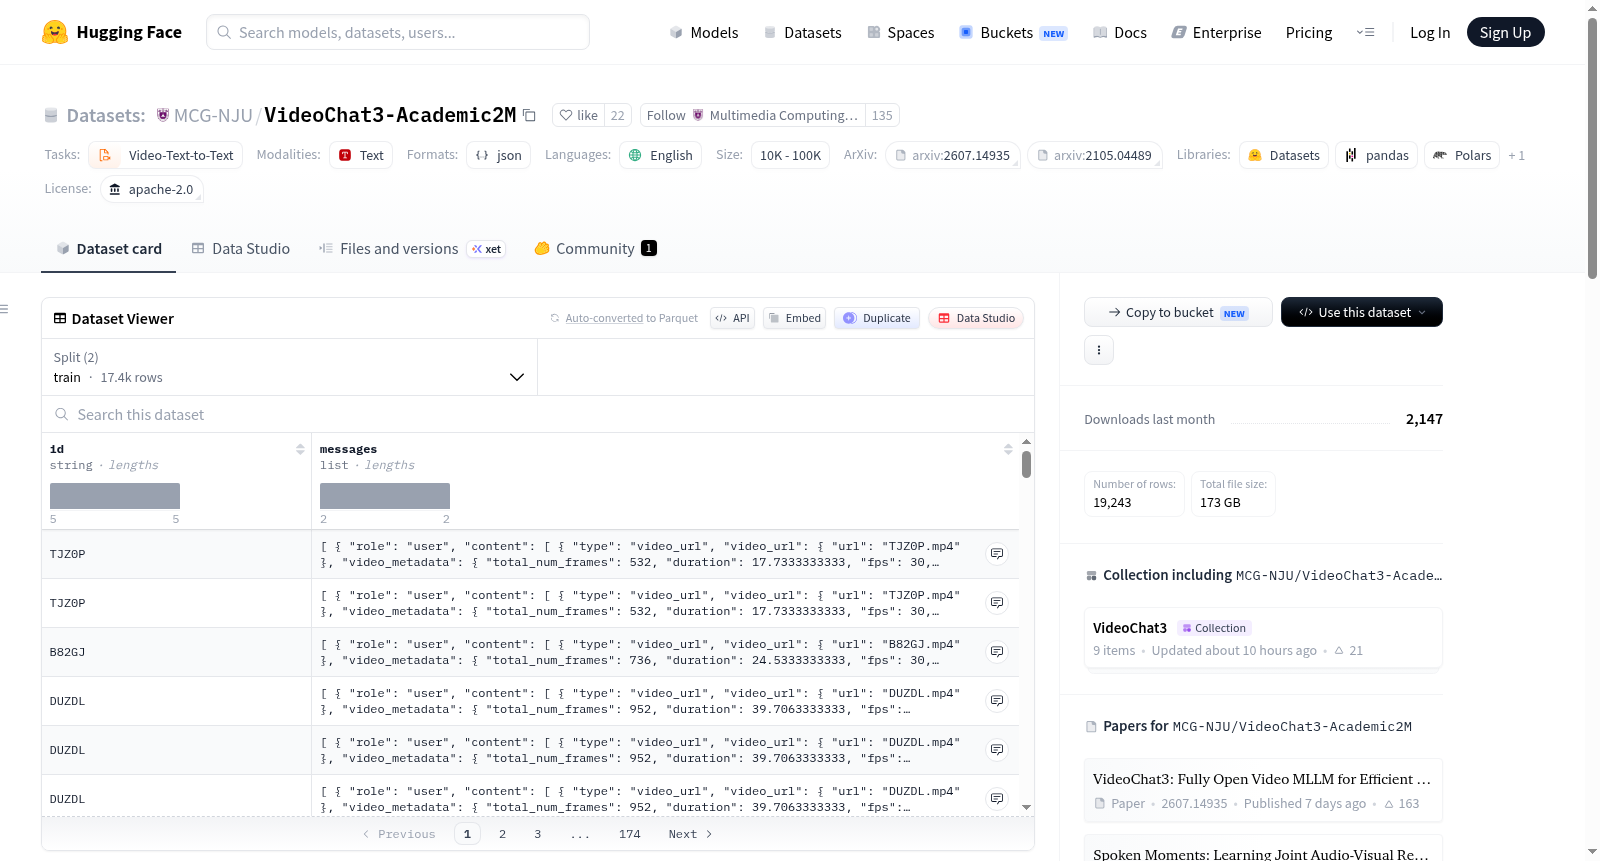
MCG-NJU/VideoChat3-Academic2M

收藏
Hugging Face2026-07-19 更新2026-07-22 收录
官方服务:

资源简介:

VideoChat3-Academic2M是VideoChat3使用的学术视频指令数据。它通过对公开学术视频数据集进行重新注释,用于视频字幕生成、视频问答和细粒度运动理解。该数据集遵循基于证据的注释增强流程,将简短答案、仅选项标签和简洁字幕重写为更丰富的指令跟随响应,这些响应提及可见对象、动作、场景、时间线索和支持证据。然后通过一致性过滤阶段,确保重写注释与原始学术标签保持一致。

VideoChat3-Academic2M is the academic video instruction data used by VideoChat3. It re-annotates public academic video datasets for video captioning, video question answering, and fine-grained motion understanding. The dataset follows an evidence-grounded annotation enhancement pipeline. Short answers, option-only labels, and concise captions are rewritten into richer instruction-following responses that mention visible objects, actions, scenes, temporal cues, and supporting evidence. A consistency filtering stage is then used to keep rewritten annotations aligned with the original academic labels.
提供机构:
MCG-NJU
搜集汇总
数据集介绍
MCG-NJU/VideoChat3-Academic2M 数据集图片
构建方式
VideoChat3-Academic2M是一个为视频理解领域打造的学术型指令微调数据集,其构建依托于一种基于证据的注释增强管线。该数据集对现有的公开学术视频数据集中的视频字幕、视频问答以及细粒度动作理解等任务标注进行了重新注释。具体而言,原始数据中简短的答案、仅包含选项的标签以及简洁的描述被改写为更丰富的指令跟随式回复,这些回复不仅提及可见物体、动作、场景和时间线索,还融入了支撑性证据。随后,通过一致性过滤阶段,确保改写后的注释与原始学术标签保持对齐,从而提升数据质量。该数据集不直接提供原始视频文件,用户需根据提供的原始数据集路径自行获取视频资源。
特点
VideoChat3-Academic2M的一大显著特点在于其高度的综合性与精细化。它聚合了LLaVA-Video、Spoken-MIT、Vript、StarQA、Sports-QA和Perception-Test等多个来源的视频标注,覆盖了从通用视频描述到专业领域问答的广泛场景。通过证据驱动的增强策略,数据集的每条注释都力求提供比原始标注更详尽、更具上下文关联性的信息,例如明确指示支持答案的视觉证据,从而提升了模型对视频内容进行推理和解释的能力。此外,该数据集专注于学术研究,其2M级别的规模为训练高效且通用的视频多模态大模型奠定了坚实的数据基础。
使用方法
使用VideoChat3-Academic2M数据集时,研究人员首先需要从其HuggingFace仓库下载JSONL格式的注释文件。这些文件包含每个视频样本的指令及其对应的增强后响应。由于数据集本身不托管视频,用户需要根据注释文件中指定的原始数据集路径,如LLaVA-Video、Vript等来源,自行下载对应的视频文件,并可以参考提供的‘acadmic2M.json’映射文件来组织数据目录结构。完成视频资源与注释的配对后,即可按照标准的视频到文本多模态模型训练流程,将视频帧序列和指令文本输入模型进行训练或评估,以实现视频字幕、问答及动作理解等下游任务。
背景与挑战
背景概述
VideoChat3-Academic2M数据集由南京大学MCG-NJU团队于2025年创建,旨在推动视频多模态大语言模型(Video MLLM)的发展。该数据集通过重新标注LLaVA-Video、Spoken-MIT、Vript等公开学术视频数据集,构建了涵盖视频描述、视频问答及细粒度运动理解等任务的高质量指令数据。其核心研究问题在于如何利用证据增强的标注流程,将短答案、选项标签和简洁描述转化为包含可见物体、动作、场景、时间线索及支持证据的丰富指令-响应对,从而提升模型对视频内容的深入理解能力。作为VideoChat3项目的关键组件,该数据集为开放视频理解研究提供了标准化训练资源,对视频MLLM领域的高效训练与泛化性能评估具有重要影响。
当前挑战
该数据集面临的挑战首先体现在领域问题的复杂性:视频理解需同时处理时空维度上的动态内容,与图像理解相比,视频中物体交互、事件因果推理及长时间跨度依赖为模型带来更大难度。在构建过程中,主要挑战包括多源数据异构性整合——不同数据集标注格式、粒度及语义范围差异显著,需设计统一增强标注模板;证据增强流程需保证重写后的指令与原标注标签的语义一致性,避免信息失真;视频来源分散且版权限制严格,数据集中仅提供JSONL标注文件而不含原始视频,用户需自行从原数据集路径获取视频,增加了使用门槛与数据交叉比对难度。
常用场景
经典使用场景
VideoChat3-Academic2M作为视频多模态大模型领域的高质量指令微调数据集,其经典使用场景聚焦于视频理解模型的训练与评估。该数据集汇聚了来自LLaVA-Video、Sports-QA等六个公开学术视频数据集的标注资源,通过精细化的证据驱动增强流水线,将原本简短的答案、选项式标签和简洁描述重构为富含上下文信息的指令遵循型响应。研究者利用该数据训练模型以执行视频描述、视频问答以及细粒度运动感知等任务,借助其标注中明确引用的可见物体、动作、场景与时间线索,显著提升了模型对视频内容的深度理解能力。
实际应用
在工业级应用中,VideoChat3-Academic2M可支撑智能视频监控、辅助驾驶场景分析、在线教育内容审核和体育赛事自动解说等领域的模型开发。例如,借助该数据集训练的视频问答系统,能够快速提取监控视频中的关键事件并生成结构化报告;在体育视频分析中,模型可依据运动动作与时间线索自动生成精准的比赛摘要。此外,面向视障人士的视频辅助工具也可利用该数据微调模型,实现从视频中实时提取环境描述与行为信息,提升日常生活场景的可达性。
衍生相关工作
VideoChat3-Academic2M的出现催生了一系列围绕证据驱动视频理解的研究工作。一方面,多篇工作借鉴其增强流水线,将证据基础与视觉推理任务相结合,拓展了视频语义对齐与细粒度知识提取的方向;另一方面,该数据集的标注范式和一致性过滤方法被后续研究引入,用于构建更大规模、更高质量的指令数据集,如衍生出面向长视频、开放域问答的专用工具集。此外,部分学术工作以其为基准,探索模型在复杂视频场景下的时空推理能力,推动了视频多模态评估指标向更精细、更可信的方向演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

