Physics-Chemistry-Mathematics-Pro
收藏资源简介:
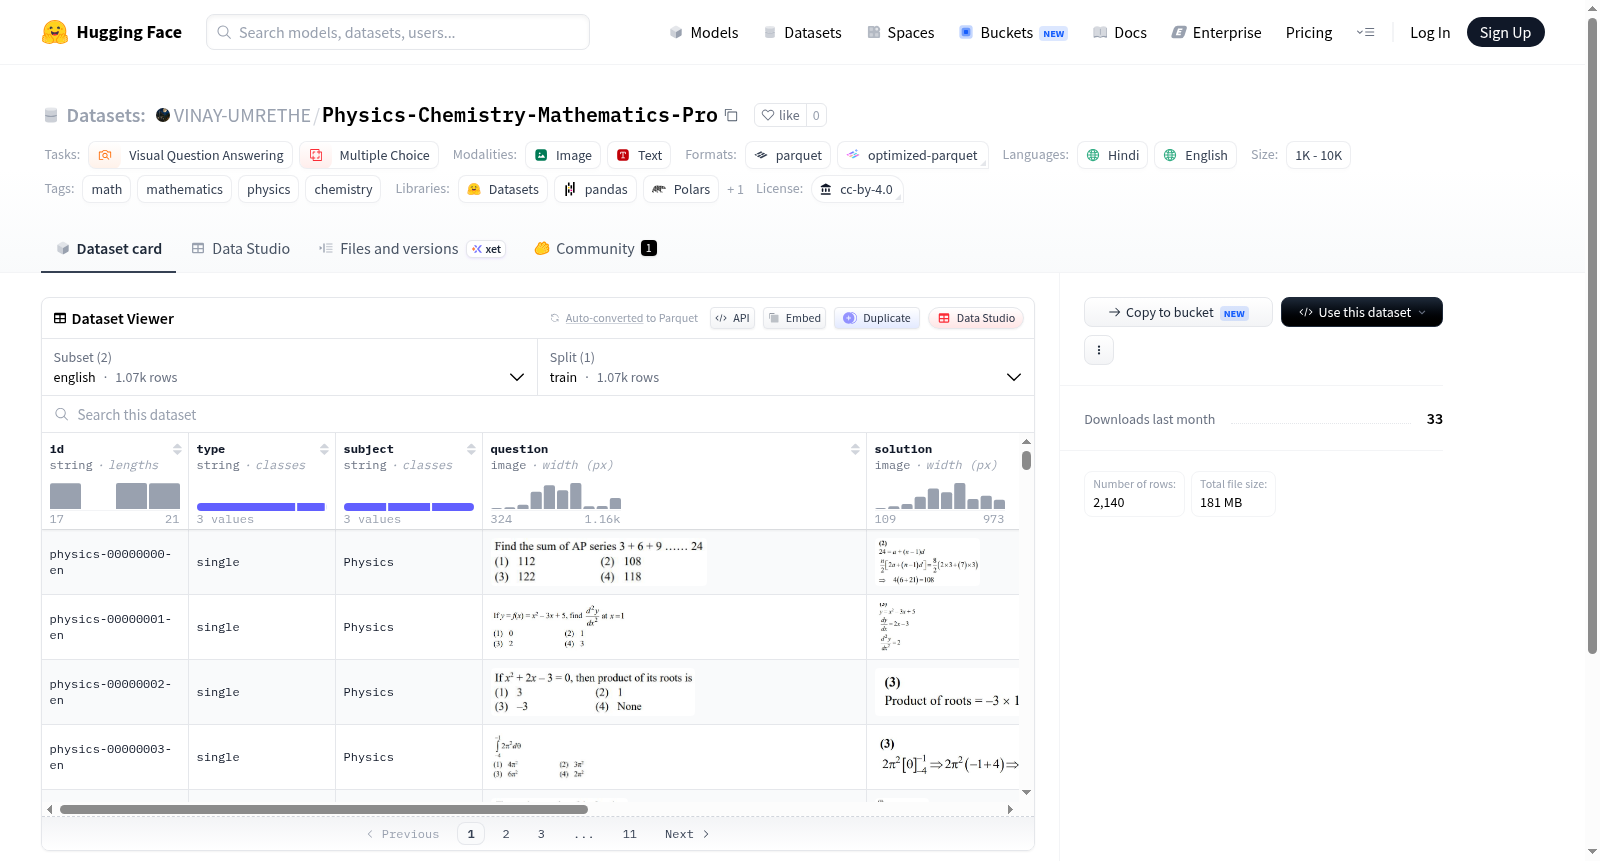
该数据集是一个多模态科学教育数据集,包含英语和印地语两个语言版本,专门设计用于视觉问答和多项选择任务。它涵盖数学、物理和化学等学科领域,每个数据样本包含以图像形式呈现的问题和解答过程,以及文本形式的选项列表和答案。数据集还提供了丰富的元数据,包括问题类型、学科主题、难度等级以及详细的话题和子话题分类。英语版本包含1070个训练样本,印地语版本同样包含1070个训练样本,两个版本具有相同的特征结构。该数据集适用于教育技术研究、多模态学习系统开发以及跨语言科学问题解答模型的训练与评估。
This dataset is a multimodal science education dataset available in both English and Hindi versions. It is specifically designed for visual question answering and multiple-choice tasks, covering subjects such as mathematics, physics, and chemistry. Each data sample includes a question and solution process presented in image form, along with a list of options and answers in text form. The dataset also provides rich metadata, including question type, subject topic, difficulty level, and detailed topic and subtopic classifications. The English version contains 1070 training samples, and the Hindi version also contains 1070 training samples, both with identical feature structures. This dataset is suitable for educational technology research, development of multimodal learning systems, and training and evaluation of cross-language scientific question-answering models.
数据集概述
数据集名称:Physics-Chemistry-Mathematics-Pro
数据集地址:https://huggingface.co/datasets/VINAY-UMRETHE/Physics-Chemistry-Mathematics-Pro
许可协议:Creative Commons Attribution 4.0 International (CC-BY-4.0)
任务类别:视觉问答、多项选择
语言:印地语 (hi)、英语 (en)
标签:数学、物理学、化学
数据规模:样本数量在 1K 到 10K 之间
数据集配置
该数据集包含两个子配置:
-
英语 (english)
- 训练集:1070 个样本,大小约 89.4 MB
- 数据文件路径:
data/english/train-* - 是否为默认配置:是
-
印地语 (hindi)
- 训练集:1070 个样本,大小约 93.1 MB
- 数据文件路径:
data/hindi/train-* - 是否为默认配置:否
数据特征
每个样本包含以下字段:
| 字段名 | 数据类型 | 描述 |
|---|---|---|
| id | 字符串 | 样本唯一标识符 |
| type | 字符串 | 问题类型 |
| subject | 字符串 | 学科(如数学、物理、化学) |
| question | 图像 | 问题内容 |
| solution | 图像 | 解答内容 |
| options | 字符串列表 | 选项列表 |
| answer | 字符串列表 | 正确答案列表 |
| difficulty | 整数 (int8) | 难度等级 |
| metadata | 结构体 | 元数据,包含语言、主题、子主题 |
元数据结构
metadata 字段包含以下子字段:
- language (字符串):语言
- topic (字符串):主题
- subtopic (字符串):子主题