Fable-5-Distill-5500x
收藏资源简介:
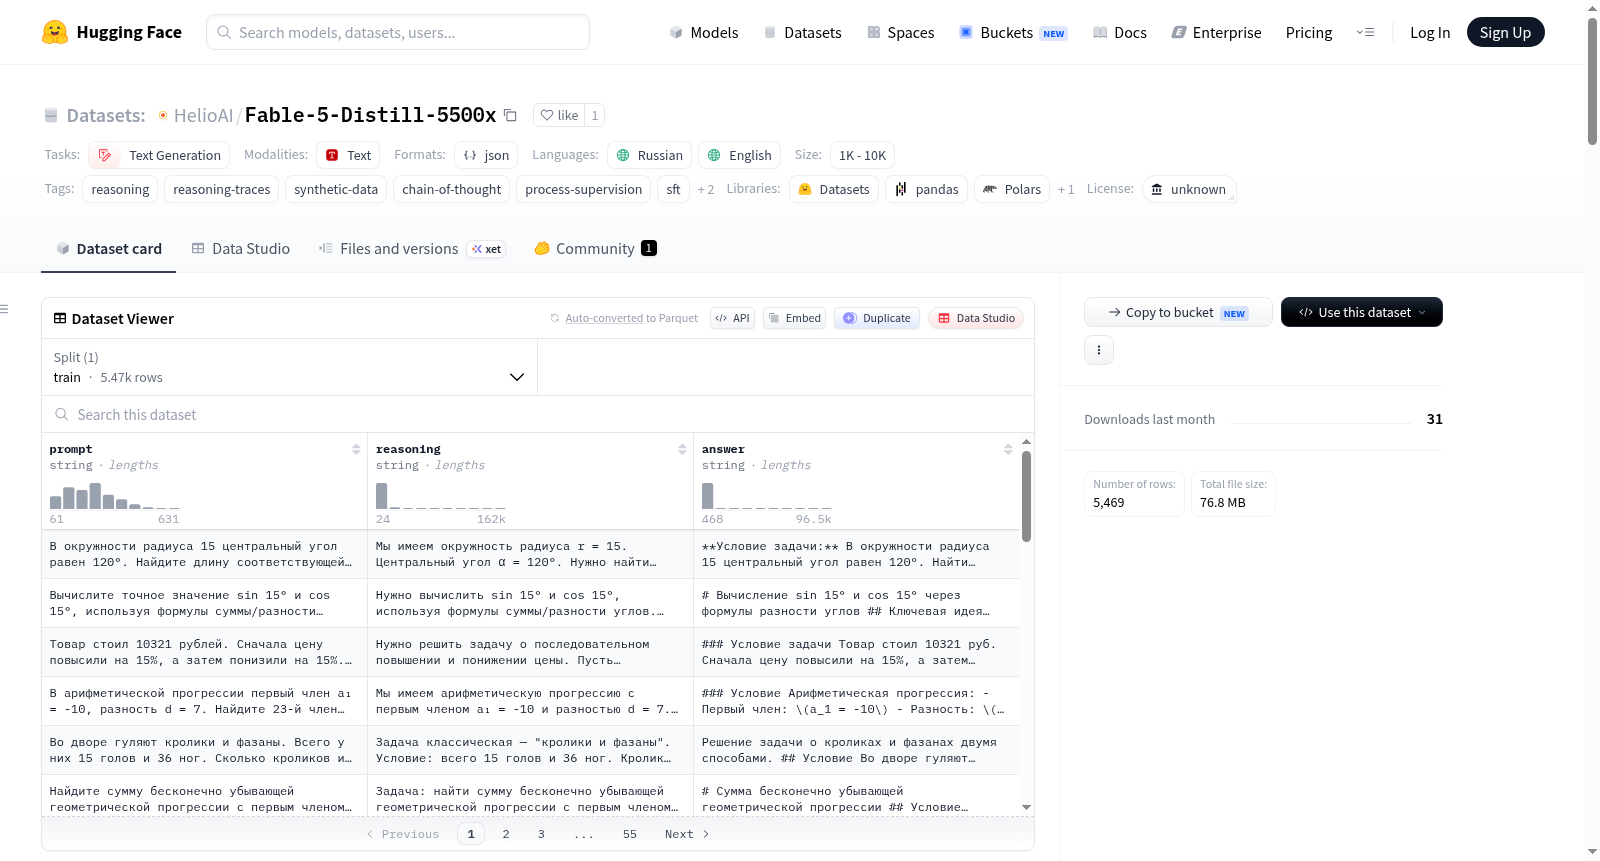
Fable 5 Reasoning 5.4K 是一个高质量、机器生成的合成数据集,专门用于增强语言模型推理能力的研究与训练。该数据集包含 5,469 个结构化的推理示例,每个示例均由 Fable 5 模型生成,并严格遵循“提示-推理-答案”的三元组格式。所有数据均经过清理,移除了系统提示、对话格式重复项和模板内容,形成了一个简洁、一致且可直接用于训练的数据集。数据集的核心特点是其深度、多语言的推理轨迹,推理链长度最长可达 161,847 个字符,适用于长上下文和过程监督实验。语料库平衡覆盖了俄语和英语,支持多语言推理研究。数据以 JSONL 格式提供,与 Hugging Face Datasets、TRL 和标准的监督微调(SFT)流程无缝兼容。主要应用场景包括监督微调、过程监督、长上下文推理基准测试、大规模推理模式分析以及快速建立基线。每个数据样本包含三个字段:`prompt`、`reasoning` 和 `answer`。数据集总字符数约为 5400 万,推理部分平均长度约 7200 字符。需要注意的是,所有数据均为合成生成,可能包含逻辑不一致、未经验证的假设、次优推理路径或事实错误,建议在使用前进行过滤和人工验证,并核实合规性。
Fable 5 Reasoning 5.4K is a high-quality, machine-generated synthetic dataset specifically designed for research and training to enhance language model reasoning capabilities. The dataset contains 5,469 structured reasoning examples, each generated by the Fable 5 model and strictly following a prompt-reasoning-answer triplet format. All data has been cleaned by removing system prompts, dialogue format duplicates, and template content, resulting in a concise, consistent dataset ready for direct training. Its core features include deep, multilingual reasoning traces, with reasoning chains up to 161,847 characters in length, suitable for long-context and process supervision experiments. The corpus balances coverage of Russian and English, supporting multilingual reasoning research. Data is provided in JSONL format, seamlessly compatible with Hugging Face Datasets, TRL, and standard supervised fine-tuning (SFT) pipelines. Key application scenarios include supervised fine-tuning, process supervision, long-context reasoning benchmarking, large-scale reasoning pattern analysis, and rapid baseline establishment for enhanced reasoning systems. Each data sample consists of three fields: `prompt`, `reasoning`, and `answer`. The total character count is approximately 54 million, with the reasoning portion averaging about 7,200 characters. Note that all data is synthetically generated and may contain logical inconsistencies, unverified assumptions, suboptimal reasoning paths, or factual errors; filtering and human verification are recommended before use in high-risk training or production systems, and compliance should be verified for commercial use, redistribution, or training derivative models.
数据集概述
Fable 5 Reasoning Dataset 是一个高质量的合成推理数据集,专用于监督式微调(SFT)和过程监督(Process Supervision)研究。数据集由 Fable 5 模型生成,包含 5,469 个结构化的推理示例,每个样本以 "提示 (prompt)"、"推理过程 (reasoning)" 和 "最终答案 (answer)" 三元组形式呈现。
关键特点
- 深度推理链:推理链长度可达 161,847 字符,适用于长上下文和过程监督实验。
- 双语语料:覆盖俄语和英语,支持多语言推理研究。
- 清洁一致:经过去重、去除系统提示和聊天格式,格式统一为 JSONL。
- 开箱即用:可直接集成 Hugging Face Datasets、TRL 及标准 SFT 流水线。
数据规模与统计
| 指标 | 数值 |
|---|---|
| 总样本数 | 5,469 |
| 提示(Prompt)字符数 | 1.32 M |
| 推理(Reasoning)字符数 | 39.61 M |
| 答案(Answer)字符数 | 13.08 M |
| 总字符数 | 54.01 M |
| 最大推理长度 | 161,847 字符 |
| 平均推理长度 | ~7,200 字符 |
| 语言 | 俄语、英语 |
| 来源模型 | Fable 5 |
数据格式 (JSONL)
每个样本包含三个字段:
json { "prompt": "用户任务或问题", "reasoning": "Fable 5 生成的完整思维链", "answer": "最终简洁回答" }
预期用途
- 监督式微调 (SFT):训练模型在给出最终答案前生成结构化推理。
- 过程监督 (Process Supervision):奖励中间推理步骤,而非仅最终输出。
- 长上下文推理 (Long-Context Reasoning):评测模型在长思维链上的表现。
- 推理分析 (Reasoning Analysis):大规模研究推理模式、失败模式与推理质量。
- 基线开发 (Baseline Development):快速为推理增强系统建立基准。
局限与注意事项
- 所有样本均由机器生成,可能存在逻辑不一致、未经验证的假设、次优推理路径或事实不准确等问题。
- 建议在用于生产系统或高风险训练前,进行过滤和人工验证。
- 底层源材料的许可证未知,用户在商业使用、再分发或派生模型训练前需自行核实合规性。
引用方法
bibtex @dataset{fable5_reasoning_dataset_5k, title = {Fable 5 Reasoning Dataset 5.4K}, author = {Dataset Maintainers}, year = {2026}, publisher = {Hugging Face}, note = {Synthetic reasoning dataset structured as prompt-reasoning-answer triples} }