
HalluTruthQA-4K
收藏资源简介:
HalluTruthQA-4K是由多国研究机构联合构建的细粒度阿拉伯语幻觉检测与事实验证语料库,包含4000个问答实例,均衡覆盖伊斯兰知识、历史、科学和地理四个知识密集型领域。每个实例均包含阿拉伯语问题、模型生成回答、验证参考答案、二元幻觉标签及六选一候选答案集,其中1643个幻觉回答附有字符级错误跨度、人工解释与层次化幻觉类型。语料通过专家问题筛选、受控生成、人工标注与独立验证等严谨流程构建,支持响应级检测、错误定位、解释生成与事实验证等多任务评估,旨在解决阿拉伯语大模型在知识问答中的细粒度可靠性评估难题。
HalluTruthQA-4K is a fine-grained Arabic hallucination detection and fact verification corpus jointly constructed by multiple national research institutions. It includes 4,000 question-answering instances that evenly cover four knowledge-intensive domains: Islamic knowledge, history, science, and geography. Each instance contains an Arabic question, a model-generated response, a verified reference answer, a binary hallucination label, and a six-option candidate answer set. Among these, 1,643 hallucinatory responses are accompanied by character-level error spans, human explanations, and hierarchical hallucination categories. The corpus is built through rigorous workflows including expert-based question screening, controlled generation, manual annotation and independent verification. It supports multi-task evaluation such as response-level detection, error localization, explanation generation and fact verification, aiming to address the challenge of fine-grained reliability assessment for knowledge-based question answering of Arabic large language models.
HalluTruthQA-4K 数据集概述
基本信息
- 数据集名称:HalluTruthQA-4K
- 语言:阿拉伯语(
ar) - 许可证:CC BY-NC-ND 4.0
- 数据集规模:1K < n < 10K(完整语料 4,000 条)
- 任务类别:文本分类、问答、多项选择
- 标签:阿拉伯语、幻觉检测、伊斯兰研究、问答、HalluScoring-2026
- 发布背景:这是 HalluScoring 2026 共享任务(ArabicNLP 2026)中 子任务 2.2(“幻觉检测与寻找真相”) 的官方数据发布,扩展自基础基准 HalluTruthQA(从 2,400 条扩展到 4,000 条专家标注的阿拉伯语问答实例)。
数据集内容
- 完整语料包含 4,000 条阿拉伯语问答实例,在四个知识密集型领域各 1,000 条,完全平衡:伊斯兰研究、历史、科学、地理。
- 每个实例包含:
- 二元幻觉标签(
hallucination/no_hallucination) - 六选一多项选择改写(选项
A–F,其中有一个经核实的正确答案)
- 二元幻觉标签(
- 在完整语料的 1,643 条幻觉实例中,1,626 条额外带有至少一个字符级别的错误片段(共 1,843 个片段),每个片段附有人工撰写的错误原因解释。
数据划分
| 划分 | 伊斯兰研究 | 历史 | 科学 | 地理 | 总计 | 是否已发布 |
|---|---|---|---|---|---|---|
| train | 400 | 400 | 400 | 400 | 1,600 | ✅ 是 |
| dev | 200 | 200 | 200 | 200 | 800 | ✅ 是 |
| test | 400 | 400 | 400 | 400 | 1,600 | ⏳ 暂未发布(竞赛结束后补充) |
| 完整语料 | 1,000 | 1,000 | 1,000 | 1,000 | 4,000 | — |
- 完整 4,000 条语料的标签分布:2,357 条
no_hallucination(58.9%)、1,643 条hallucination(41.1%)。 - 当前发布的 train+dev 共 2,400 条中:1,387 条
no_hallucination(57.8%)、1,013 条hallucination(42.2%)。
数据字段
每个记录包含以下字段:
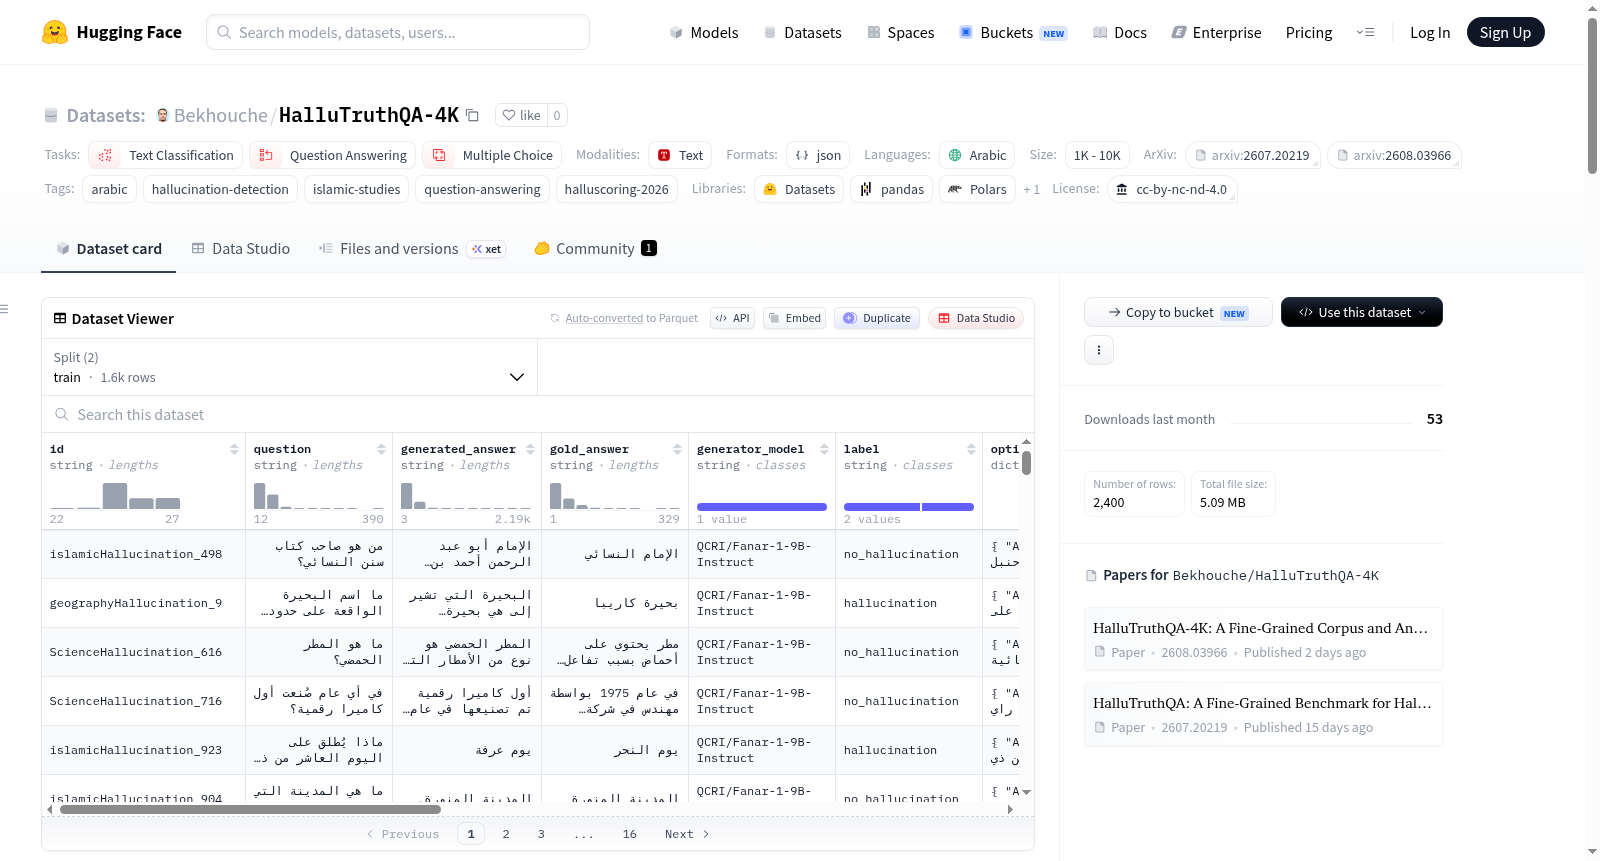
| 字段 | 类型 | 描述 |
|---|---|---|
id |
字符串 | 唯一实例标识符(编码了主题,例如 islamicHallucination_498) |
question |
字符串 | 阿拉伯语问题 |
generated_answer |
字符串 | 被评估的模型生成的自由文本答案 |
gold_answer |
字符串 | 经人工核实的参考答案 |
generator_model |
字符串 | 生成 generated_answer 的模型 |
label |
字符串 | "hallucination" 或 "no_hallucination" |
options |
对象 | 六个候选答案,键为 "A"–"F",其中一个与 gold_answer 匹配 |
answer |
字符串 | 正确选项的字母("A"–"F") |
对于幻觉实例,大多数记录还额外包含:
| 字段 | 类型 | 描述 |
|---|---|---|
hallucinations |
对象列表 | 每个错误片段对应一条记录,包含 span_start、span_end(在 generated_answer 中的字符偏移量)、hallucinated_span(错误文本)和 explanation(错误原因) |
少量记录还带有可选元数据字段,仅部分实例存在:split、historical_note、quality_note、data_note 和 truncated。另外两个字段 level(难度标签)和 gold_match("exact" 或 "semantic")仅在暂未发布的 test 划分中填充,因此在当前 train+dev 发布中始终为空。
支持的任务
- 幻觉检测 — 二元分类,判断生成的答案是否可靠。
- 寻找真相 — 在六个多项选择候选中选出事实正确的选项(与检测结果无关)。
- (针对带有片段的子集)错误内容的片段级定位与解释。
数据来源与生成
- 所有生成的答案均来自同一个模型:Fanar-1-9B-Instruct,以隔离单一阿拉伯语生成器的错误特征,避免不同模型家族带来的混杂因素。
- 数据重用基础 HalluTruthQA 语料的标注协议(领域专家标注、训练评审员独立验证、专家裁决分歧),未做修改。
附加资源
- 共享任务页面:https://www.codabench.org/competitions/16390/
- 基础基准、指南、生成/干扰项构建提示和评估脚本:https://gitlab.com/nlpresearcher/HalluTruthQA
- 1HalluTruthQA-4K: A Fine-Grained Corpus and Annotation Process for Arabic Hallucination Detection and Truth Verification巴斯克大学; 哈马德·本·哈利法大学; 比斯克拉大学; 马来西亚吉兰丹大学 · 2026年


