
遇见数据集

musnad-letter-classification

收藏
Hugging Face2026-06-06 更新2026-06-07 收录
官方服务:

资源简介:

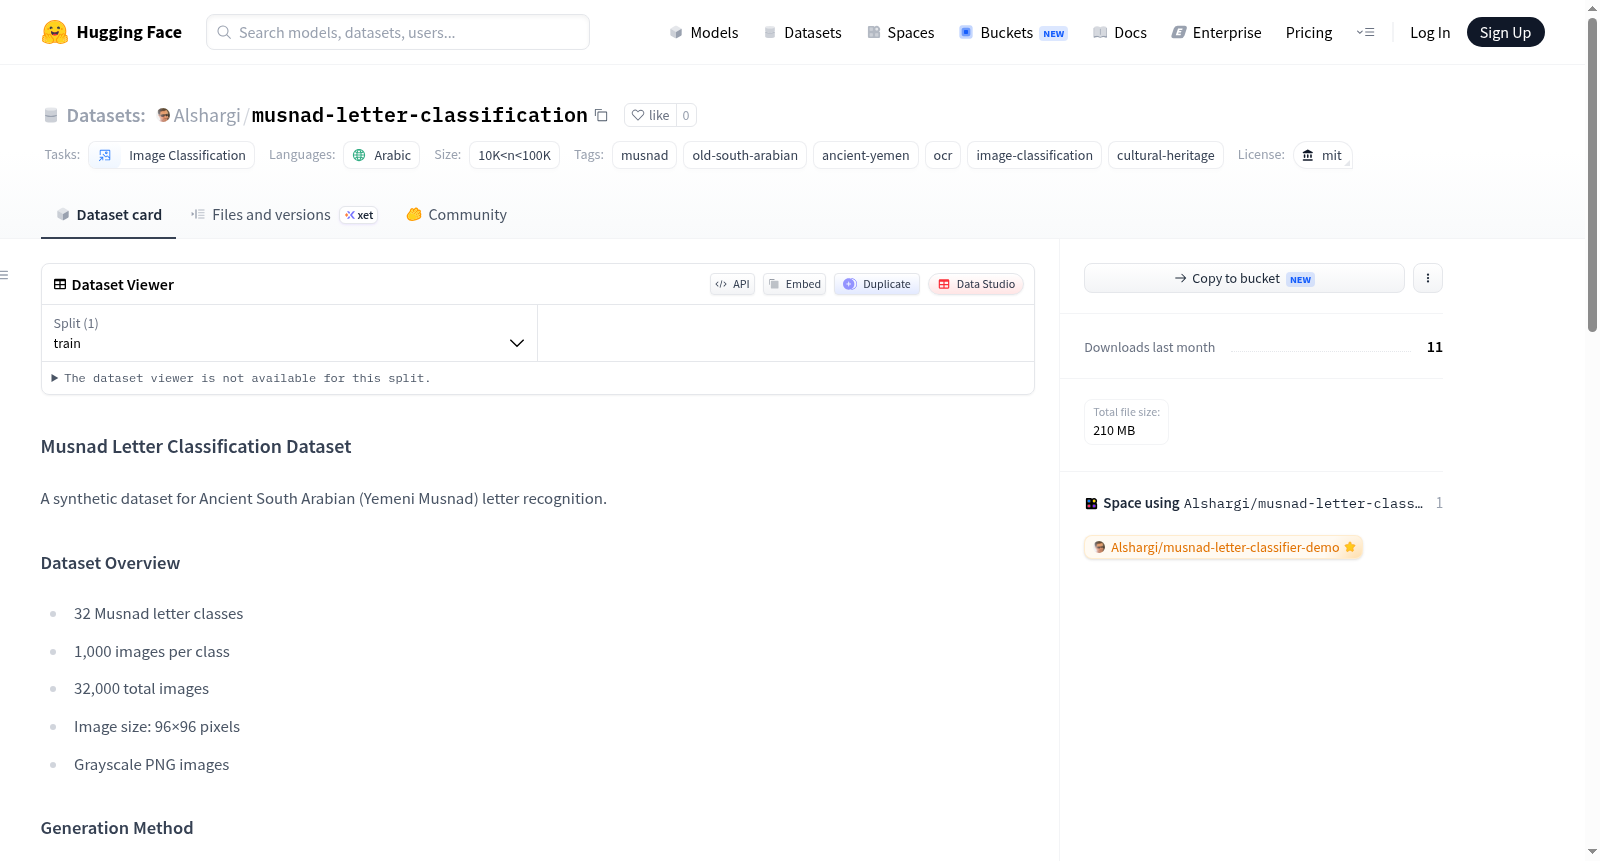
Musnad字母分类数据集是一个用于古南阿拉伯语(也门Musnad)字母识别的合成图像数据集,专为图像分类任务设计。它包含32个不同的Musnad字母类别,每个类别提供1,000张图像,总计32,000张图像。所有图像均为96×96像素的灰度PNG格式。数据集通过使用Noto Sans Old South Arabian字体渲染Unicode Musnad字符生成,并应用了多种数据增强技术以提高模型鲁棒性,包括旋转、平移、高斯模糊、噪声注入、字体大小变化和笔画粗细变化。预期应用场景涵盖Musnad光学字符识别(OCR)研究、古文字识别、图像分类模型开发、文化遗产人工智能项目以及低资源语言技术探索。需要注意的是,该数据集为合成数据,不包含真实石刻铭文中的雕刻变化、风化效果、光照条件或考古文物特征,因此在实际应用时需考虑其与真实场景的差异。基准实验表明,使用该数据集训练的卷积神经网络在验证集上取得了超过99.8%的准确率。

The Musnad Alphabet Classification Dataset is a synthetic image dataset for ancient South Arabian (Yemeni Musnad) alphabet recognition. It is designed for image classification tasks and includes 32 different Musnad letter categories, with 1,000 images per category, totaling 32,000 images. All images are in 96×96 pixel grayscale PNG format. The dataset is generated by rendering Unicode Musnad characters using the Noto Sans Old South Arabian font and applies various data augmentation techniques to enhance model robustness, including rotation, translation, Gaussian blur, noise injection, font size variation, and stroke thickness variation. Intended applications include Musnad optical character recognition (OCR) research, ancient script recognition, image classification model development, cultural heritage AI projects, and low-resource language technology exploration. It is important to note that this dataset is synthetic and does not include real-world variations such as carving effects, weathering, lighting conditions, or archaeological artifact features, so differences from real-world scenarios should be considered in practical use. Benchmark experiments show that convolutional neural networks trained on this dataset achieve over 99.8% accuracy on the validation set.

创建时间:
2026-06-06
原始信息汇总

数据集名称

Musnad 字母分类数据集(Musnad Letter Classification Dataset)

数据集概述

  • 任务类型:图像分类
  • 语言:阿拉伯语
  • 类别数:32 个 Musnad 字母类别
  • 图像总数:32,000 张
  • 每类图像数:1,000 张
  • 图像尺寸:96×96 像素
  • 图像格式:灰度 PNG 图像

数据生成方法

  • 使用 Unicode Musnad 字符,以 Noto Sans Old South Arabian 字体渲染生成。
  • 数据增强技术包括:
    • 旋转
    • 平移
    • 高斯模糊
    • 噪声注入
    • 字体大小变化
    • 笔画粗细变化

基线 CNN 结果

  • 类别数:32
  • 总图像数:32,000
  • 训练图像数:25,600
  • 验证图像数:6,400
  • 图像尺寸:96×96 灰度
  • 最佳验证准确率:99.87%
  • 最终验证准确率:99.84%

预期用途

  • Musnad OCR 研究
  • 古文字识别
  • 图像分类
  • 文化遗产人工智能
  • 低资源语言技术

局限性

该数据集为合成数据集,不代表真实的石刻铭文、雕刻变化、风化、光照条件或考古文物。
搜集汇总
数据集介绍
musnad-letter-classification 数据集图片
构建方式
该数据集专为古代南阿拉伯文字(也门Musnad字母)的识别任务而设计,采用合成生成的方式构建。研究者利用Unicode Musnad字符,借助Noto Sans Old South Arabian字体进行渲染,生成原始图像。随后,通过一系列数据增强技术——包括旋转、平移、高斯模糊、噪声注入、字体大小与笔画粗细变化——显著提升了样本的多样性与鲁棒性。最终构建出包含32个字母类别、每类1000张图像,总计32000张96×96像素的灰度PNG图片的高质量数据集。
特点
该数据集最大的特点在于其结构严谨且富有代表性。类别涵盖完整的32个Musnad字母,每类样本数量均衡,便于模型公平训练。图像尺寸统一为96×96像素,采用灰度格式,既保留关键字形特征,又降低了计算开销。基于合成方式生成,避免了真实石刻中因风化、光照等不可控因素带来的噪声干扰,为古代文字识别研究提供了清晰、稳定的基准。此外,基线CNN实验高达99.87%的最佳验证准确率,显著验证了该数据集在Musnad字母分类任务中的有效性与可用性。
使用方法
本数据集适用于多种计算机视觉与文化遗产人工智能研究场景。用户可直接将其加载为图像分类任务的标准训练与验证集,其中训练样本25600张,验证样本6400张。推荐采用卷积神经网络(CNN)作为基线模型,亦可探索注意力机制或轻量级架构以适配低资源环境。该数据集特别适合Musnad光学字符识别(OCR)系统的开发与评测,可用于古代铭文数字化、文字破译与文化传承等前沿领域。使用时需注意,数据集为合成生成,如需处理真实石刻图像,建议结合域适应或微调策略进一步优化模型性能。
背景与挑战
背景概述
古文字识别是计算语言学与文化遗产数字化交叉领域的前沿课题,其中古代南阿拉伯字母(Musnad文字)作为也门地区公元前10世纪至公元6世纪使用的书写系统,其自动识别技术对于历史文献的数字化保护至关重要。musnad-letter-classification数据集由也门研究机构于2023年创建,旨在为这一低资源文字系统构建首个基准分类数据集。该数据集包含32个Musnad字母类别,每类1000张合成图像,总计32000张96×96像素的灰度PNG图片。通过采用Noto Sans Old South Arabian字体渲染Unicode字符,并施加旋转、平移、高斯模糊及噪声注入等数据增强手段,该数据集为后续OCR研究和图像分类模型提供了标准化训练与评估依据。基线CNN模型达到99.84%的验证准确率,显著推动了古代南阿拉伯字母识别研究的发展。
当前挑战
该数据集所解决的领域核心挑战在于如何克服古代南阿拉伯文字的资源匮乏问题——现存石刻铭文数量有限且分布分散,难以支撑深度学习模型对32个字母变体的充分学习。具体挑战包括:1) 真实铭文受雕刻技术、石材纹理和千年风化影响,呈现极大的视觉可变性,而合成数据仅模拟理想字体渲染效果,未能涵盖真实考古场景中的裂纹、光照不均、局部缺失等复杂噪声;2) 构建过程中单一字体源(Noto Sans Old South Arabian)的运用限制了笔画风格多样性,且旋转、模糊等增广手段难以还原石雕的立体表面反射和深度变化;3) 数据集缺少对同一字母在不同铭刻时期、不同地理区域的字形变异建模,可能导致模型在真实铭文上泛化能力不足。
常用场景
经典使用场景
Musnad文字分类数据集(musnad-letter-classification)专为古南阿拉伯文字——也门穆什纳德字母的智能识别而设计。该数据集包含32个字母类别,每类提供1000幅96×96像素的灰度图像,总计32000幅合成图像,为图像分类任务提供了标准化的训练与评估基准。其经典使用场景聚焦于穆什纳德文字的OCR识别研究,研究人员可基于该数据集训练深度学习模型,实现对手写或雕刻形态的古文字进行高精度分类,尤其适用于低资源语种的文化遗产数字化保护领域。
解决学术问题
该数据集有效应对了古文字识别研究中标注数据匮乏的核心挑战,通过系统化的合成生成策略,为穆什纳德文字提供了首个大规模、类别均衡的基准数据集。在学术层面,它推动了古代闪米特文字支系的自动解读研究,解决了传统考古学依赖人工专家进行文字辨识的效率与可扩展性瓶颈。基线CNN模型取得的99.84%验证准确率,证明了合成数据在古文字分类任务中的可行性与潜力,为后续研究者探索更鲁棒的算法、迁移学习策略以及跨字体泛化能力奠定了数据基础。
衍生相关工作
该数据集衍生出一系列古文字识别与文化遗产智能处理的相关工作。在方法论上,研究者以其为基准评估了数据增强、风格迁移和域适应等技术对合成数据泛化到真实石器铭文的改进效果。在应用层面,催生了针对南阿拉伯古文字的端到端OCR系统设计、基于注意力机制的序列识别模型,以及结合考古学知识的跨领域预训练方法。这些成果共同推动了低资源古文字从合成环境到真实考古场景的迁移研究,形成了以穆什纳德为起点的古文字数字人文研究生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

