
遇见数据集

divyaswamy/fashionpedia_subset

收藏
Hugging Face2025-10-17 更新2025-10-25 收录
官方服务:

资源简介:

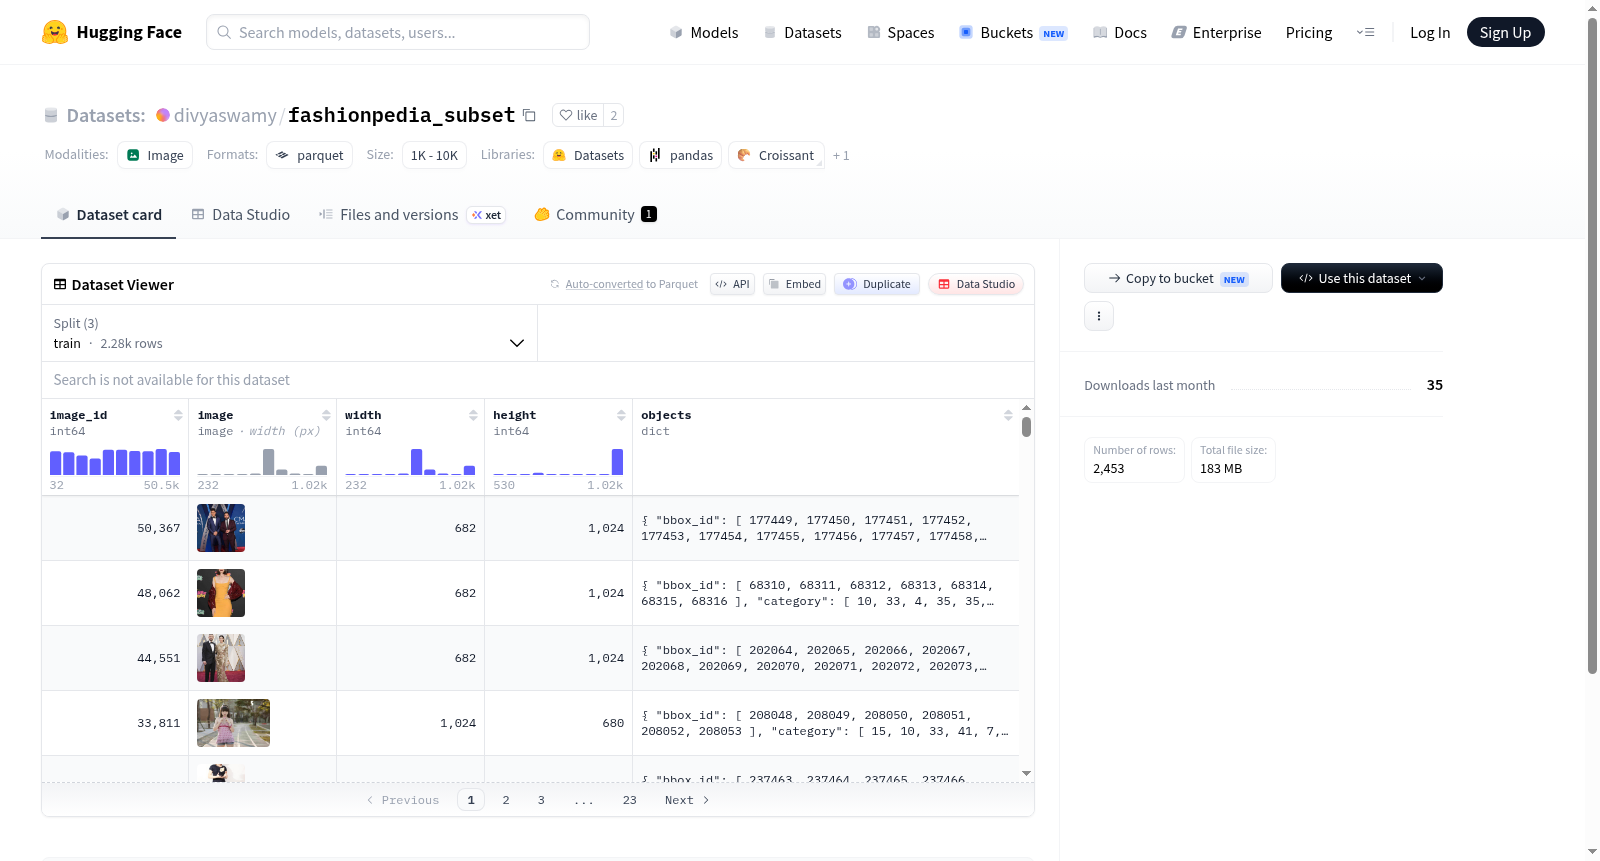
该数据集包含图片及其相关信息,如图片ID、图片宽度、高度以及图片中的对象信息(包括对象类别、边界框坐标、对象区域等)。对象类别包括衬衫、上衣、毛衣、开衫、夹克、背心、裤子、短裤、裙子、外套、连衣裙、连体衣、披肩、眼镜、帽子、发带、领带、手套、手表、腰带、腿套、紧身裤、袜子、鞋子、包、围巾、雨伞、兜帽、衣领、翻领、肩章、袖子、口袋、领口、搭扣、拉链、贴花、珠子、蝴蝶结、花、流苏、丝带、铆钉、褶边、亮片、流苏。

The dataset consists of images and their associated information such as image ID, image width, height, and information about objects in the images (including object categories, bounding box coordinates, and object areas). Object categories include shirt, blouse, top, t-shirt, sweatshirt, sweater, cardigan, jacket, vest, pants, shorts, skirt, coat, dress, jumpsuit, cape, glasses, hat, headband, head covering, hair accessory, tie, glove, watch, belt, leg warmer, tights, stockings, sock, shoe, bag, wallet, scarf, umbrella, hood, collar, lapel, epaulette, sleeve, pocket, neckline, buckle, zipper, applique, bead, bow, flower, fringe, ribbon, rivet, ruffle, sequin, tassel.
提供机构:
divyaswamy
搜集汇总
数据集介绍
divyaswamy/fashionpedia_subset 数据集图片
构建方式
在时尚与计算机视觉交叉领域,精准的细粒度图像解析对于智能服装识别与推荐至关重要。该数据集源自Fashionpedia的精选子集,旨在为服饰属性检测提供高质量标注。构建时,从原始数据中筛选出包含丰富服装类别与配件信息的图像,每张图像均经过人工标注,涵盖46个细粒度类别,如衬衫、夹克、裙子等基础服饰,以及领口、袖口、纽扣等局部属性。数据集以结构化格式存储,包含图像ID、尺寸、边界框坐标、面积及对应类别标签,并划分为训练集(2281张)、测试集(115张)和验证集(57张),确保模型评估的可靠性。
使用方法
使用该数据集时,可通过HuggingFace Datasets库直接加载,调用`load_dataset('divyaswamy/fashionpedia_subset')`即可获取预分割的训练、测试与验证集。数据以字典形式返回,包含图像张量、元数据及对象列表,其中边界框以[x_min, y_min, width, height]格式提供。研究人员可基于此构建目标检测模型,例如使用Faster R-CNN或DETR进行服饰与属性定位,亦可提取类别标签进行图像分类。建议在训练前将图像归一化至统一尺寸,并利用`torchvision.transforms`增强数据多样性,以提升模型泛化能力。
背景与挑战
背景概述
在计算机视觉与时尚产业的交叉领域中,细粒度服饰解析一直是极具挑战性的研究方向。Fashionpedia 数据集由 divyaswamy 团队构建,旨在弥补现有数据集在服饰部件级标注上的不足,其子集版本进一步优化了数据规模与标注粒度。该数据集创建于深度学习技术蓬勃发展的时期,核心研究问题聚焦于如何实现从服饰整体分类到部件级语义分割的精细化理解,涵盖 46 个细粒度类别(如衬衫、领口、拉链等)。通过提供 2281 张训练图像及对应的边界框与属性标注,Fashionpedia 子集为时尚图像检索、虚拟试衣及智能推荐系统提供了关键基准,显著推动了领域内从粗粒度识别向细粒度解析的范式转变。
当前挑战
该数据集面临的核心挑战体现在领域问题与构建过程两个层面。在领域问题方面,服饰部件的高度相似性与遮挡现象(如袖口与领口的形状重叠)导致模型难以准确区分细粒度类别,同时光照、姿态及纹理的多样性加剧了跨域泛化的难度。在构建过程中,标注人员需在密集的服饰区域中精确勾画 46 类部件边界框,这要求极高的专业性与一致性,而部件间语义歧义(如“hood”与“collar”的边界模糊)进一步增加了标注噪声。此外,数据集的规模有限(仅 2281 张训练样本),难以覆盖真实场景中的极端姿态与罕见部件组合,对模型在小样本条件下的鲁棒性提出了严峻考验。
常用场景
经典使用场景
Fashionpedia子集作为细粒度时尚图像理解领域的标杆数据集,其经典使用场景聚焦于多层级服饰属性解析。研究者可借助该数据集对图像中的服装单品进行双重维度的标注:既识别出衣物整体类别(如衬衫、夹克、连衣裙等28种基础品类),又精确检测袖口、领型、纽扣、褶皱等46种局部属性的边界框与语义标签。这种从宏观单品到微观细节的立体化标注体系,使得模型能够同时完成目标检测、属性分割与部件定位等复合任务,成为训练高精度时尚智能分析系统的理想数据基石。
解决学术问题
该数据集的核心学术贡献在于突破了传统时尚数据集仅关注服装分类或简单属性预测的局限,系统性地解决了服饰图像中结构化知识抽取的难题。通过提供涵盖品类标签与部件边界框的联合标注,Fashionpedia子集使研究者能够深入探究服装部件间的空间拓扑关系与语义关联,有效推动了细粒度视觉理解、多任务联合学习以及弱监督部件定位等前沿方向的发展。其影响在于为时尚领域的计算机视觉研究树立了更精细的评估基准,催生了一系列旨在提升模型对服饰结构认知能力的创新方法。
实际应用
在实际应用层面,Fashionpedia子集为智能时尚产业注入了强大的技术驱动力。基于该数据集训练的模型可部署于电商平台的智能检索系统,实现用户上传穿搭照片后的精准单品识别与相似款式推荐;在虚拟试衣场景中,模型对领型、袖长等细节属性的精准感知能力,能够支撑更加逼真的服装替换与个性化搭配建议生成。此外,该数据集还可赋能时尚设计辅助工具,自动解析秀场图片中的设计元素并生成结构化的款式描述,大幅提升设计灵感搜集与趋势分析的效率。
数据集最近研究
最新研究方向
在时尚与计算机视觉交叉领域,Fashionpedia子集凭借其精细的服装属性标注体系,正推动细粒度时尚理解的前沿探索。该数据集不仅涵盖46类衣物主体与部件类别,更将边界框、面积等几何信息与类别标签深度融合,为多模态时尚检索、虚拟试衣与智能穿搭推荐提供了高精度训练基准。当前研究热点聚焦于利用该数据集训练能够同时识别服装整体款式与局部细节(如领型、袖口、装饰元素)的深度学习模型,从而弥合图像语义与时尚专业术语之间的鸿沟。随着生成式AI与电商场景的深度融合,Fashionpedia子集已成为评估模型在复杂遮挡、大尺度变化及类间相似性条件下鲁棒性的关键测试床,其影响力正从学术基准向工业级时尚分析系统延伸。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

