
遇见数据集

amalia-llm/PT-Culture_Data

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

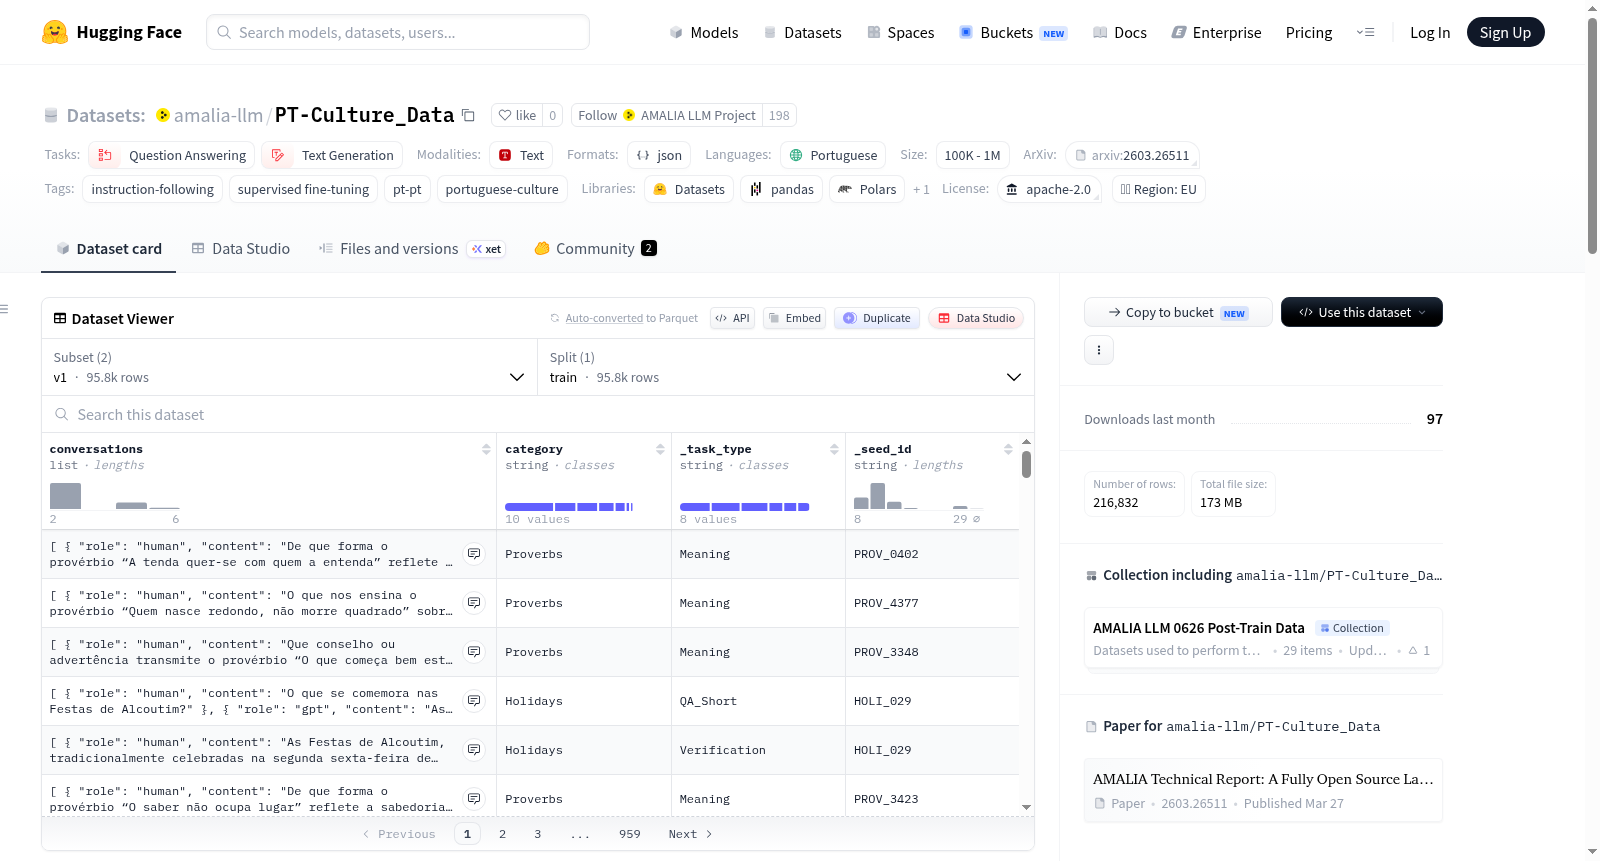
葡萄牙文化监督微调数据集是一个用于欧洲葡萄牙语(PT-PT)文化知识的监督微调数据集,旨在教导模型葡萄牙文化的传统、人物、地点和表达方式。该数据集包含两个版本,共计216,832个示例,以对话式监督微调格式组织,涵盖十个文化领域:人物、视听、遗产、体育、地理、文学、美食、谚语、节日和假日。数据涵盖七种任务类型:验证、短问答和长问答、文化背景推理、实体比较、多轮对话(角色多样化)以及谚语含义解释。提供两个文件:culture_data_sft.jsonl(v1)和culture_data_sft_v2.jsonl(v2)。如需使用全部数据,建议合并两个文件。该数据集是AMALIA项目的一部分,用于后训练AMALIA模型。

A supervised fine-tuning dataset for European Portuguese (PT-PT) cultural knowledge, built to teach models the traditions, figures, places, and expressions of Portuguese culture. The dataset contains 216,832 examples across two versions in conversational SFT format, organised into ten cultural domains: Personalities, Audiovisual, Heritage, Sports, Geography, Literature, Gastronomy, Proverbs, Festivals, and Holidays. The data spans seven task types: Verification, short and long question-answering, cultural-context reasoning, entity comparison, multi-turn dialogue (persona-diversified) and proverb meaning explanation. Two files are available: culture_data_sft.jsonl (v1) and culture_data_sft_v2.jsonl (v2). For training on all data, use both files combined. This dataset is provided as part of the AMALIA project and is included in the data mix used to post-train the AMALIA model.
提供机构:
amalia-llm
搜集汇总
数据集介绍
amalia-llm/PT-Culture_Data 数据集图片
构建方式
Portuguese Cultural SFT Dataset(PT-Culture_Data)是一个面向欧洲葡萄牙语文化知识的监督微调数据集,由AMALIA项目团队构建。数据集以对话式SFT格式组织,涵盖216,832个样本,分为v1与v2两个版本,分别存储于culture_data_sft.jsonl和culture_data_sft_v2.jsonl文件中。其构建过程围绕十大文化领域展开,包括人物、视听、遗产、体育、地理、文学、美食、谚语、节庆与节假日,通过多样化的任务类型如验证、短问答、长问答、文化语境推理、实体比较、多角色对话及谚语释义,生成结构化的指令-回答对,以模拟真实的文化知识交互场景。
特点
该数据集的核心特点在于其精细的领域分层与任务多样性。它系统地覆盖了葡萄牙文化的十个关键维度,其中人物领域占比最高(99,158条),而谚语与节庆等特色主题亦被纳入,体现了对文化深度的追求。数据集支持七类任务,从简单的真伪验证到复杂的多轮对话,不仅增强了模型对文化事实的记忆能力,还锻炼了其在语境中推理与比较的灵活性。v1与v2版本在领域分布上存在差异,例如v2新增大量体育类数据且移除了谚语,这种设计允许研究者根据需要对领域权重进行灵活调整,提升了数据集的实用性与可扩展性。
使用方法
使用PT-Culture_Data时,用户可直接加载两个JSONL文件进行训练:将culture_data_sft.jsonl与culture_data_sft_v2.jsonl合并使用,以获取全部216,832个样本。数据集遵循Apache-2.0许可协议,并已集成至HuggingFace平台,通过配置名v1与v2分别访问不同版本。在微调流程中,推荐将其作为监督微调阶段的补充数据,与通用语料结合以强化模型对欧洲葡萄牙语文化知识的掌握。此外,该数据集已被用于AMALIA模型的后训练,相关引用信息可在其配套论文中找到,便于学术研究中的规范引用与复现。
背景与挑战
背景概述
PT-Culture_Data是由AMALIA项目团队于2026年构建的葡萄牙语文化监督微调数据集,主要研究人员来自欧洲多家机构,如NOVA LINCS和Instituto de Telecomunicações等。该数据集聚焦于欧洲葡萄牙语(PT-PT)文化知识的习得,涵盖人物、影视、遗产、体育、地理、文学、美食、谚语、节庆和假日十大领域,共包含216,832个对话示例。其核心研究问题在于提升大语言模型对特定文化背景的理解与生成能力,弥补当前主流模型在葡萄牙语文化知识方面的不足。该数据集在PROPOR 2026会议上发表,并作为AMALIA模型后训练的关键组成部分,对低资源语言的文化AI发展具有重要推动作用。
当前挑战
该数据集所解决的领域挑战是主流语言模型在葡萄牙语文化知识上的显著缺失,尤其是欧洲葡萄牙语(PT-PT)特有的传统、人物与表达方式难以被通用模型准确捕捉。构建过程中面临的挑战包括:需从十个文化领域手动收集并验证高质量、多样化的知识来源;设计七种任务类型(如验证、短问答、长问答、文化推理、实体比较、多轮对话及谚语解释)以覆盖文化知识的复杂维度;确保数据在口语风格、方言特征与文化细节上的真实性;以及平衡各领域与版本间的样本分布,避免数据偏差影响模型训练效果。
常用场景
经典使用场景
在自然语言处理与文化计算的交叉领域中,PT-Culture_Data最经典的用途是对大型语言模型进行欧洲葡萄牙语(PT-PT)文化知识的监督微调。该数据集以对话式SFT格式精心构建,涵盖216,832条高质量样本,横跨人物、视听、遗产、体育、地理、文学、美食、谚语、节庆与假期十大文化领域。研究者常将其用于模型的后训练阶段,通过验证、问答、推理、比较与多轮对话等七种任务类型,系统性地注入葡萄牙特有的文化内涵,从而显著提升模型在跨文化场景下的语言理解与生成能力。
解决学术问题
该数据集有效回应了大规模语言模型在低资源语种文化适应性上的关键学术挑战。现有的多语言模型多集中于英语数据,对葡萄牙语尤其是欧洲葡语的文化细节覆盖严重不足,导致模型在处理本土化表达、历史典故、地域常识及传统谚语时表现欠佳。PT-Culture_Data通过精细化的领域划分与任务设计,为学术界提供了一套可复现、可扩展的文化知识优化基准。它揭示了文化遗忘与语言模型之间的深层关联,并推动了面向特定文化圈的语言模型对齐研究,其影响延伸至文化记忆保存、语言偏见缓解及多语种公平性评估等重要议题。
衍生相关工作
PT-Culture_Data是AMALIA开源大语言模型项目的核心数据基石之一,直接促成了AMALIA模型在欧洲葡萄牙语文化理解任务中的卓越表现。相关工作已在PROPOR 2026会议发表,并发布了详细技术报告,提供了完整的数据构建与模型微调评估流程。该数据集还催生了针对葡萄牙文化的自动化评估基准(AMALIA LM Eval),用于衡量模型在十大文化领域上的掌握程度。其开放的Apache-2.0许可协议与多样化的任务模板,也为后续研究如跨语言文化迁移学习、谚语嵌入表示分析、以及基于文化图谱的多轮对话系统提供了宝贵的公共资源与实验起点。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

